


KV Cache 是什么?为什么只缓存 K 和 V,不缓存 Q? 沉默王二 原创 AI 面试 AI Agent 面试题 KV Cache 自回归生成 注意力机制 约 1379 字 大约 5 分钟 AI的药,绝不能停 #046 面试官问你:“大模型推理里天天讲的 KV Cache 到底是什么?为什么只缓存 K 和 V,偏偏不把 Q 一起存下来?” AI Agent 面试题 KV Cache 自回归生成 注意力机制 WATCH / 抖音视频 在抖音打开 王二讲Agent 每天3分钟,带你吃透Agent。 如果你回答“因为 Q 比较大吧”或者“KV 是键值对,Q 不重要吧”,恭喜你,出门右拐回家等通知吧。 为什么? 因为大模型是自回归逐字生成的。每次生成新词,新产生的提问是 Q,所有已经处理过的词是 K 和 V。当前这轮算完,Q 就彻底作废了,但之前的 K 和 V,后面每一个新词生成时都还得翻一遍。
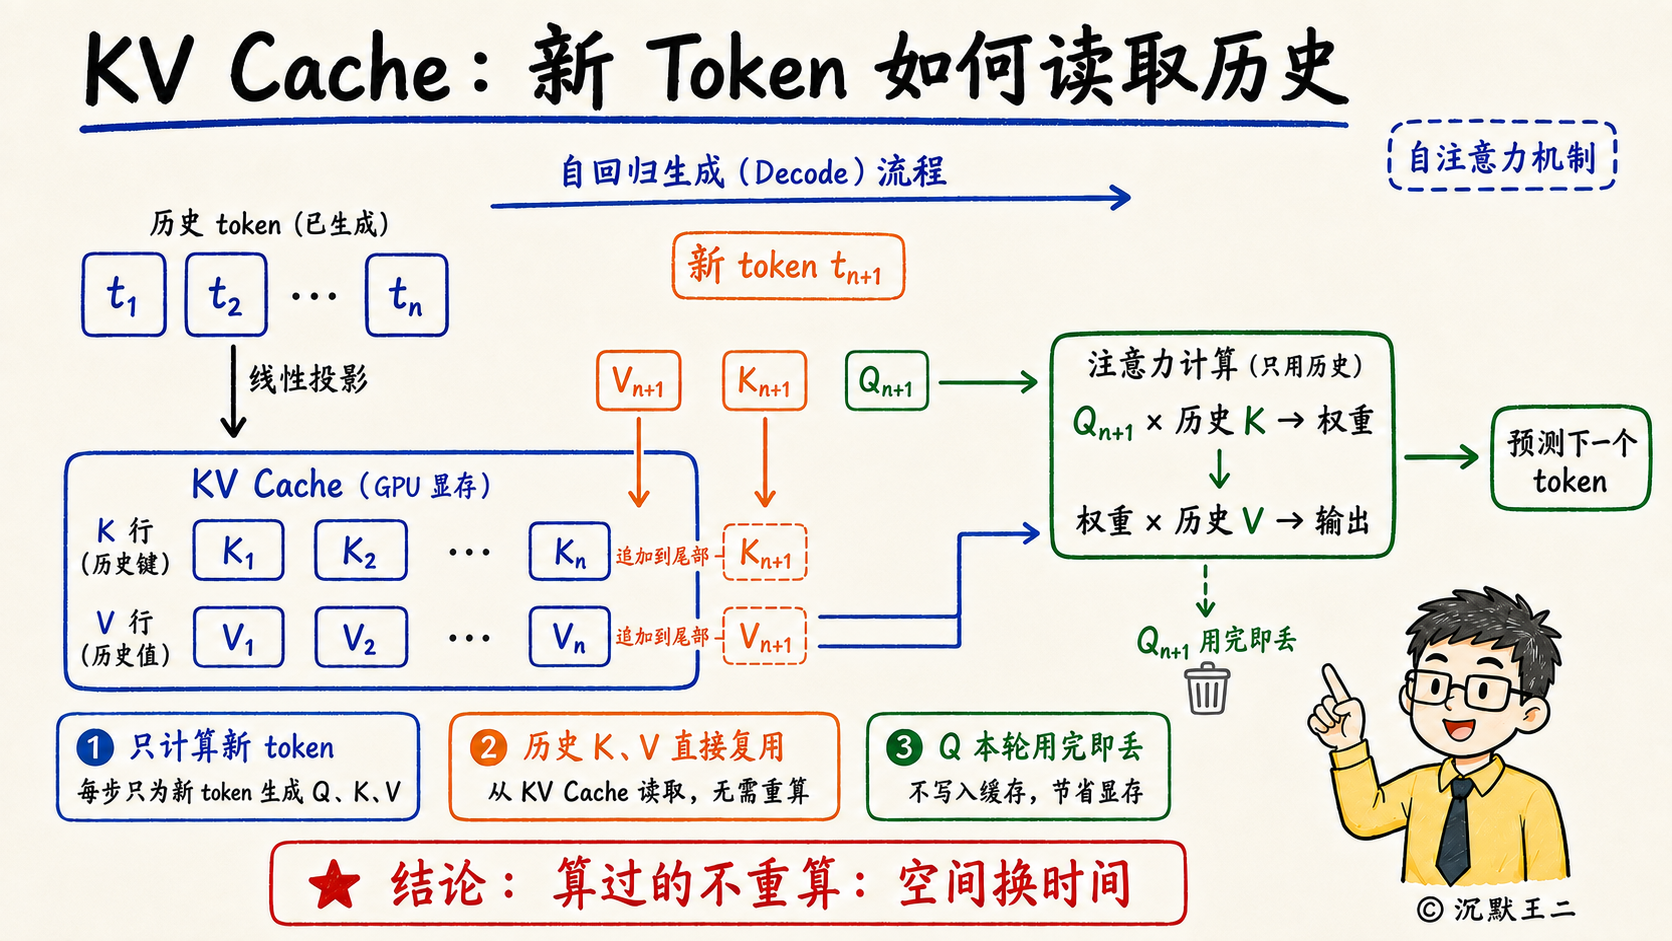
在这梳理了一份 AI Agent 开发学习路线和 288 道配套八股,需要的可以来个222。 我翻了 Transformer 的底层实现、vLLM 的推理优化源码,可以自信地、大方地、光明磊落地帮你搞清楚这三件事: 什么是 KV Cache?为什么没有它大模型推理会卡死? 为什么只存 K 和 V,偏偏不存 Q? 既然它这么好,各大模型为什么还要拼了命压缩它? 哈喽大家好,我是二哥呀。今天用 3 分钟,给你彻底讲透大模型推理的核心秘密——KV Cache。 先说第一件事, 什么是 KV Cache 。 大模型生成文本的过程叫“自回归”,说白了就是打字机模式,一个字一个字往外蹦。关键在于,每吐出一个新字,模型都必须回头看一遍前面所有已经生成的字,才能决定下一个字是什么。
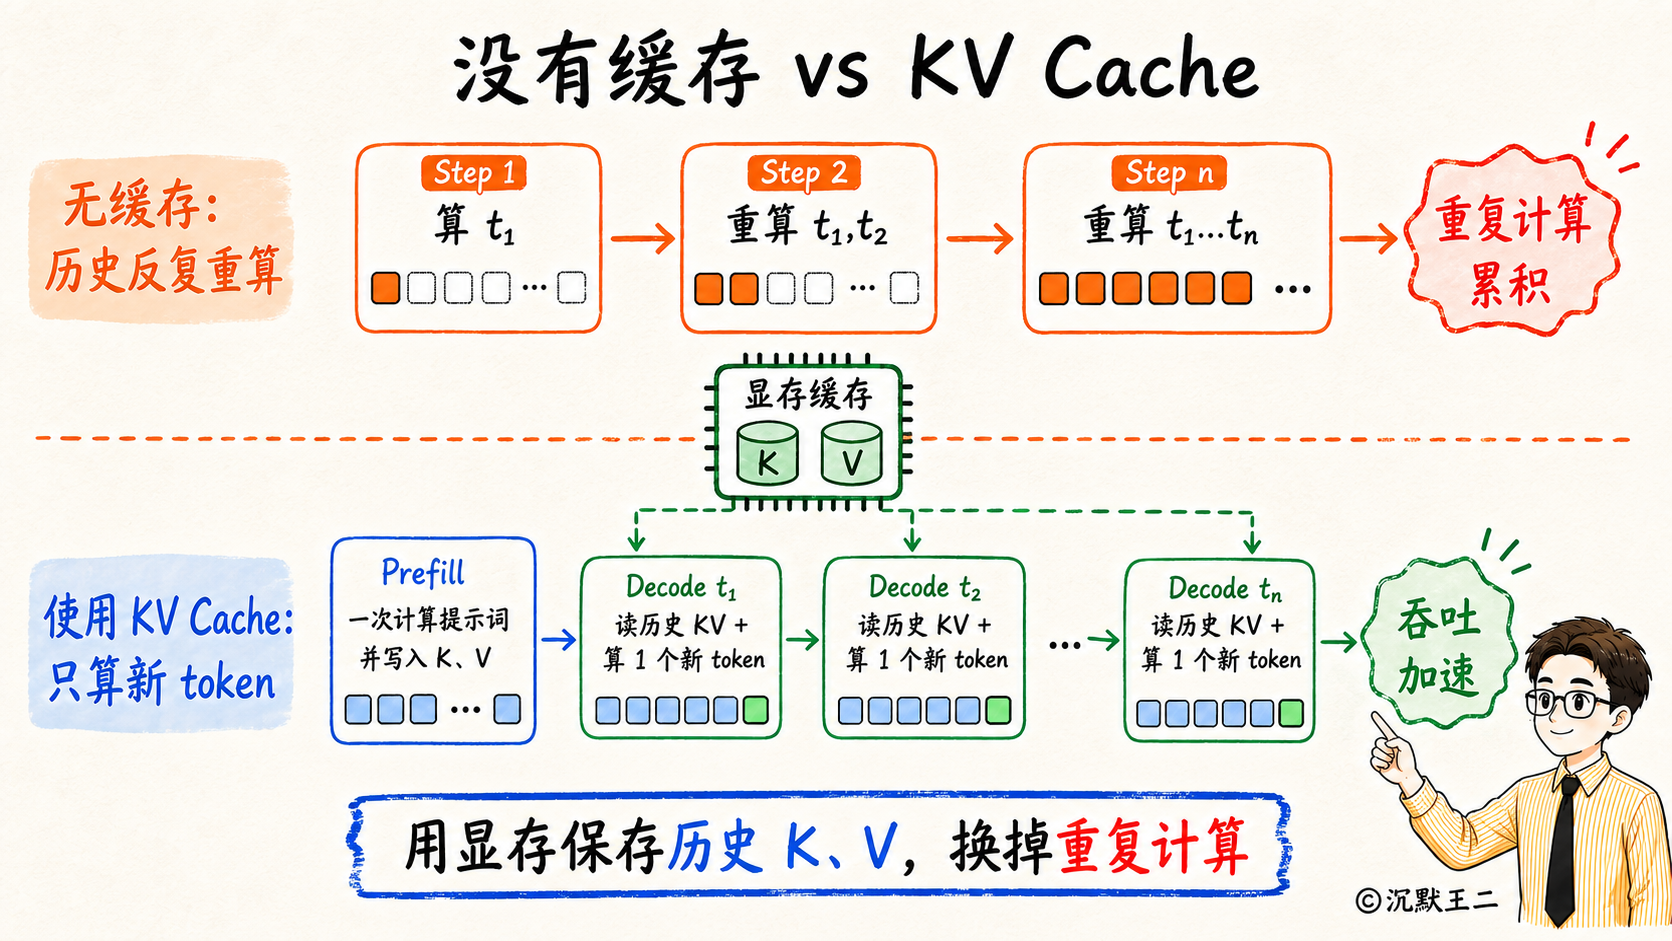
如果没有缓存,生成第 1 个字算 1 遍,生成第 2 个字要把前 2 个字重新算一遍,生成第 1000 个字就得把前 1000 个字从头到尾再算一遍。越往后越卡,算力全浪费在重复的历史计算上了。 KV Cache 的核心逻辑就是“算过的不重算,用空间换时间”。在第一次读完或者生成词元(Token)的时候,把前面所有词的中间计算结果存进 GPU 显存。之后每生成一个新词,直接从显存里读取旧结果,每次只算这一个新词。 那聪明的你肯定想到了: 既然要缓存,为什么叫 KV Cache?为什么不把 Q 也一起存了? 大模型注意力机制里,每个词元都会通过矩阵乘法算出三个向量:Q 代表 Query 提问,K 代表 Key 索引,V 代表 Value 真实内容。
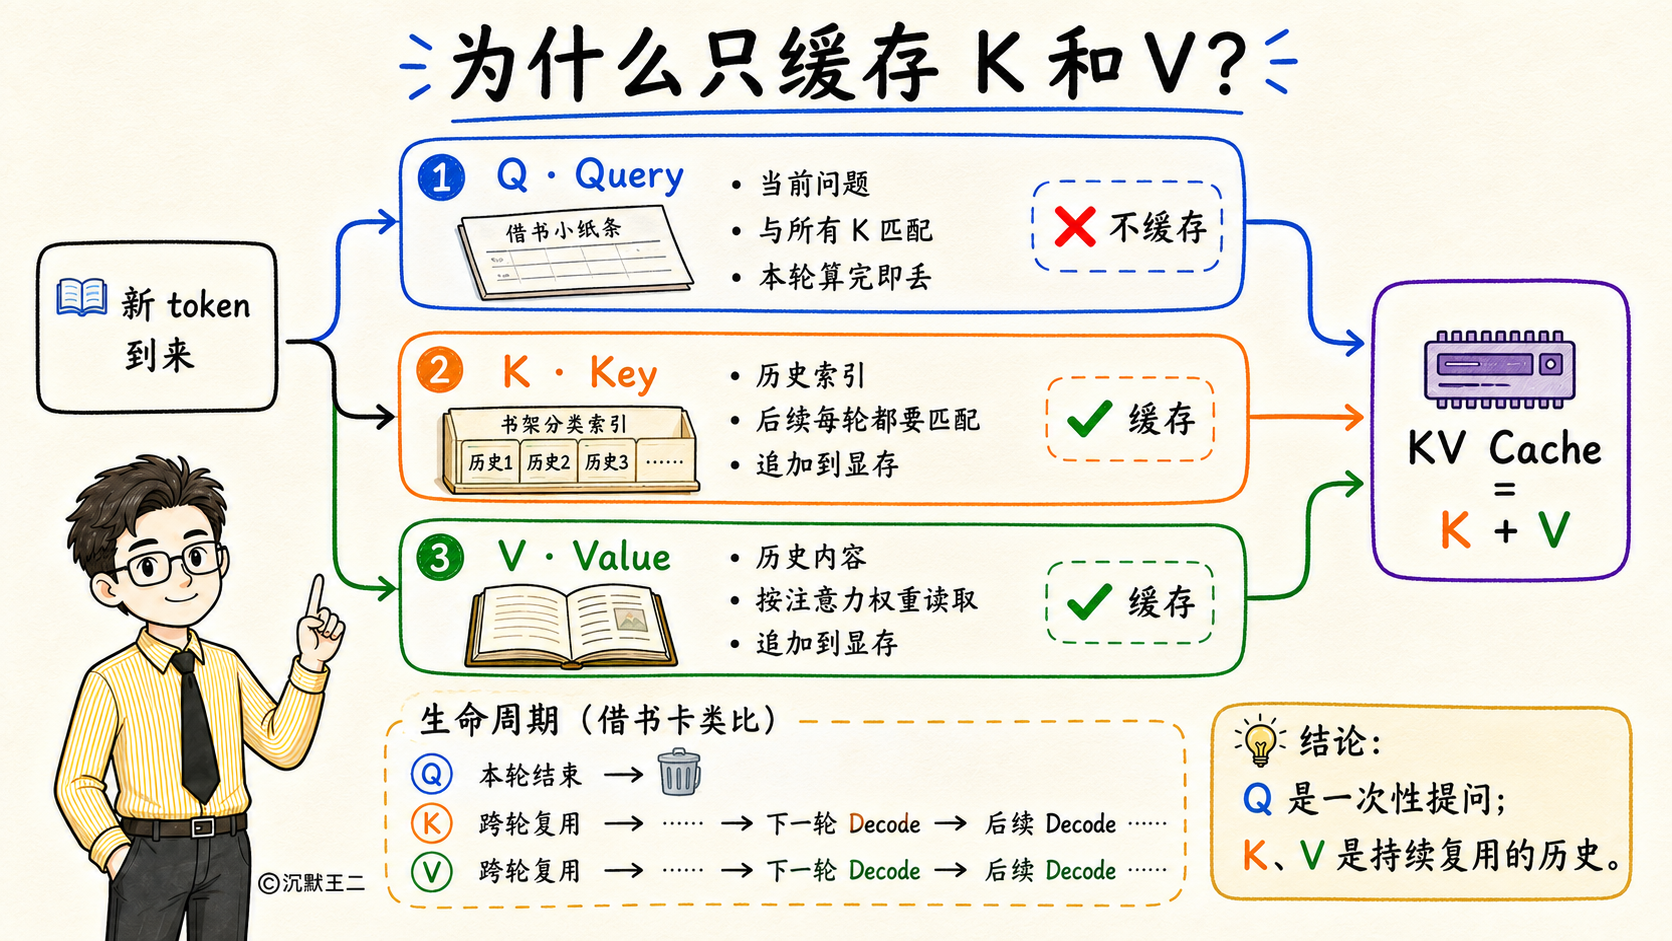
打个比方。你去图书馆借书,你的借书小纸条就是 Q,书架上贴的分类索引标签就是 K,书架上的具体书本内容就是 V。 当新生成一个字时,相当于拿着最新这张借书小纸条 Q,去跟书架上所有已经摆好的索引 K 对暗号,算出来的相关度就是注意力权重,算完之后直接去拿书本内容 V。 这一轮算完,借书小纸条 Q 的使命就彻底结束了,下一轮生成新字会有全新的一张小纸条,旧纸条留着毫无用处。但书架上的索引 K 和书本内容 V,不管后面生成第 10 个字还是第 100 个字,都得继续翻看。 所以,Q 是一次性筷子,用完就扔;K 和 V 才是长久保存在显存里的真金白银。 那聪明的你肯定又要问了: KV Cache 这么管用,各大厂商为什么还在拼命想办法压缩它? 因为它是一个可怕的“显存吞金兽”。 模型的权重参数大小是固定的,但 KV Cache 会随着上下文长度和并发用户数像滚雪球一样疯长。
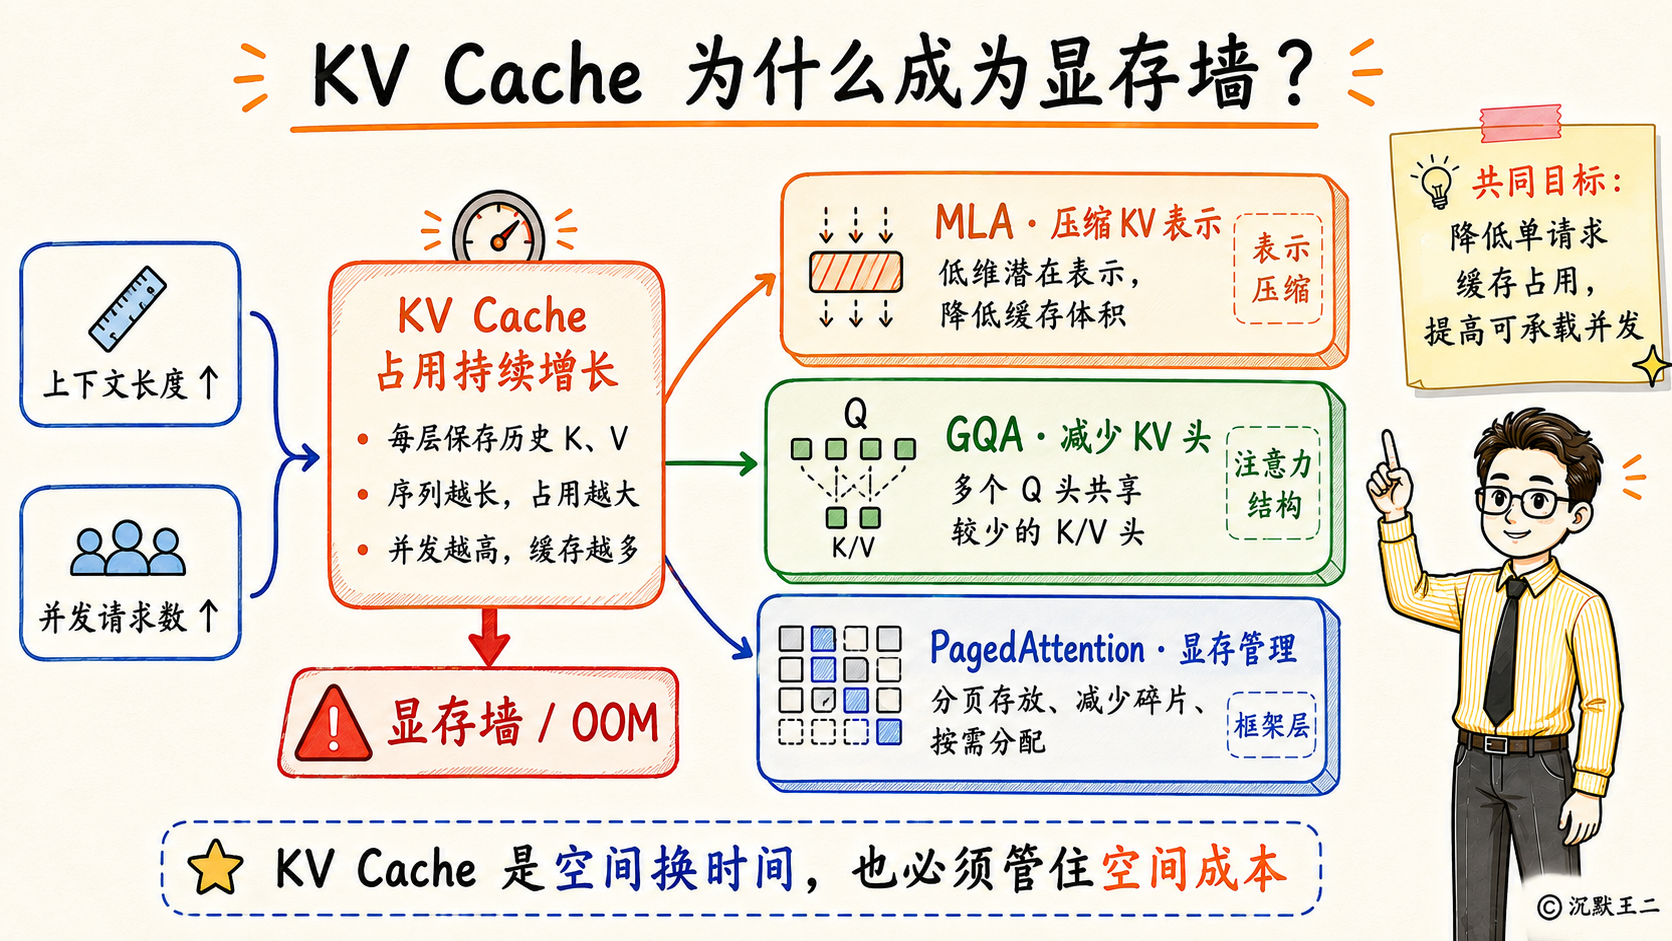
在长文本或者几十个人同时并发调用的场景下,KV Cache 吃掉的显存甚至会远远超过模型本身的权重。一张 80G 显存的高端 GPU,可能跑几个长文本并发就直接爆显存报错 OOM 了。这就撞上了业内常说的“显存墙”。 所以各家模型和推理框架都在疯狂做优化:vLLM 搞出 PagedAttention,像操作系统虚拟内存一样给显存分页;开源模型从 MHA 走向 GQA;DeepSeek 更是接连搞出 MLA 以及最新的 CSA 和 HCA,核心目标只有一个——把 KV Cache 压到极致,让单张显卡能扛住更多并发。 最后简单总结下。 KV Cache 是大模型用空间换时间的核心机制。Q 是一次性提问用完即扔,K 和 V 是历史索引与内容必须常驻显存。 另外给大家一条实用建议:调用大模型 API 时保持 Prompt 前缀稳定,能充分利用服务端的 Prefix Caching 命中 KV Cache,既能大幅降低延迟,还能省下大笔调用费用。 这个知识点你学废了吗?想解锁更多 AI 硬核知识,点赞关注,我是二哥,咱们下期见! 这个公众号历史发布过很多有趣的 Agent 知识点,如果你懒得翻文章一个个找,你直接关注微信公众号:二哥狗腿子 ,后台对话聊天就行了:
在 GitHub 上编辑此页 上次编辑于: 贡献者: 沉默王二 上一页 API 缓存命中 下一页 什么是 Prefix Caching