


Prefix Caching(前缀缓存)到底是什么? 沉默王二 原创 AI 面试 AI Agent 面试题 Prefix Caching 前缀缓存 Radix Tree 约 1516 字 大约 5 分钟 AI的药,绝不能停 #047 你在使用DeepSeek Harness的时候,有没有发现一个反直觉的现象: AI Agent 面试题 Prefix Caching 前缀缓存 Radix Tree WATCH / 抖音视频 在抖音打开 王二讲Agent 每天3分钟,带你吃透Agent。 对话历史明明越来越长,按理说模型要读的字越来越多,应该越来越慢、越来越贵才对;但实际上,后续对话的首字反而经常是秒出,而且账单里还总出现一行“缓存命中”,费用直接打两折甚至一折!
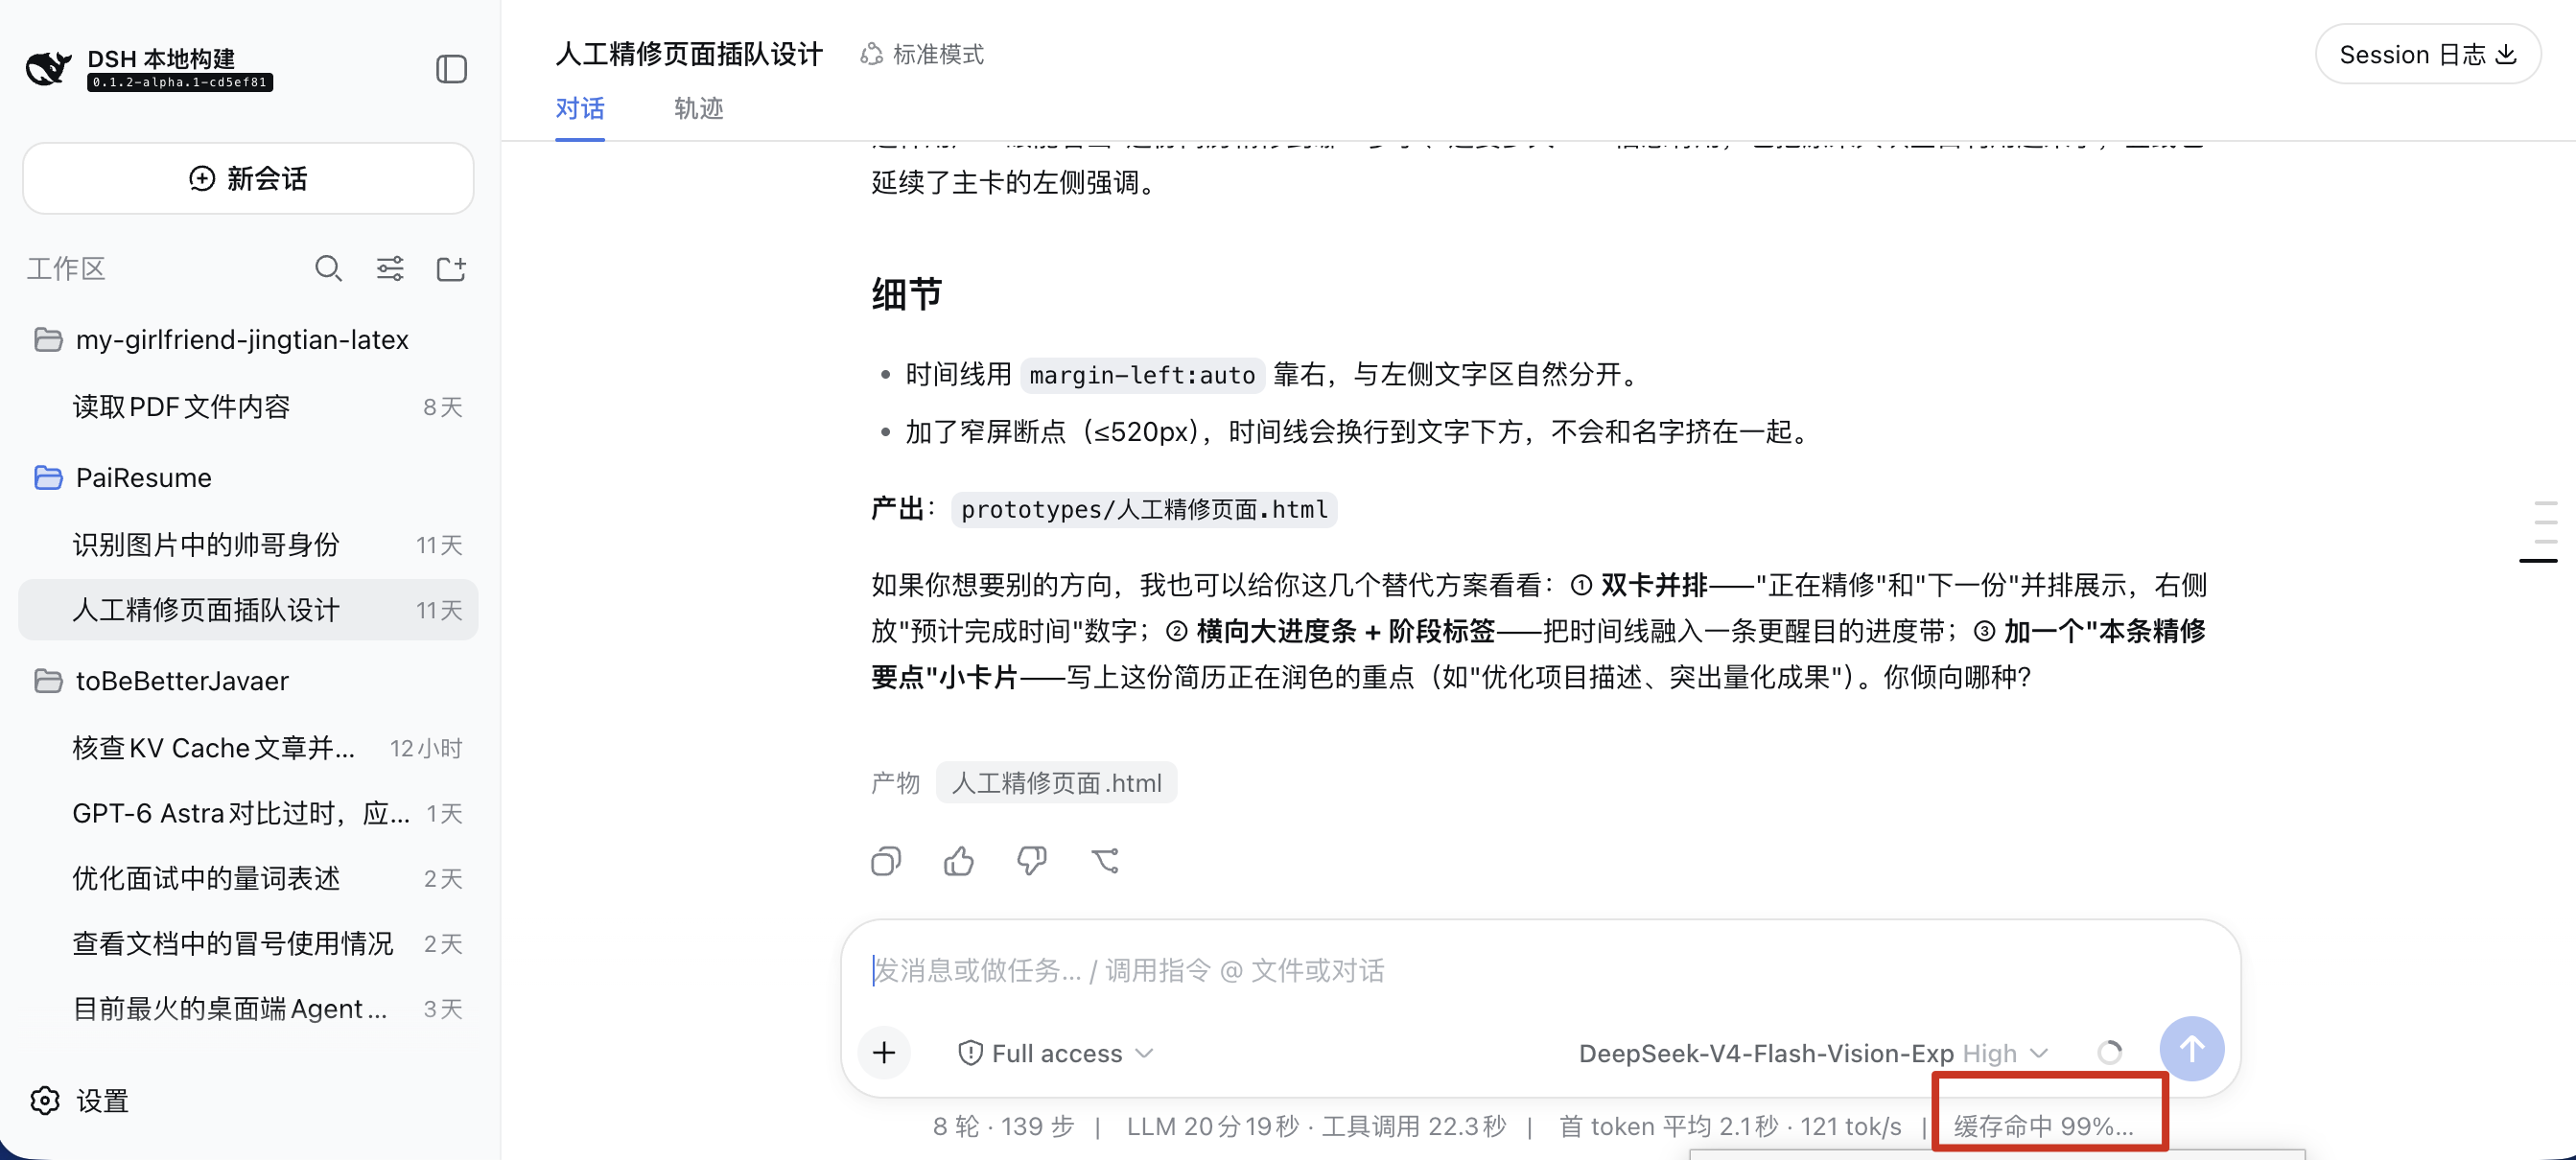
为什么长对话反而更便宜了? 秘密就在于:服务端用了 Prefix Caching(前缀缓存),把前面已经算好的 KV Cache 跨请求复用了。 面试官也特别喜欢拿这道题来压轴:“KV Cache 和 Prefix Caching 到底是什么关系?如果用户改了输入里的第一个字,前缀缓存会发生什么变化?” 如果你回答“那就只把后面没改的字缓存下来呗”,恭喜你,出门右拐回家等通知吧。 在这梳理了一份 AI Agent 开发学习路线和 288 道配套八股,需要的可以来个222。 为什么? 因为前缀缓存认的是从头开始的绝对匹配。开头的字一变,整条哈希链就断了,后面的内容哪怕一模一样,也会全盘失效!
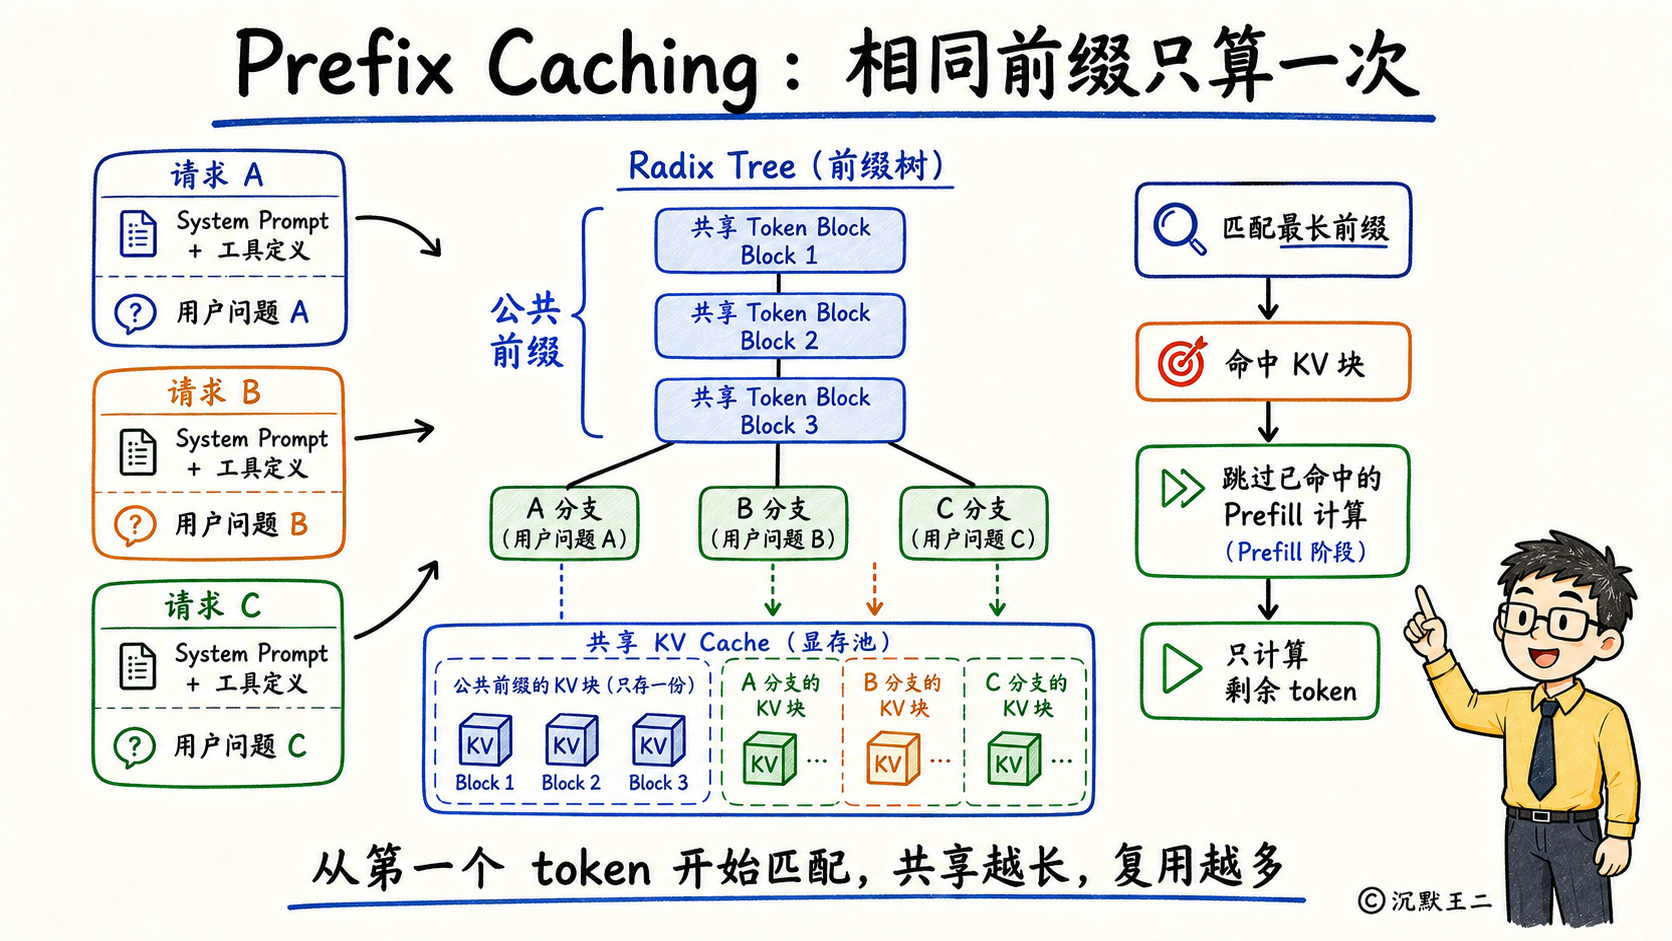
我翻了 vLLM 的自动前缀缓存实现、SGLang 的 RadixAttention 源码,以及各大模型厂商的 API 定价机制,可以自信地、大方地、光明磊落地帮你搞清楚这三件事: Prefix Caching 到底是什么?和上一期讲的 KV Cache 有什么本质区别? 推理引擎是怎么做到跨请求秒级复用缓存的? 为什么很多人的 Agent 跑起来永远命中不了缓存,白白多花冤枉钱? 哈喽大家好,我是二哥呀。今天用 3 分钟,给你彻底讲透大模型降本提速的神器——Prefix Caching,也就是前缀缓存。 先说第一件事, 什么是 Prefix Caching 。 上期讲过,KV Cache 是大模型为了避免重复计算记下的“显存笔记”。但在传统推理里,这份笔记是单次请求专用的,回答一结束,显存里的笔记立刻被清空。下一个请求哪怕有 90% 相同的内容,模型也得从头算一遍。
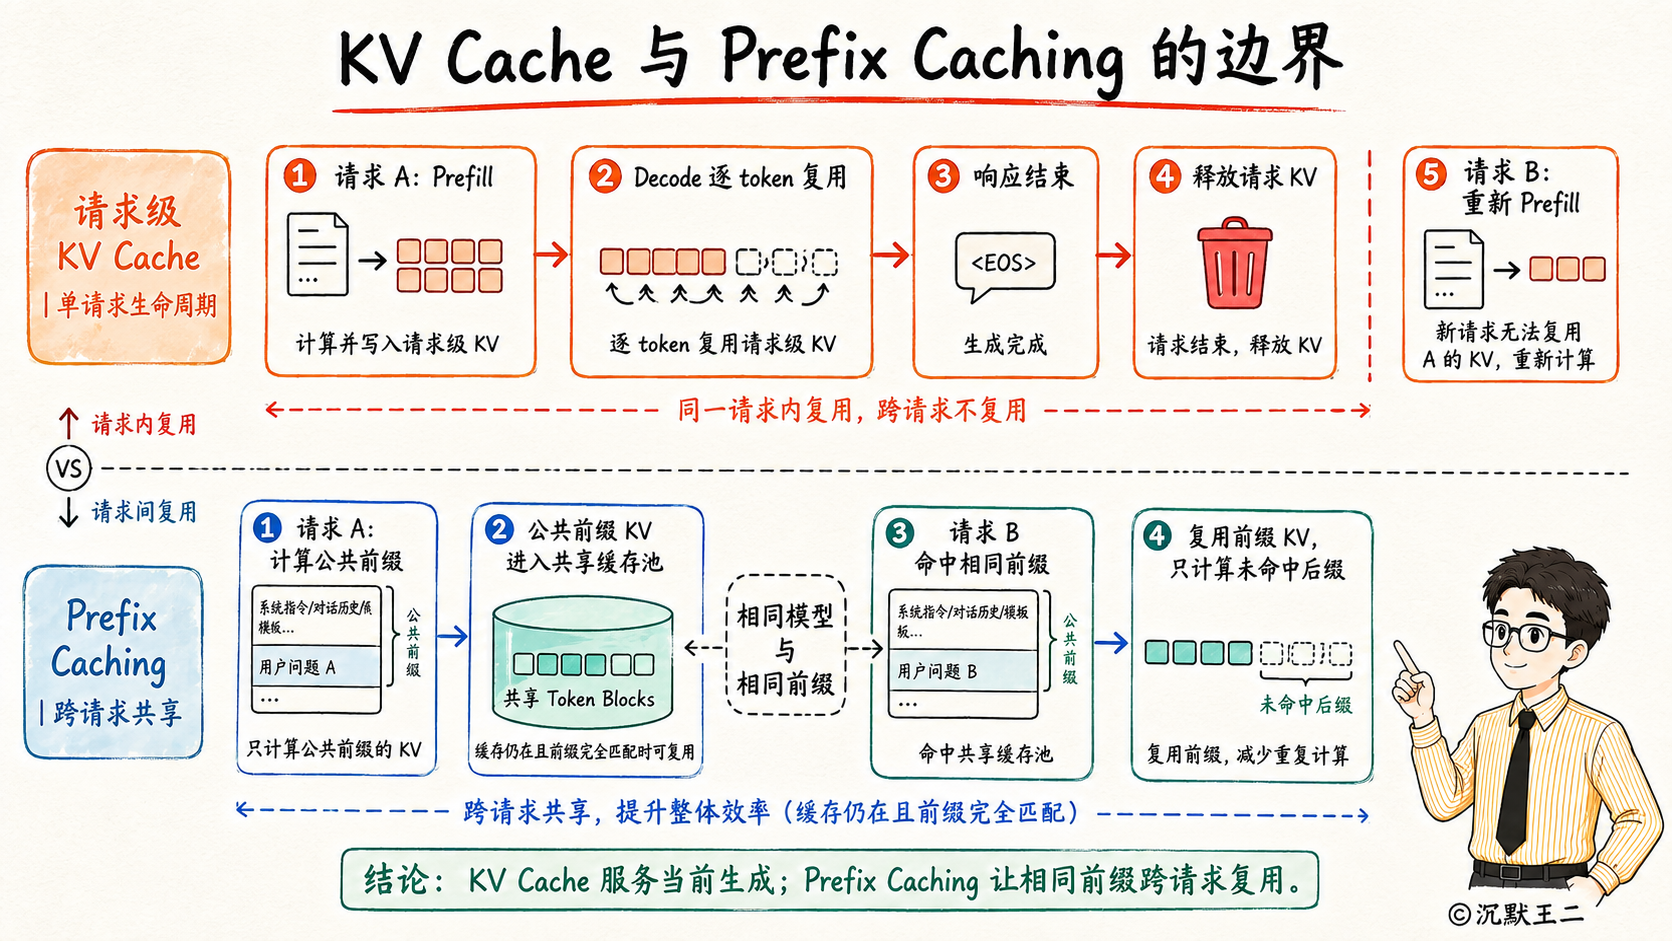
前缀缓存做了一件至关重要的事情:它打破了请求之间的物理隔离。 模型生成完回复后,只要显存没满,它不会直接扔掉这份笔记,而是把公共前缀对应的 KV 数据存进共享缓存池。 当下一个请求进来时,服务端一比对,发现“前面这两千个字我刚才算过了”,直接从显存里把 KV 提出来用,彻底跳过最消耗算力的 Prefill 预填充阶段。 这带来的提升是显著的。首字响应延迟能从几秒直接缩短到几十毫秒,API 费用普遍打两折甚至更低。各大厂商宣传的 Prompt Caching 降价,底层全靠前缀缓存。 那聪明的你肯定想到了: 面对成千上万个并发请求,服务端怎么在毫秒级内找到哪些前缀能复用? 靠的是分块管理与前缀树(Radix Tree)。 推理引擎把文本切成一个个固定大小的 Token 块,比如 16 个或 64 个 Token 为一块。每个块算出一个哈希值,在显存里组装成一棵巨大的树状索引。
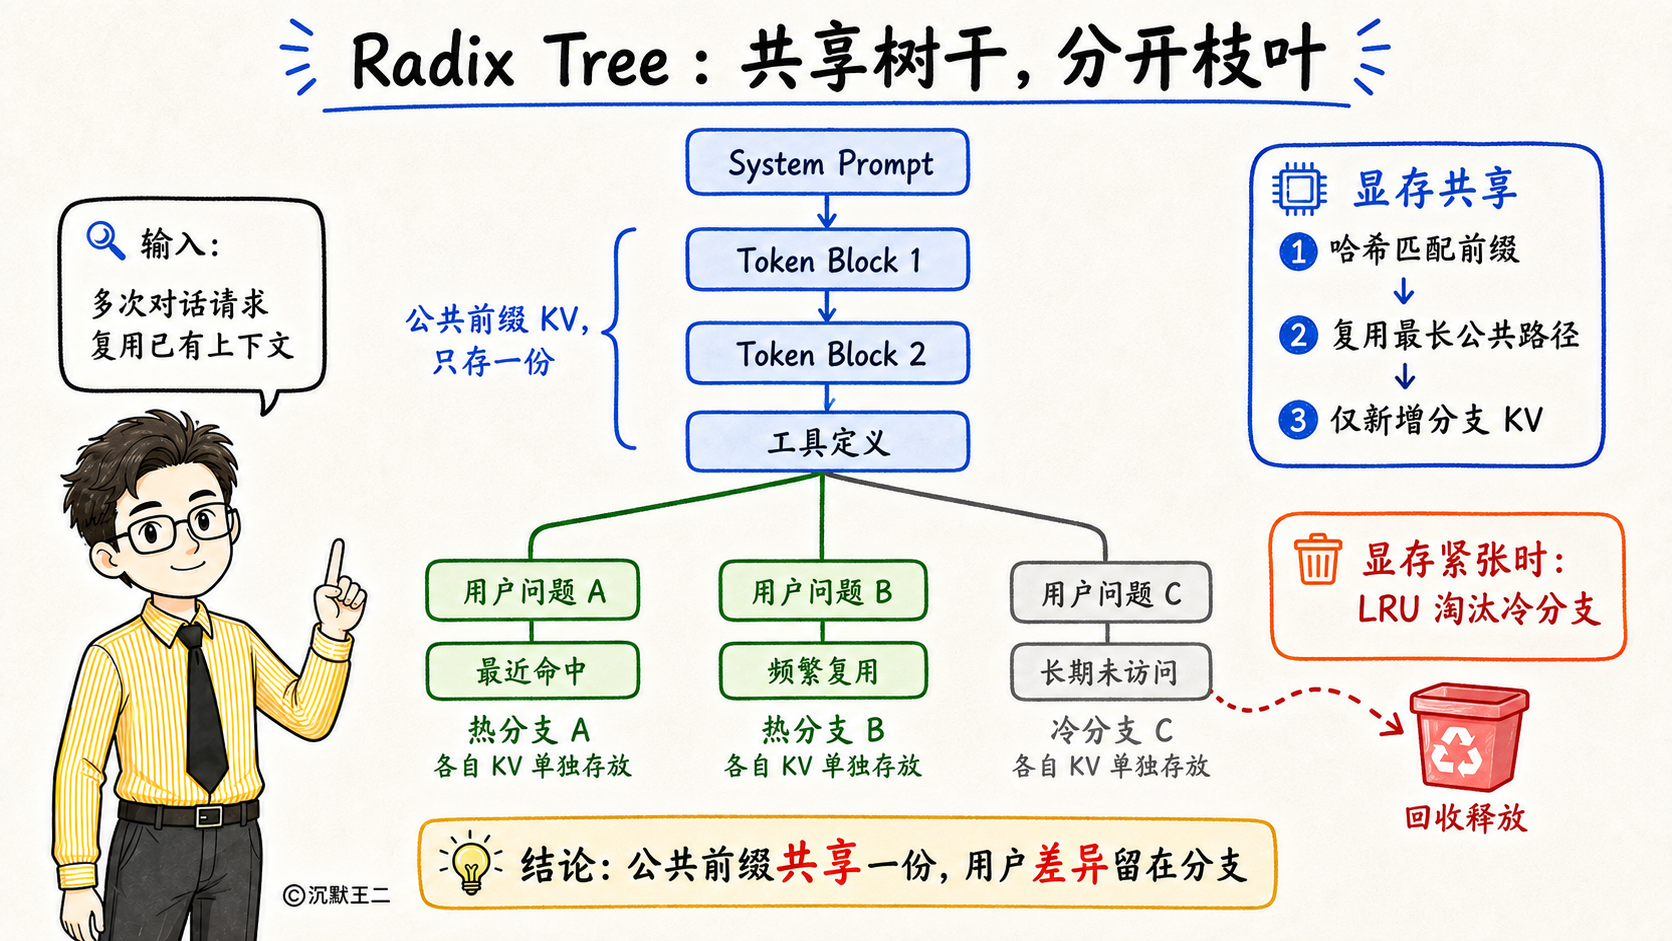
比如在企业级 Agent 场景下,100 个用户在用同一个知识库助手,这一万个 Token 的系统指令和工具定义,就是整棵树的主树干,显存里只算一次、存一份。100 个用户的提问,只是主树干上分出来的 100 根小枝条。 当显存紧张时,引擎按 LRU 策略淘汰最久没人用的冷门分支,把显存动态腾给热门前缀,既省显存,又把并发吞吐拉满。 那聪明的你肯定又要问了: 既然前缀缓存这么香,为什么我自己写的 Agent 跑起来账单居高不下,延迟一点没降? 因为你很可能踩中了最隐蔽的大坑,前缀污染。 前缀缓存的规则极度苛刻,必须是从第一个 Token 开始,一字不差地完全匹配。
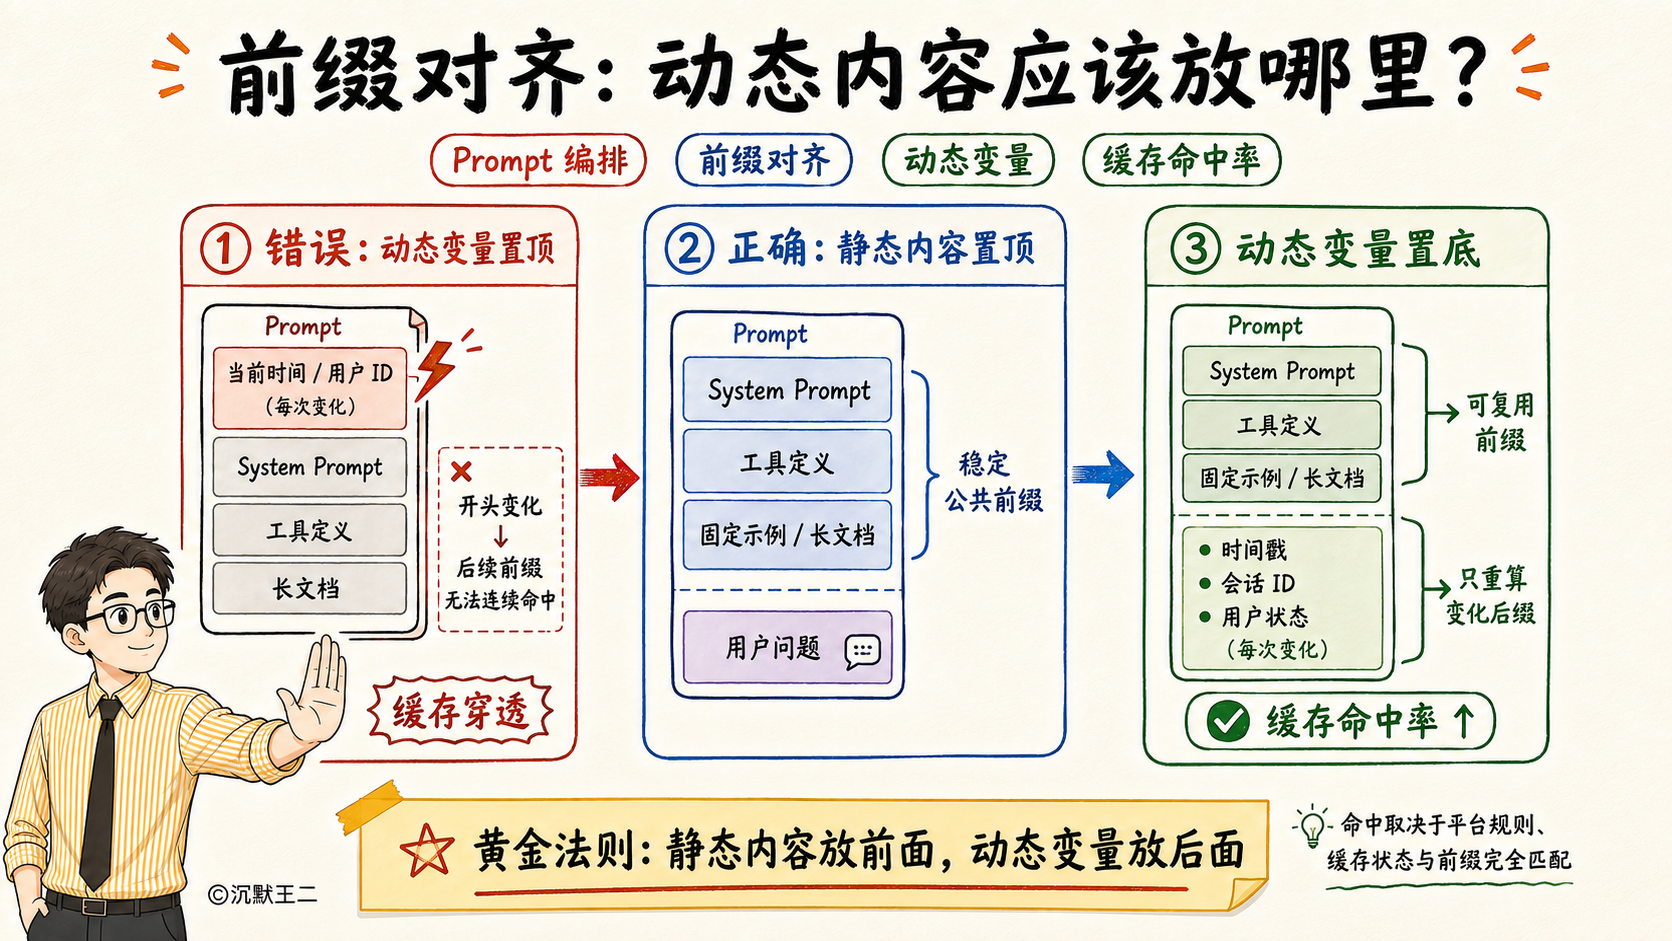
很多新手写 Prompt 时,喜欢在第一行加上“当前时间是 2026 年 9 月 5 日 10 点 27 分”,或者把动态生成的用户 ID 塞在最前面。 你以为只改了一小行字,但在模型的眼里,第一个字变了,整棵前缀树从根部直接断裂,后面哪怕跟着一万字相同的文档,也全部变成了“未命中”。 要想吃满前缀缓存红利,编排 Prompt 必须遵守一条黄金铁律:静态内容焊死在开头,动态变量老老实实挪到最后。 最后简单总结下。 普通的 KV Cache 负责单次请求内的自回归提速,而 Prefix Caching 负责跨请求、跨用户的批量复用,底层全靠 Token 分块与 Radix Tree 前缀树。 另外给你一条实用建议。检查你的 Agent 提示词模板,务必把时间戳、会话 ID、用户状态等高频变化的参数放在最后,千万别放在开头把整条缓存链给“毒死”了。 这个知识点你学废了吗?想解锁更多 AI 硬核知识,点赞关注,我是二哥,咱们下期见!
这个公众号历史发布过很多有趣的 Agent 知识点,如果你懒得翻文章一个个找,你直接关注微信公众号:二哥狗腿子 ,后台对话聊天就行了:
在 GitHub 上编辑此页 上次编辑于: 贡献者: 沉默王二 上一页 什么是 KV Cache 下一页 DeepSeek 与 Claude 的 Prompt Caching