


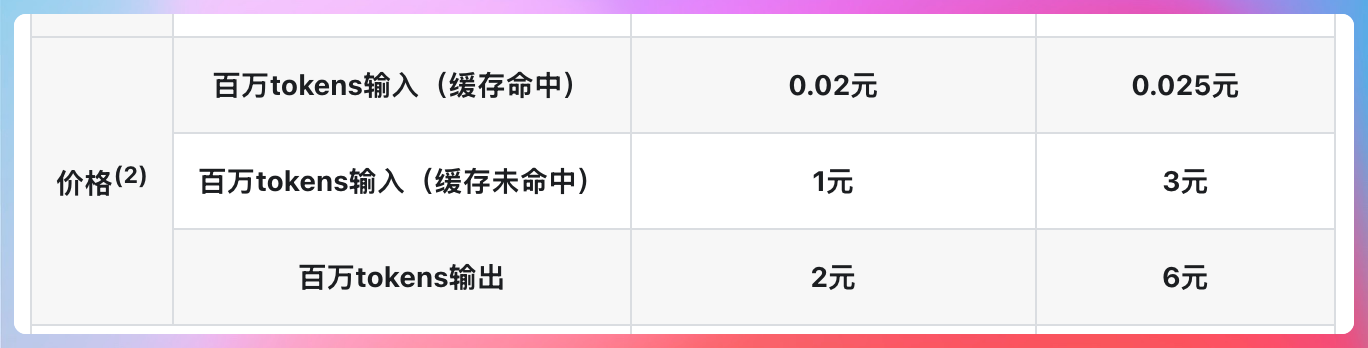
大模型 API 缓存命中和未命中为什么差价巨大? 沉默王二 原创 AI 面试 AI Agent 面试题 Prompt Cache KV Cache Prefix Caching 约 997 字 大约 3 分钟 AI的药,绝不能停 #037 面试官问你:“DeepSeek 官方宣布 API 要涨价了,并且涨幅较大,定价表上缓存命中的百万 Token 输入在缓存命中的情况下只有 0.02元,缓存未命中的输入价格是 1 元,你知道为什么差别这么大吗?” AI Agent 面试题 Prompt Cache KV Cache Prefix Caching WATCH / 抖音视频 在抖音打开 王二讲Agent 每天3分钟,带你吃透Agent。
如果你回答“因为用了缓存嘛。。。。。。所以便宜嘛”,恭喜你,出门右拐回家等通知吧。
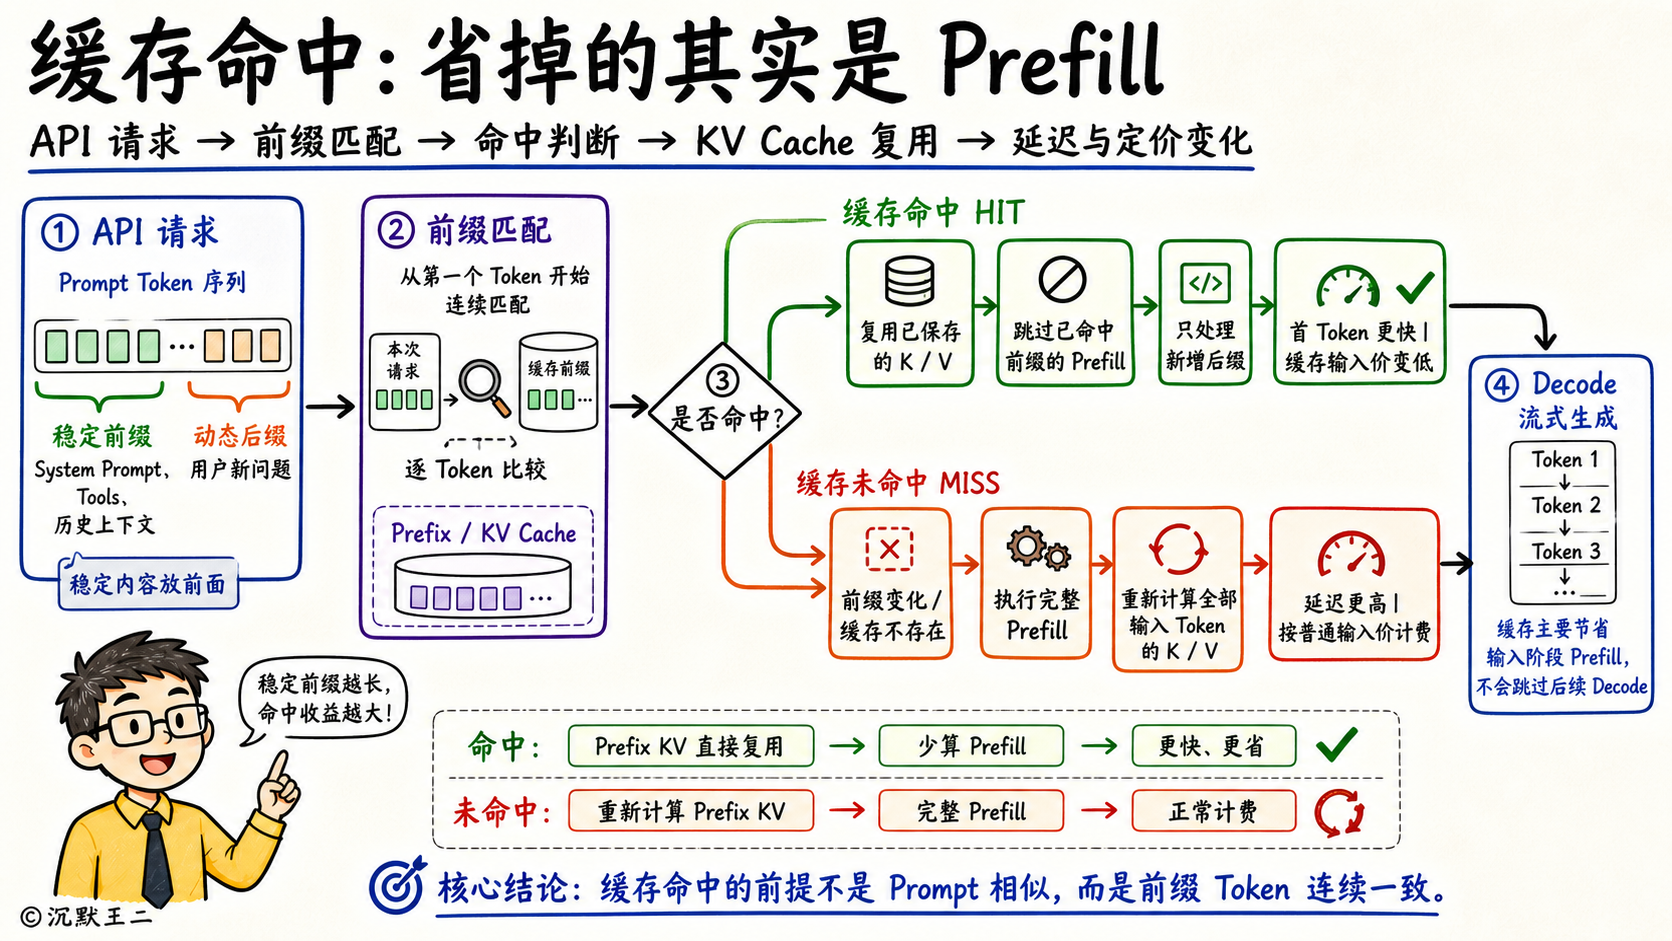
为什么? 因为面试官真正想让你回答的是:缓存命中跳过了推理中最烧 GPU 算力的 Prefill(预填充)阶段——也就是所有输入的 token 并行做矩阵运算,算出注意力机制的 K 和 V 向量。这一步跳过了,GPU 在这个阶段没有浪费算力,所以便宜。
我翻了 DeepSeek、OpenAI、Anthropic 三家的定价文档,又研究了 KV Cache 的技术原理,可以自信地、大方地、光明磊落地帮你搞清楚这三件事: 缓存命中和缓存未命中到底是什么? 为什么能差价 50 倍? 开发者怎么做才能多命中缓存? 哈喽大家好,我是二哥呀。今天用 3 分钟,给你讲清楚大模型 API 缓存定价的秘密。 先说第一件事,什么是缓存命中。 打个比方。你每次调 API,就像给大模型出一张考卷。前半部分是“题目说明”——system prompt、工具定义、few-shot(示范问答),每次都一样。后半部分是“具体问题”——用户这次输入的内容。
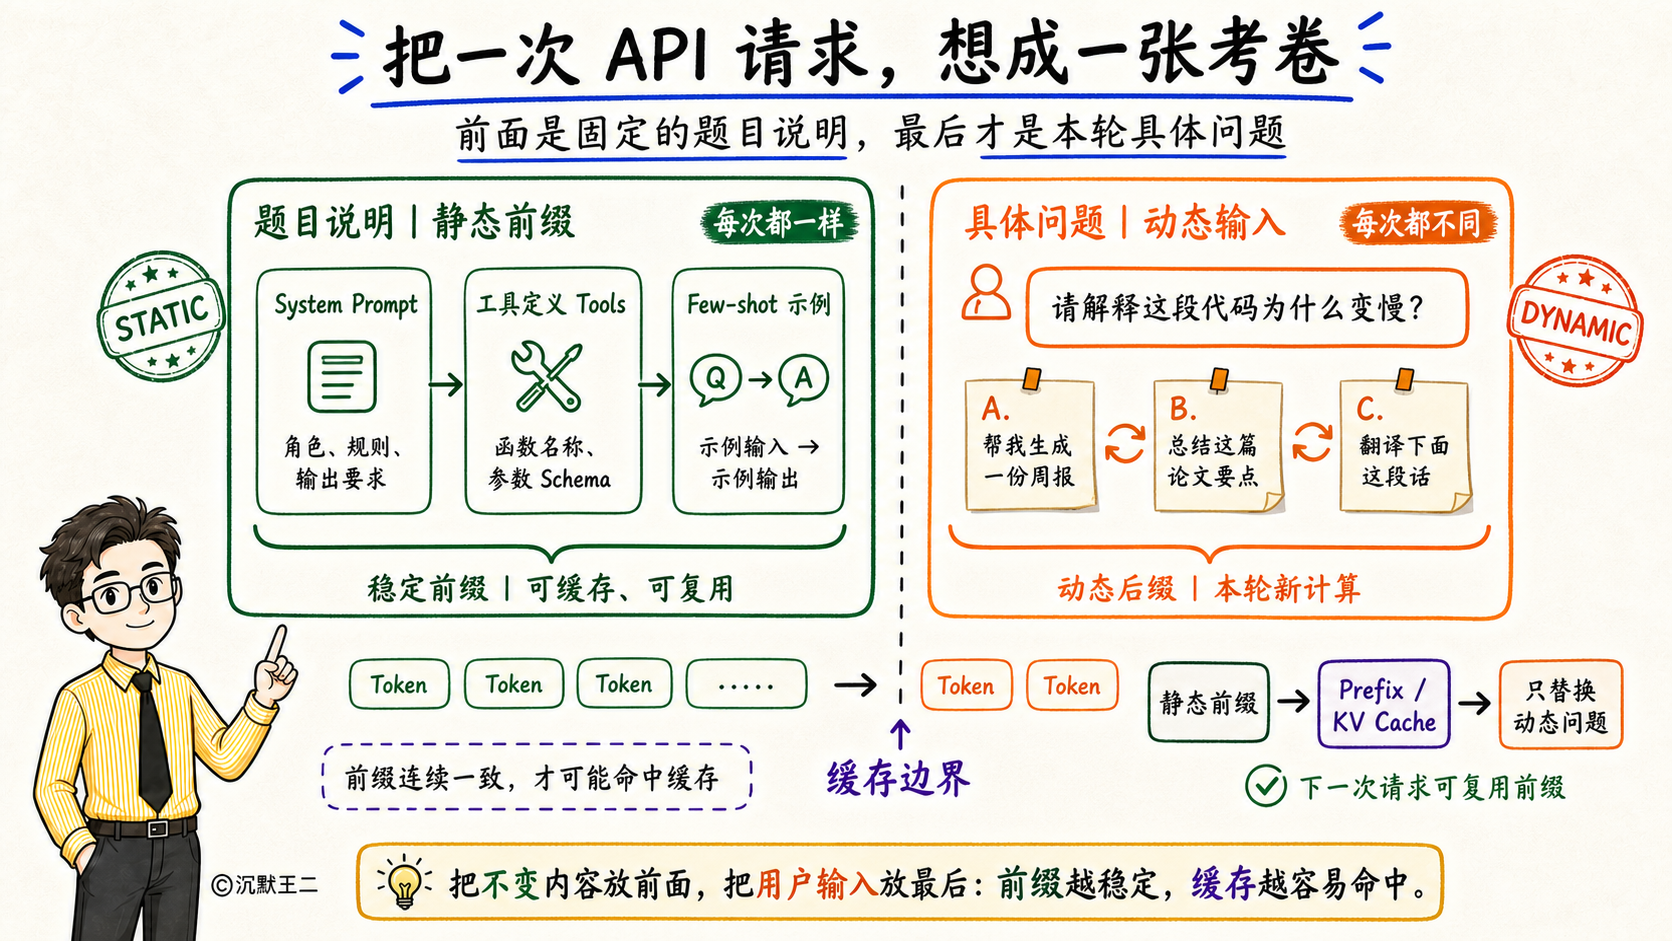
如果前半部分跟上次一模一样,服务端发现“这一段我算过了”,直接复用。这就是缓存命中。 前半部分变了,哪怕改了一个空格,服务端不认了,就得从头算。这就是缓存未命中。 DeepSeek V4 Flash 当前的定价是:缓存命中 0.02 元,缓存未命中 1 元。差了 50 倍。 那聪明的你肯定想问:为什么能便宜这么多? 因为大模型推理分两步。 第一步叫 Prefill(预填充)。模型把所有输入的 token 并行做矩阵运算,算出注意力机制里的 K 和 V 向量,存到 GPU 显存。这一步就像数学考试的第一道大题——光列算式就得写满半页草稿纸,GPU 满负荷运转,当然最烧钱。 第二步叫 Decode(解码)。逐个生成输出 token,直接从显存读之前算好的 K 和 V。
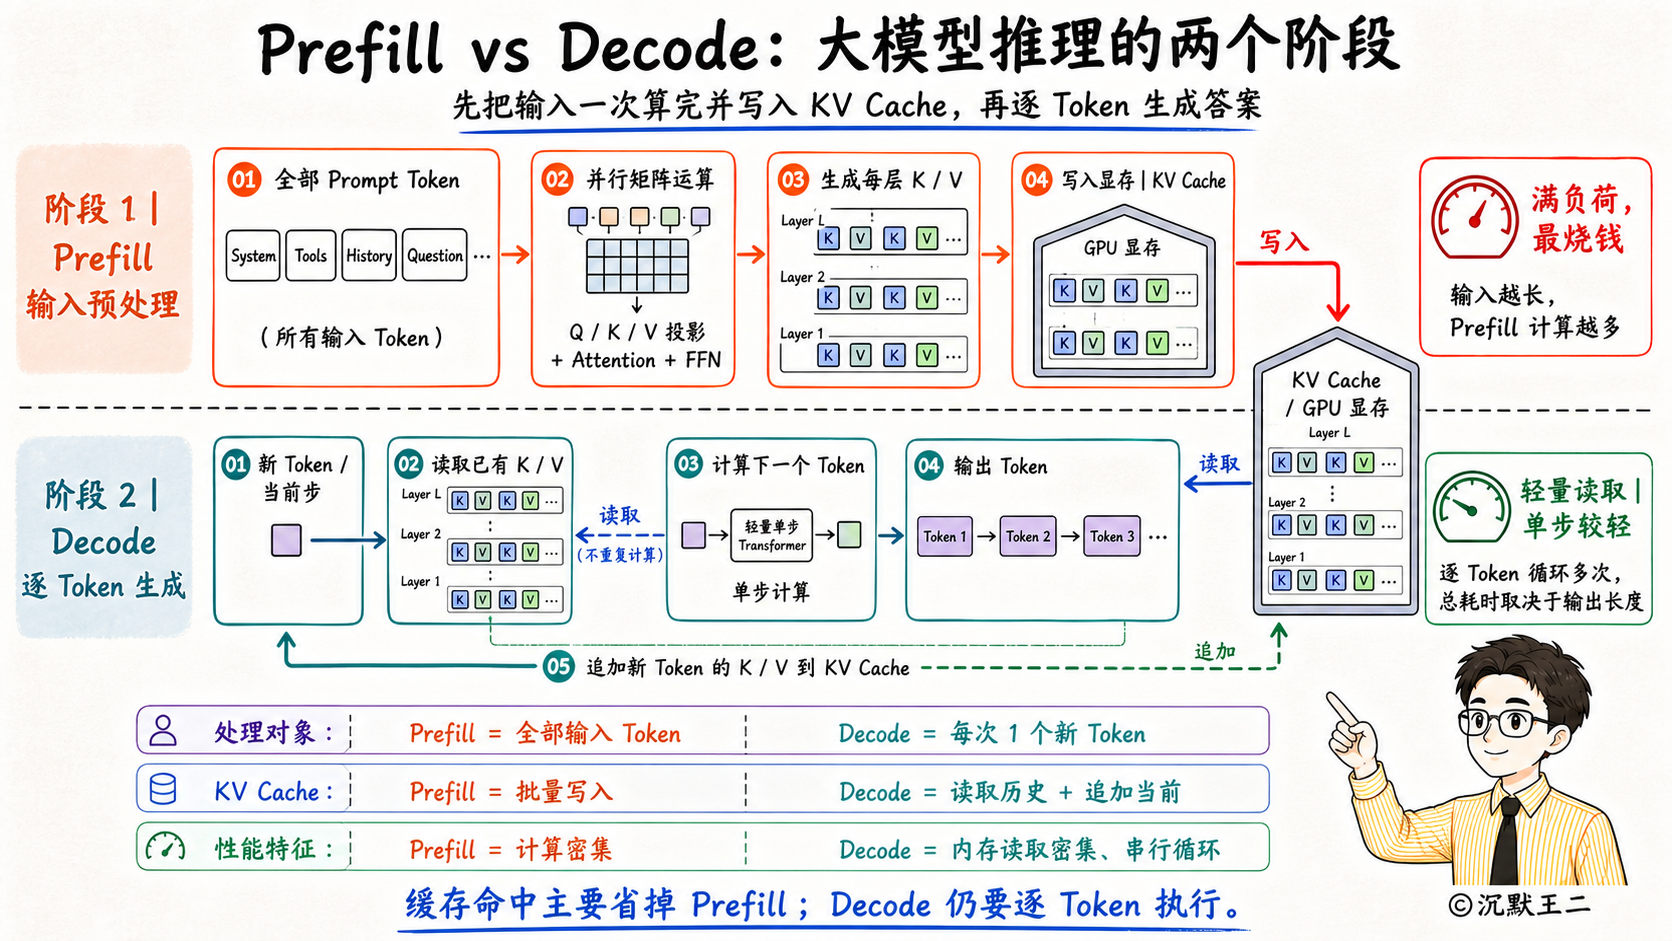
存在显存里的这些 K 和 V,就叫 KV Cache。 缓存命中的本质是:服务端发现“这些 token 的 KV 我已经算好了”,直接跳过 Prefill。GPU 不再做大计算,所以便宜。 那聪明的你肯定又要问了:怎么才能让请求多命中缓存? 一句话:静态的提示词放前面,动态的放后面。 system prompt、工具定义、few-shot 示例——不变的放 prompt 最前面。用户每次新的输入放后面。并且前缀越长越稳定,命中率越高。
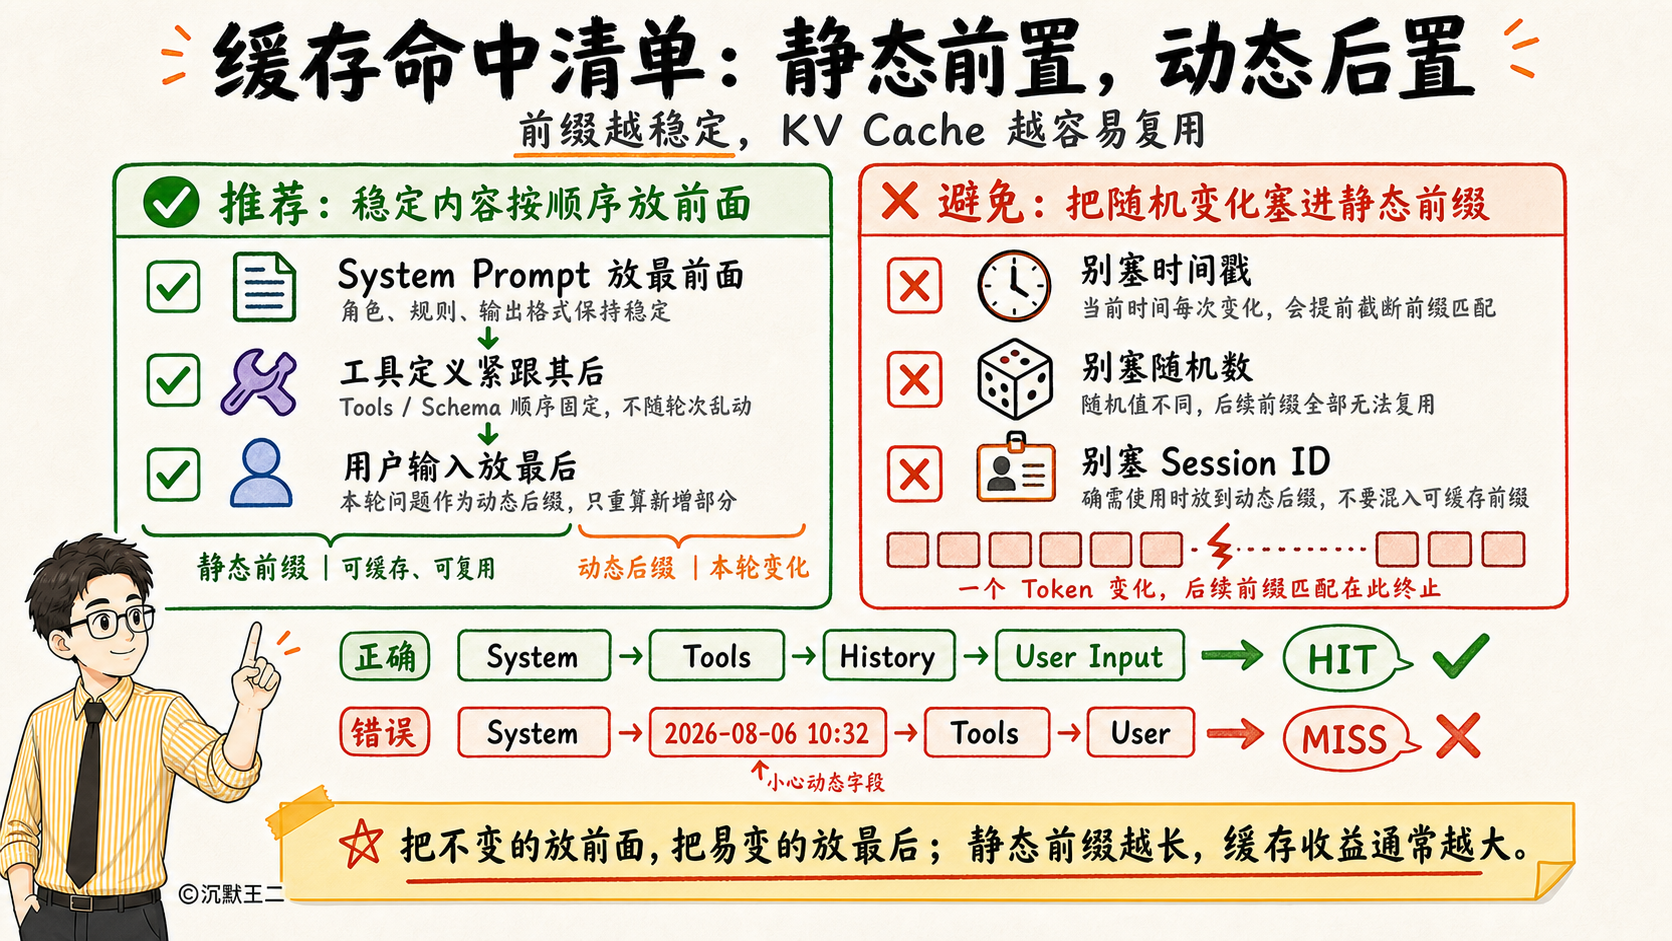
当然了,从 DeepSeek V1 横空出世的那一刻,就打破了不可能的三角规则——既快又好还便宜。哪怕这次大涨一波,大概率还是会比市面上大多数 API 便宜。 毕竟市面上很多中转站的API价格可是DeepSeek 官方的10倍左右。 最后简单总结下。 缓存命中的本质是跳过了最烧钱的 Prefill 计算,所以命中缓存便宜得多。另外,请及时检查一下你的 prompt 结构:把不变的放前面,变化的放后面,别在 system prompt 里塞会变的东西。 这个知识点你学废了吗?想解锁更多 AI 硬核知识,点赞关注,我是二哥,咱们下期见!
在 GitHub 上编辑此页 上次编辑于: 贡献者: 沉默王二 上一页 Responses API 对比 下一页 什么是 KV Cache