


DeepSeek V4 Flash 正式版的激活参数比 V4 Pro 小得多,Agent 能力为什么超过了 Pro 预览版? 沉默王二 原创 AI 面试 AI Agent 面试题 Post-training 激活参数 Agent 能力 约 1212 字 大约 4 分钟 AI的药,绝不能停 #038 面试官问你:“DeepSeek V4 Flash 正式版的激活参数比 V4 Pro 小得多,Agent 能力为什么超过了 Pro 预览版?” AI Agent 面试题 Post-training 激活参数 Agent 能力 WATCH / 抖音视频 在抖音打开 王二讲Agent 每天3分钟,带你吃透Agent。 如果你回答“因为正式版更新了嘛”,恭喜你,出门右拐回家等通知吧。 为什么? 因为面试官真正想让你会答的是:Flash 只有 13B 激活参数,Pro 有 49B,大了将近四倍。模型架构一个参数都没改,只重新做了后训练。结果呢?9 项 Agent 测试,Flash 正式版全面碾压 Pro 预览版。
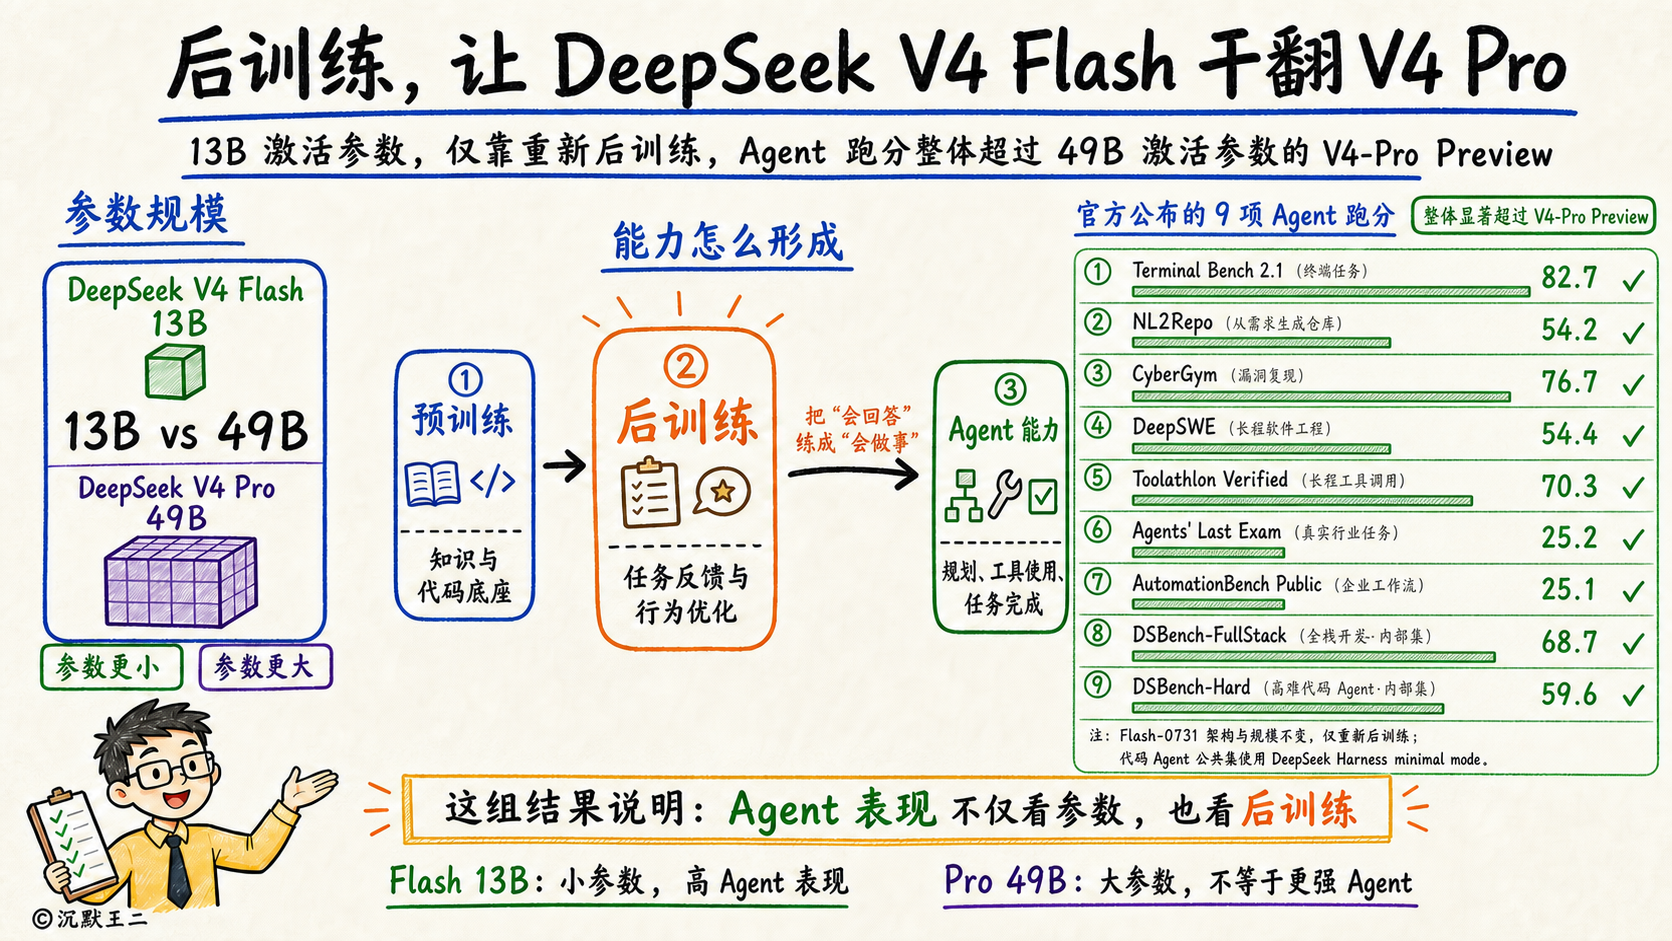
我翻了 DeepSeek 官方博客、HuggingFace 的技术分析、Terminal Bench 和 DeepSWE 的论文,可以自信地、大方地、光明磊落地帮你搞清楚三件事: 后训练到底做了什么,为什么能不换模型就提升能力? 为什么 Agent 能力和参数量关系不大? 对我们选模型有什么实际启发? 哈喽大家好,我是二哥呀。今天用 3 分钟,给你讲清楚为什么后训练能让小模型干翻大模型。 先说第一件事,后训练到底做了什么。 打个比方。预训练就是从小学到大学读了十几年书,学了 32 万亿 token 的知识——物理化学数学文学什么都懂。但什么都懂,不代表考试能拿高分。 后训练就是考前三个月的专项刷题。知识没有增加,但你学会了“看到这类题该怎么答”。 具体分三步。
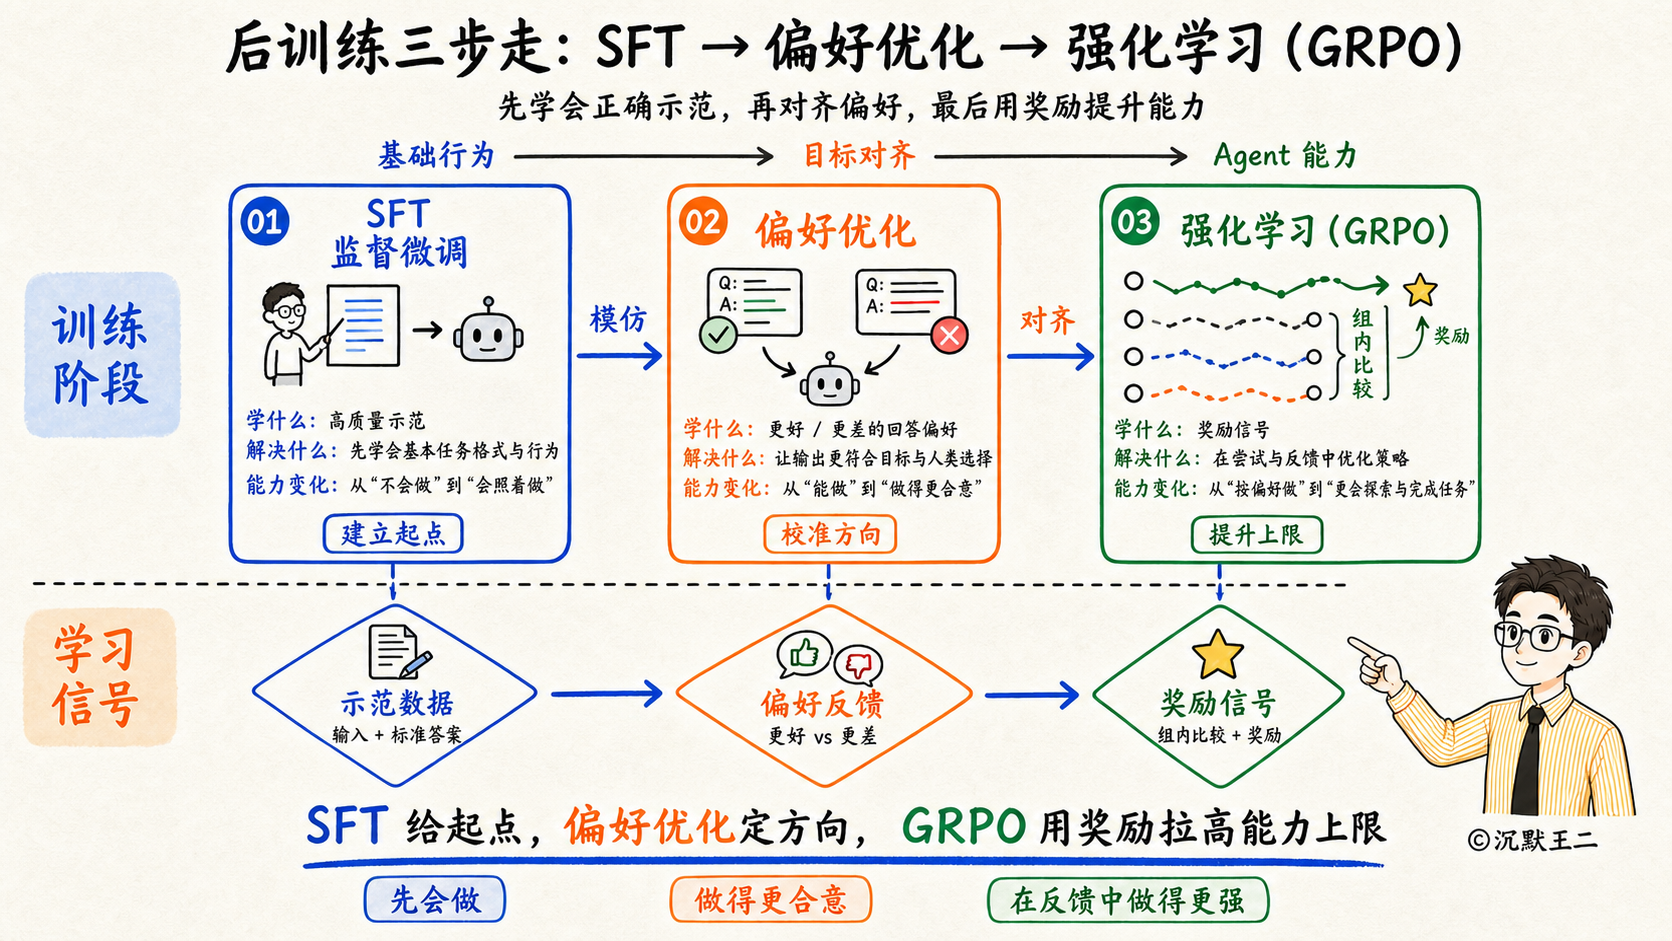
第一步,SFT,监督微调。教模型怎么接活——工具调用的格式是什么、参数怎么填、返回结果怎么读。相当于告诉你“卷子长什么样”。 第二步,偏好优化。拿一堆好答案和坏答案做对比训练,让模型学会区分——哪条工具调用序列是对的,哪条看着对但实际上有坑。 第三步,强化学习。DeepSeek 用的是自研的 GRPO 算法,让模型在 Agent 任务里反复试错,做对了给奖励,做错了扣分。代码和工具调用特别适合这种训练——因为结果对不对,程序一跑就知道,奖励信号干净可靠。 V4 Flash 正式版就这么练了三个月。284B 总参数一个没动,13B 激活的 MoE 架构也一模一样。 那聪明的你肯定想到了:凭什么后训练能弥补参数量的差距? 因为 Agent 能力和通用对话能力,是两码事。
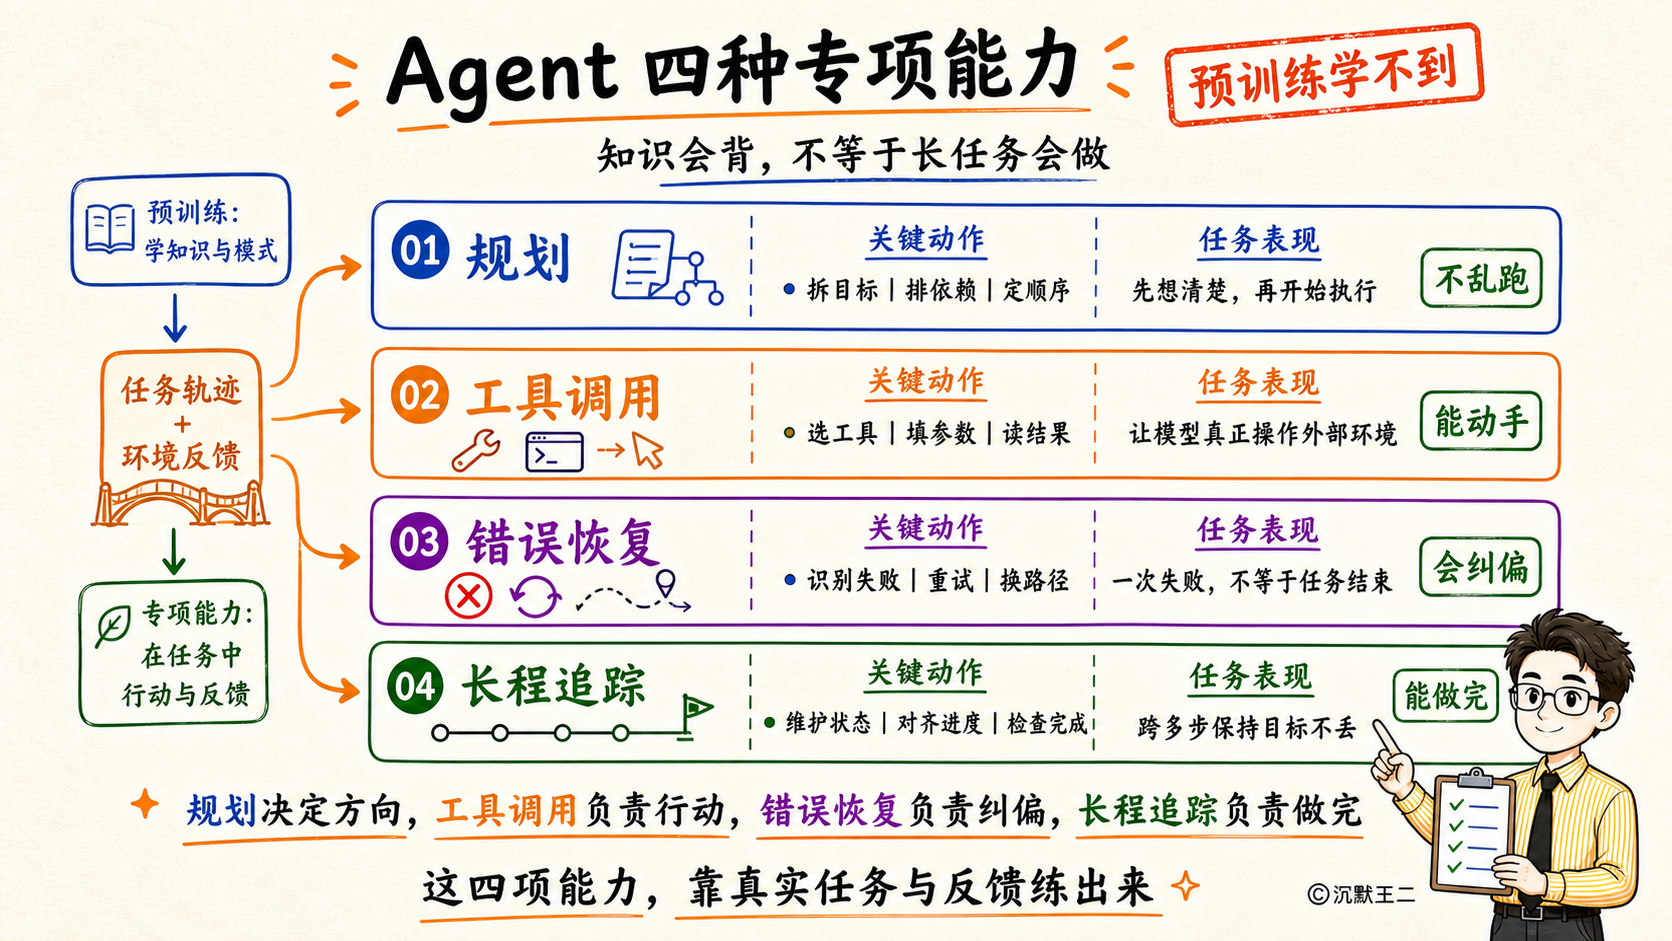
Agent 任务需要四种专项能力:规划——把复杂任务拆成多个步骤;工具调用——从几百个工具里选对的、填对参数;错误恢复——中间做错了能发现并回退;长程追踪——几十轮交互下来还不跑偏。 这四种能力,预训练几乎学不到。 为什么? 预训练的优化目标是“预测下一个词”,Agent 需要的是“在真实环境中做出正确决策”。这是两个根本不同的目标。 同一辆车,新手和老司机过弯的差距——不是发动机不同,是驾驶策略不同。新手过弯减速到 30 码,老手知道可以 60 码压线过。 当然了,我建议你还是 30 码过弯,毕竟不是每个老司机都是藤原拓海啊。 好,再来看看跑分。DeepSWE 从 7.3 飙到 54.4,涨了 7 倍多。Terminal Bench 从 61.8 到 82.7。Agent 终极测试 25.2 分,Opus 4.8 是 25.7——只差 0.5 分。 13B 激活参数的开源模型,逼平了当前最强的闭源旗舰之一。 那聪明的你肯定又要问了:这对我们选模型有什么用? 有——Agent 场景别只看参数量。 Flash 每百万 token 输入是 Pro 的三分之一。而 Agent 任务一跑就是几十上百次工具调用,成本会被任务链条不断放大。同样的活儿,Flash 干得一样好甚至更好,价格便宜两三倍。 2026 年的模型竞争已经从“谁的参数多”变成了“谁的后训练做得好”。DeepSeek 自己也想明白了——除了练模型,还专门组了一个 Harness 团队,要从零造一个中国版 Claude Code。 据说快要和大家见面了。 最后简单总结下。 后训练是策略训练,不是重新造发动机。Agent 能力不看参数大小,看的是有没有针对 Agent 任务专门训练过。另外,选模型的时候先看 Agent 专项跑分,再看价格,参数量排最后。 这个知识点你学废了吗?想解锁更多 AI 硬核知识,点赞关注,我是二哥,咱们下期见!
在 GitHub 上编辑此页 上次编辑于: 贡献者: 沉默王二 下一页 CSA HCA 与缓存