


Codex 的长期记忆是怎么实现的? 沉默王二 原创 AI 面试 AI Agent 面试题 OpenAI Codex 长期记忆 项目经验 约 922 字 大约 3 分钟 AI的药,绝不能停 #030 你想不想知道 Codex 的长期记忆是如何实现的?为什么 Codex 用得越久,似乎越聪明?似乎更了解你的偏好? AI Agent 面试题 OpenAI Codex 长期记忆 项目经验 WATCH / 抖音视频 在抖音打开 王二讲Agent 每天3分钟,带你吃透Agent。 我研究了 Codex 的开源仓库,尤其是关于记忆机制的源码,也查了我本地的 SQLite——Codex 会把长期记忆放这里,可以自信地、大方地、光明磊落地帮你搞清楚三件事: 长期记忆是怎么形成的? 记忆越来越多,要不要删掉? 最终的长期记忆是什么样子?
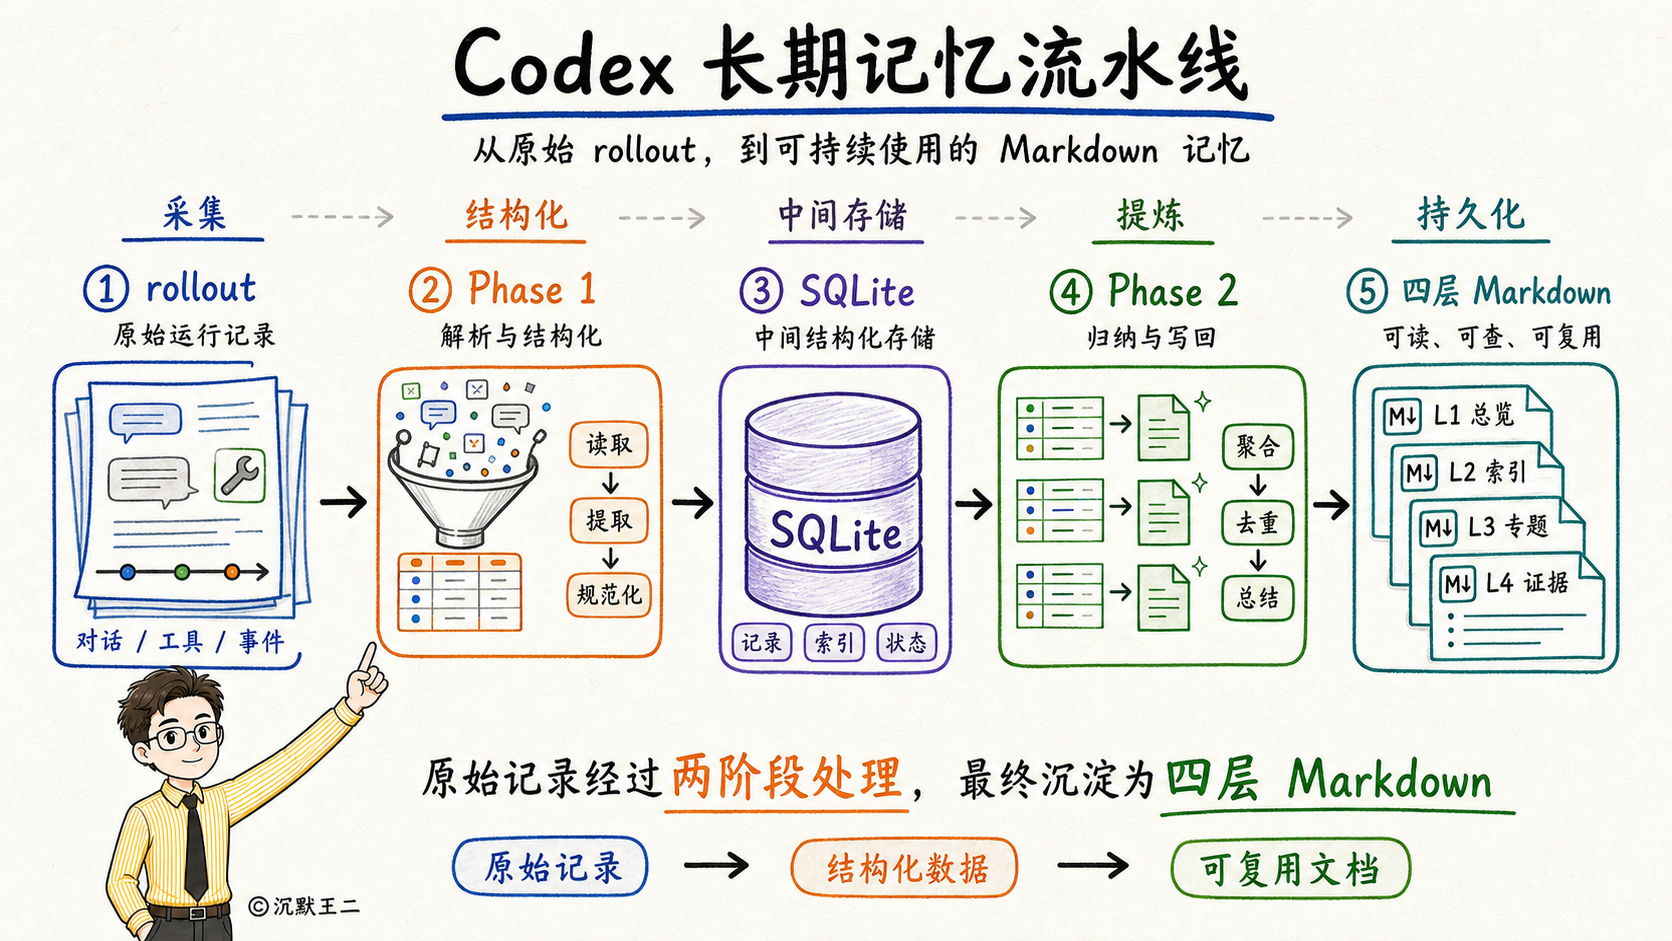
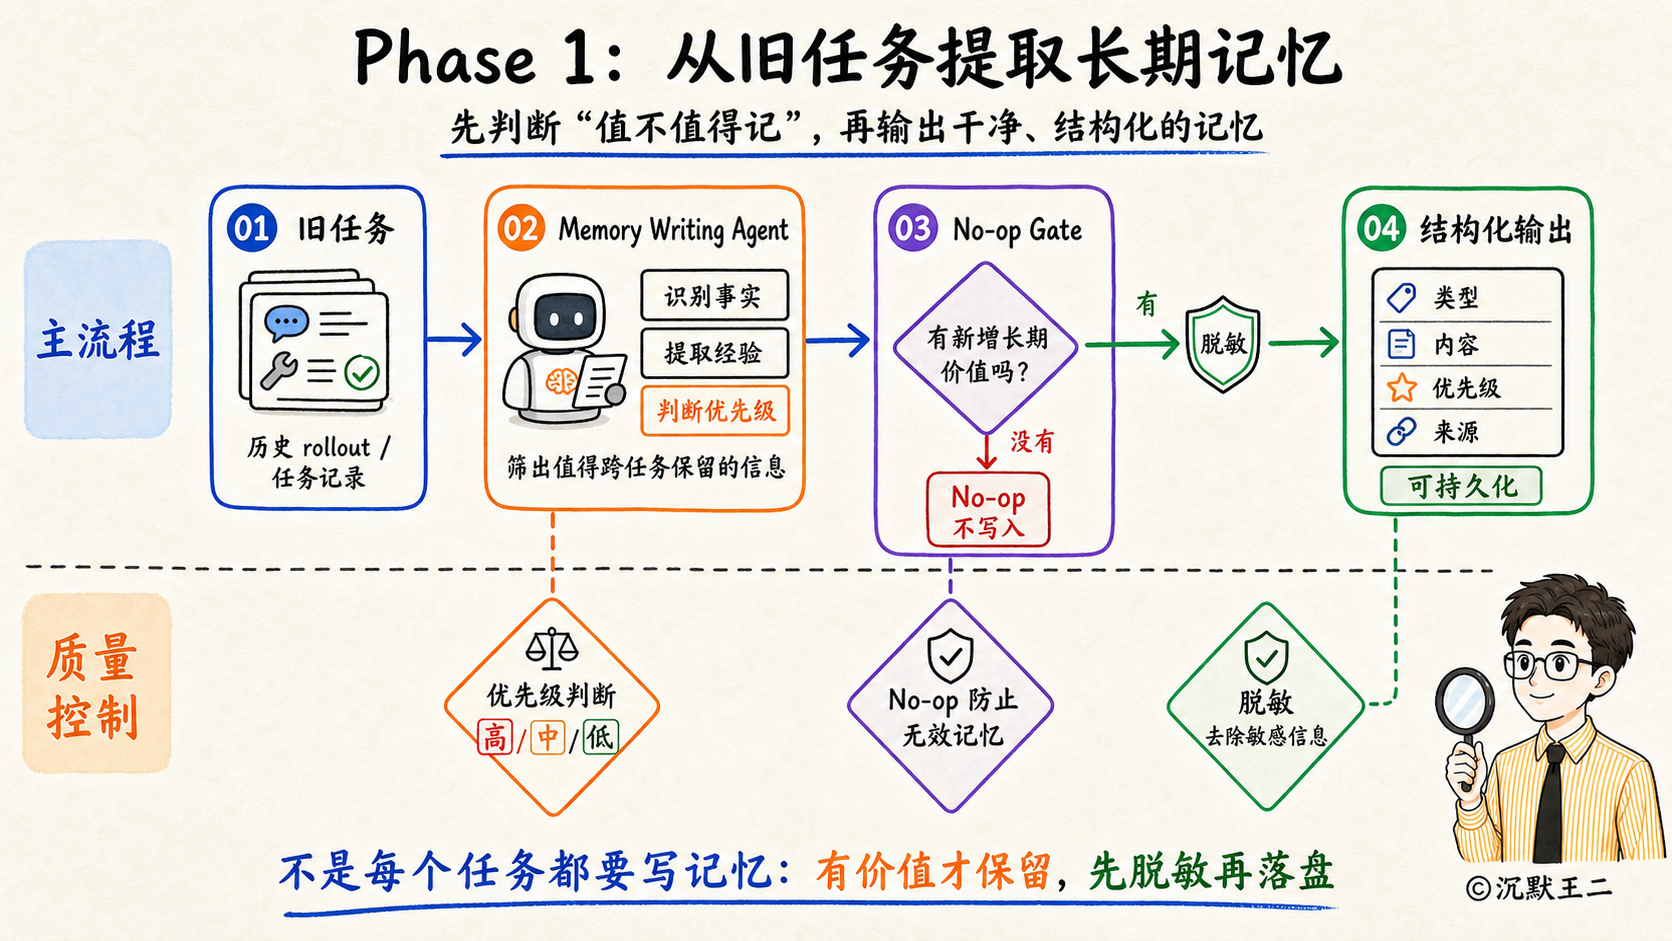
哈喽大家好,我是二哥呀。今天用 3 分钟,给你讲清楚 Codex 的长期记忆是怎么实现的。 先说第一件事。每次对话是怎么变成长期记忆的。 不是每次聊完就存。Codex 会在你开新任务(或者叫线程)时,后台处理之前的旧任务,把里面值得保存的记忆存下来。 Codex 会派一个子 Agent 读历史对话,并按照这个优先级来提取长期记忆:先读你说了什么、工具跑了什么结果,模型回复的内容只做参考。 然后判断这段记忆存下来,Agent 会不会因此表现更好? 不会?那就不存。 这一刀砍下来,直接就砍掉了大量的“你好”、“谢谢”、“OK”这种意义不大的内容。生成完还会脱敏,API Key、密码都会被替换掉。
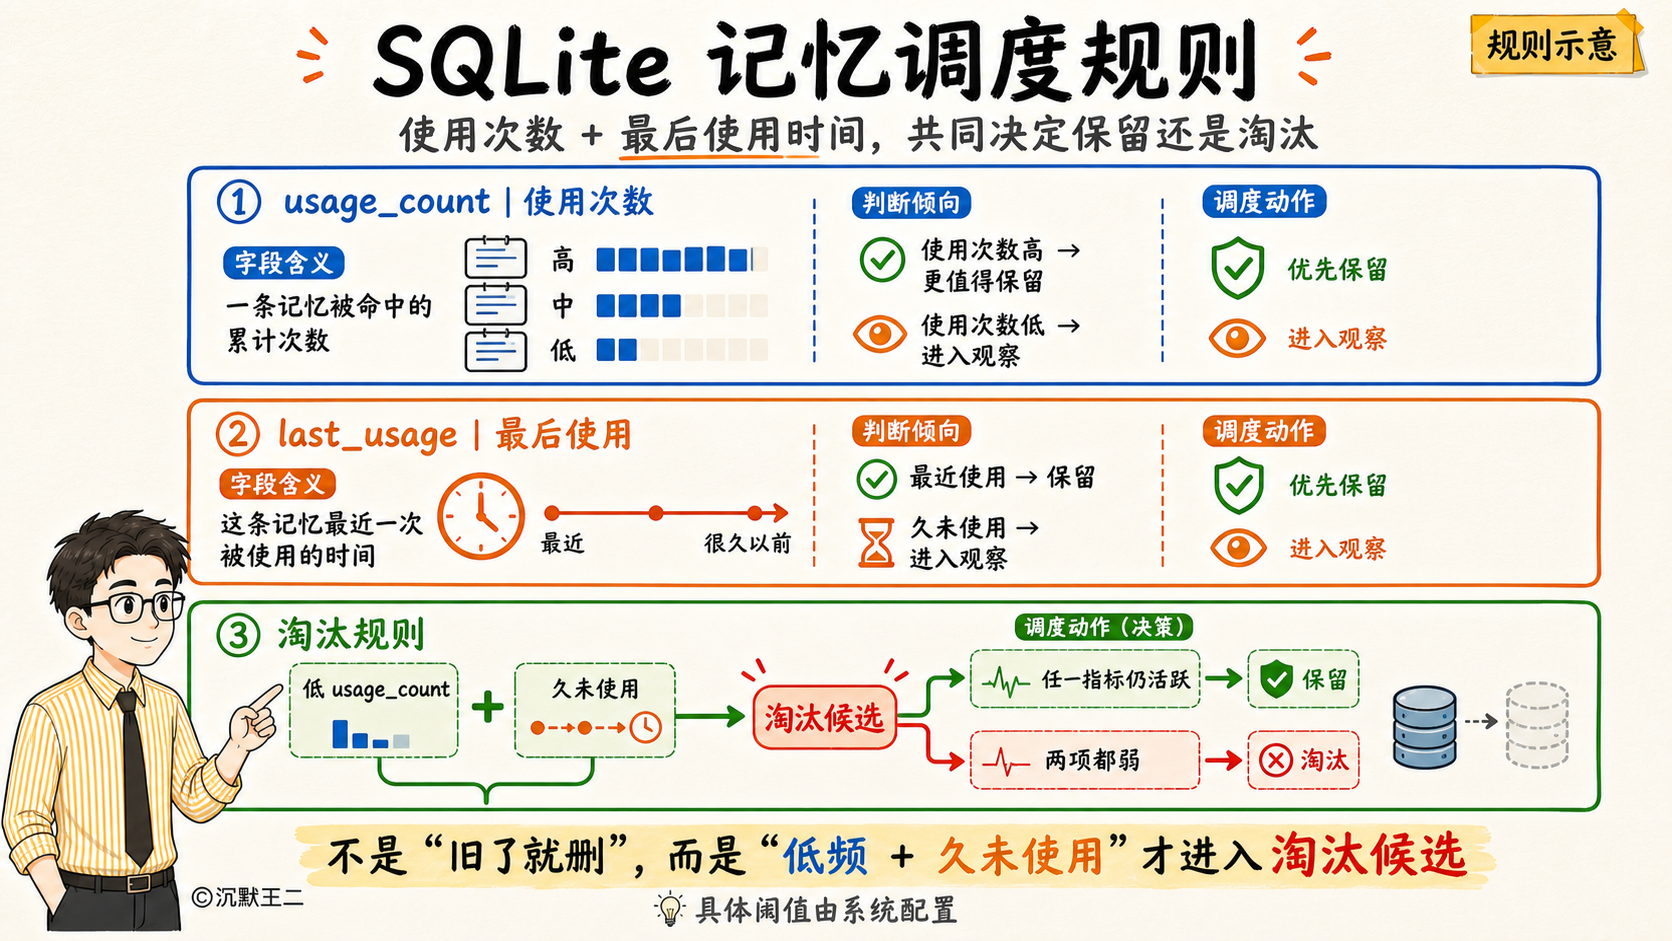
会,就存到 SQLite。 那聪明的你肯定想到了,每次新任务都会生成长期记忆,时间一长 SQLite 不就爆了? Codex 显然和聪明的你一样,想到了一个巧妙的解决办法。 每条记忆记有两个指标:usage_count,也就是被引用几次;last_usage,也就是最后使用时间。 有了这两个字段,事情就好办多了。用得多的记忆排前面,长期没用过的逐渐淘汰。 注意,这一步没有用向量相似度打分,也没有 Embedding,没有 Top-K。就是用频率加时效排序。简单,实用。
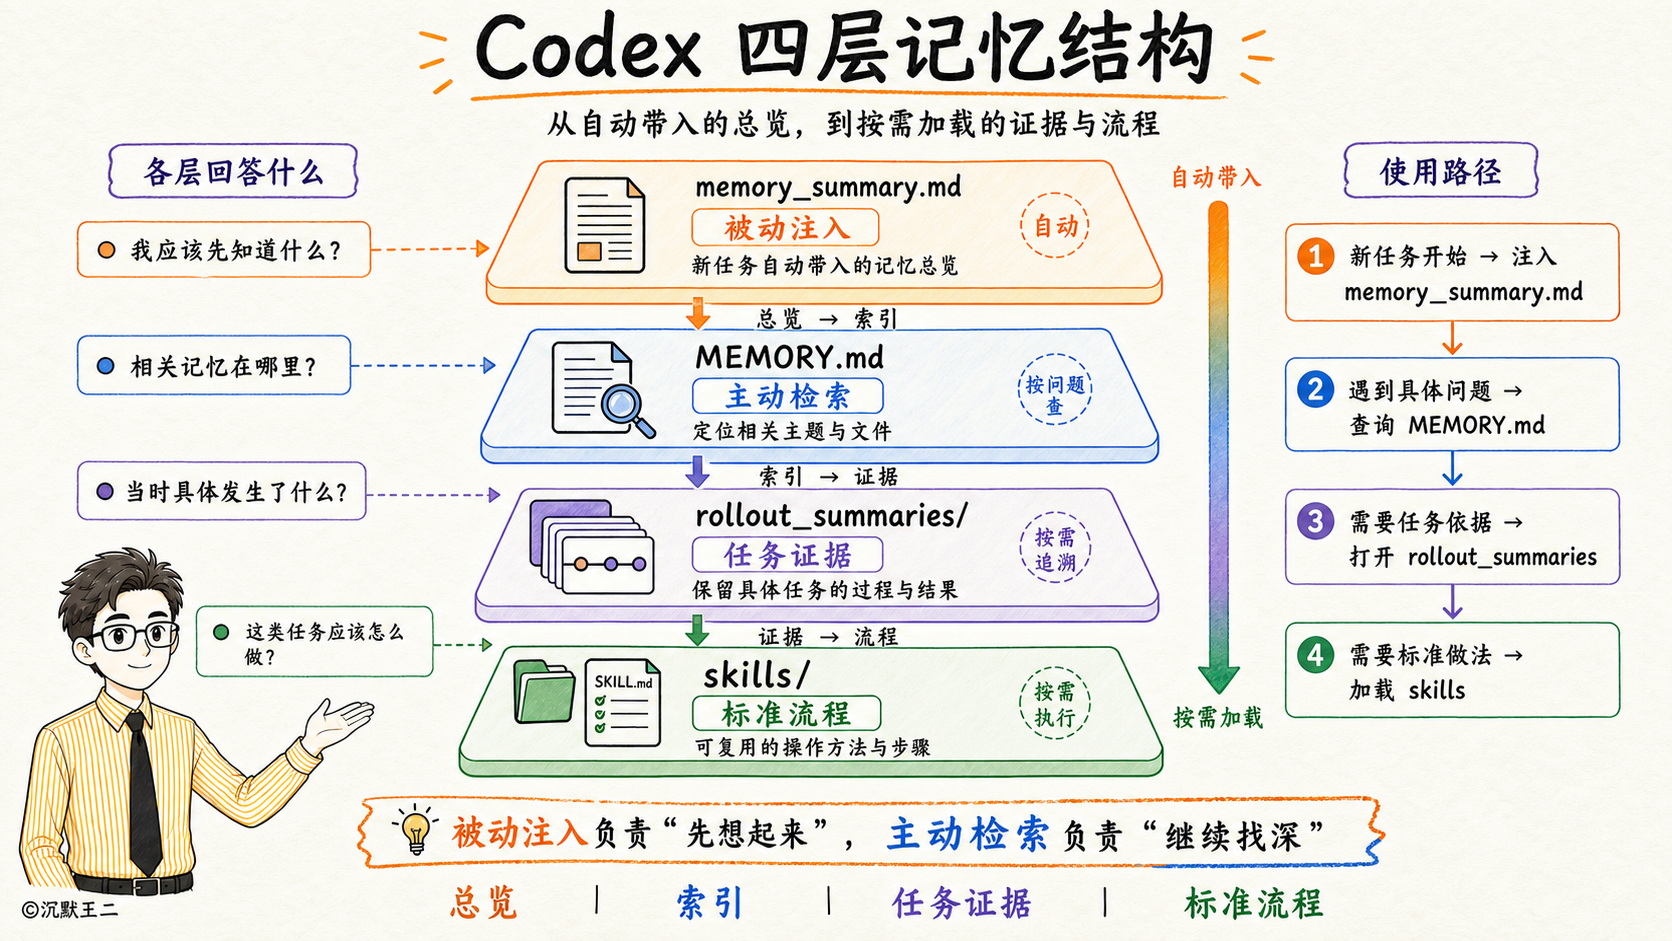
那聪明的你肯定又要问了,排序是排序了,然后呢? 接下来,进入第二阶段。取排名靠前的记忆,启动一个新的子 Agent,把这些记忆分门别类。 第一层是记忆总结,主要是高密度的用户画像,新任务会自动注入上下文。这样新的任务一上来就知道你是谁。 第二层是详细操作手册,会按关键词搜索。我本地的 MEMORY.md 目前有一千六百多行,只搜索关键词其实也非常快。 第三层是每个任务的详细证据——做了什么、踩了什么坑。 第四层是skills。把重复的流程升级成可复用的标准,有触发条件、有步骤、有检查方式。
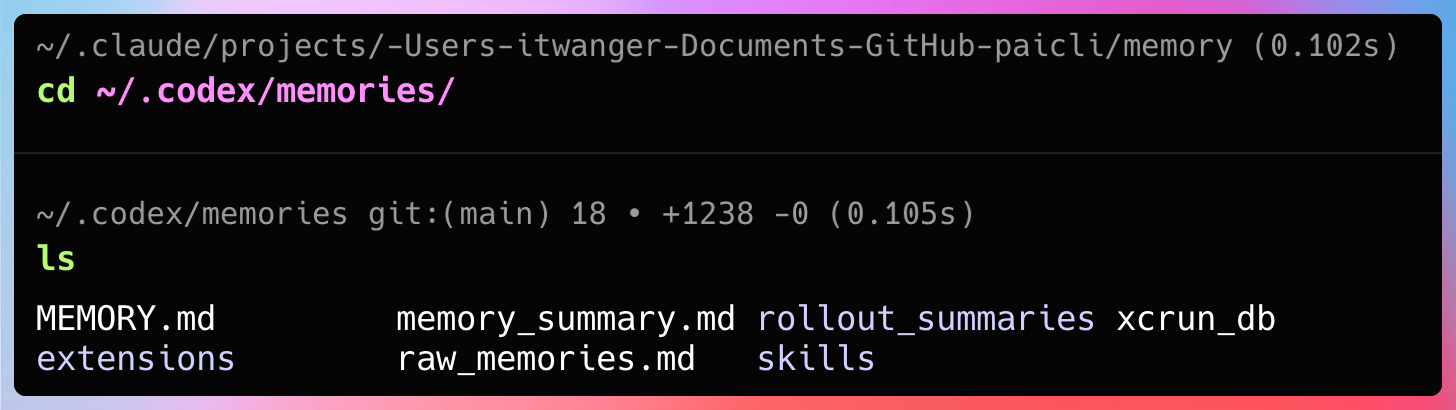
有个细节需要注意。第二阶段的子 Agent 权限很小:不能联网,不能派子 Agent,不能读自己的旧记忆。 为什么? 防止“记住自己在生成的记忆”,对记忆总结造成污染。 最后简单总结下。 Codex 的长期记忆先是 LLM 提炼总结,然后用 SQLite 做中转,再然后用 Markdown 按照使用次数、时效进行整理。 打开你本地的 ~/.codex/memories/ 文件夹,就可以看到 Codex 的长期记忆文件。
这个知识点你学废了吗?想解锁更多 AI 硬核知识,点赞关注,我是二哥,咱们下期见!
在 GitHub 上编辑此页 上次编辑于: 贡献者: 沉默王二 上一页 Codex 短期记忆