


Claude Code 如何检索长期记忆? 沉默王二 原创 AI 面试 AI Agent 面试题 Claude Code Memory 记忆检索 语义检索 约 987 字 大约 3 分钟 AI的药,绝不能停 #028 聪明的你一定想问:Claude Code 存了 100 条长期记忆,只有 3 条跟当前 Prompt 相关,他是怎么精准找到的? AI Agent 面试题 Claude Code Memory 记忆检索 语义检索 WATCH / 抖音视频 在抖音打开 王二讲Agent 每天3分钟,带你吃透Agent。 你可能以为 Claude Code 用了什么高级的向量搜索、语义匹配。 答案让你意外到惊掉下巴。 它没有。 我翻了 Claude Code 的源码和 OpenClaw 的源码,今天帮你搞清楚这三件事: Claude Code 是怎么检索长期记忆的? 为什么这么简单的方案也能这么高效? 有没有更高级的方案?
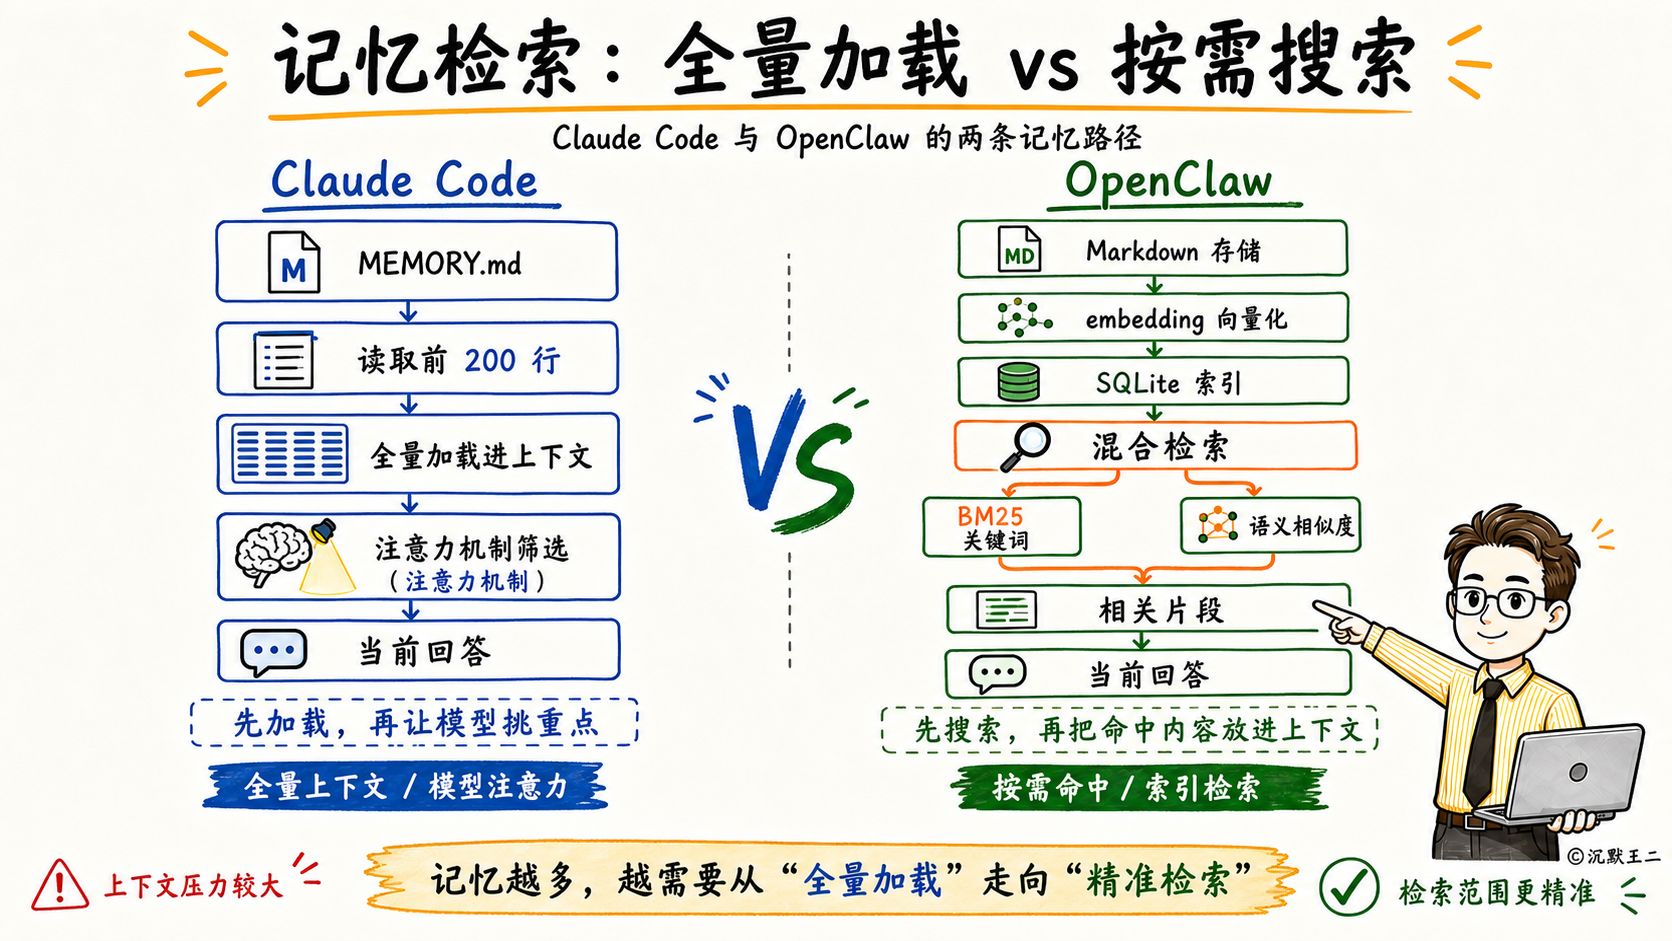
哈喽大家好,我是二哥呀。今天用 3 分钟,给你讲清楚 Claude Code 的长期记忆是怎么检索的。 先说第一件事,Claude Code 的长期记忆检索真的超级简单。 每次你新开一个对话,Claude Code 会去读 MEMORY.md 这个索引文件,最多读前 200 行,或者 25KB,剩下的不管了。 读完之后,哪些记忆跟你当前的问题相关呢? 它不做任何筛选。直接把这 200 行全部塞进上下文,交给大模型自己判断。 没有向量检索,没有语义匹配,没有 embedding,没有数据库。
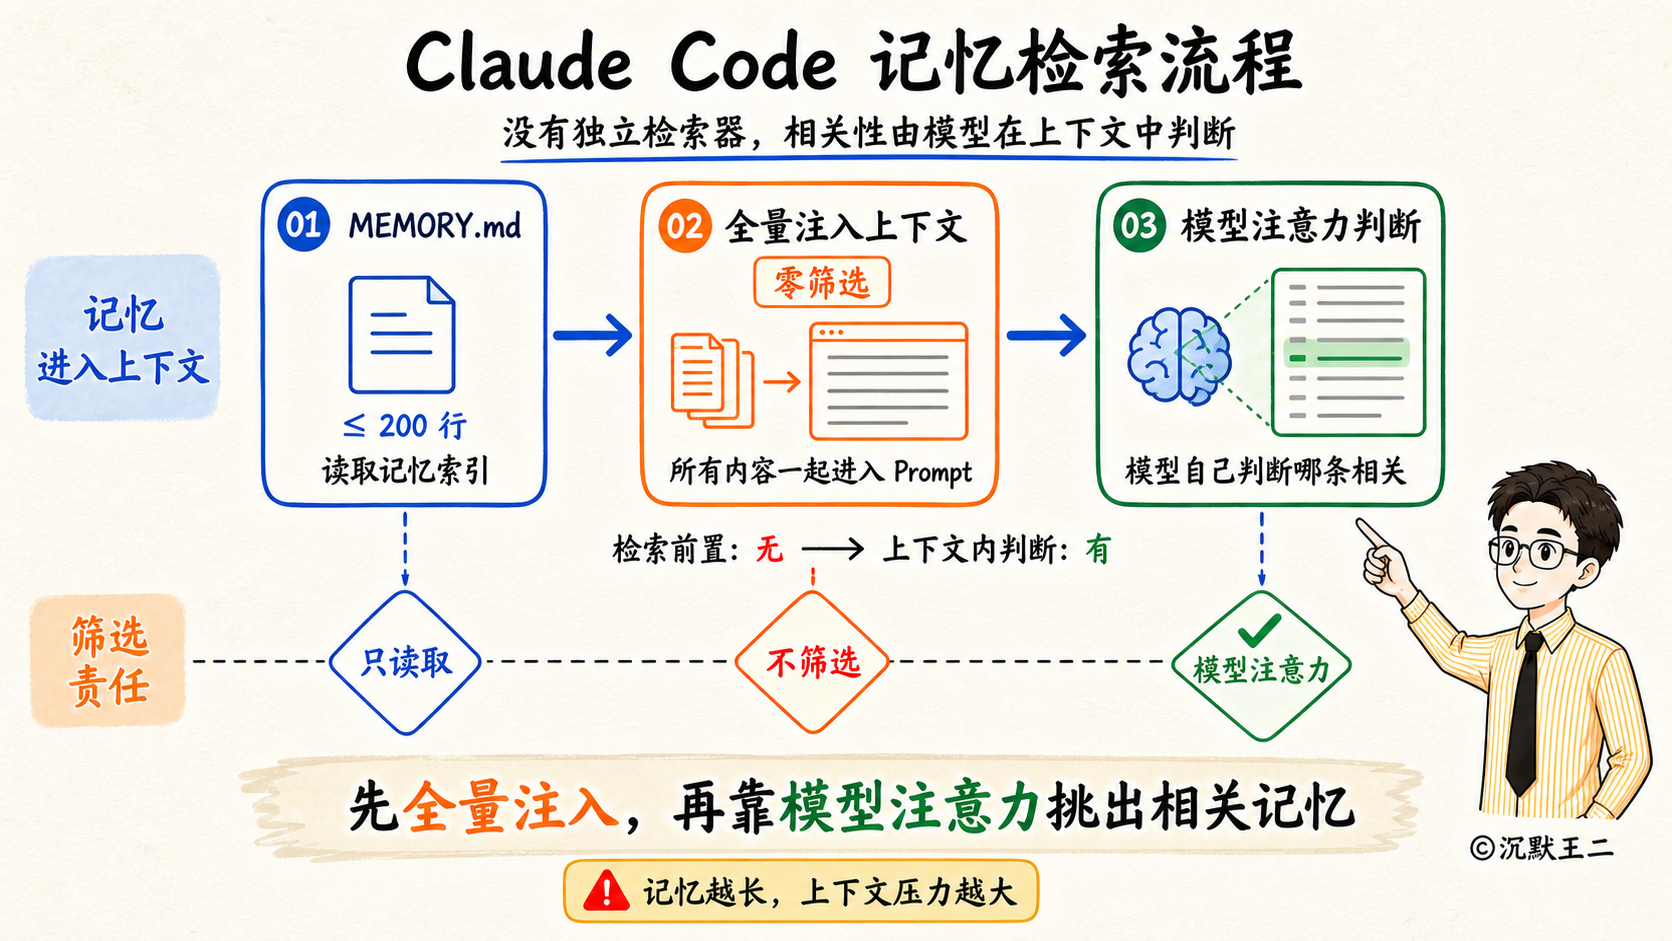
CLAUDE.md 更直接。整个文件注入系统指令,全量加载,当然要求你的CLAUDE.md要写的足够精简有效,这个我们上一期讲过了。 那聪明的你肯定想到了:这么简单的方案,真的够用吗? 够用。但有条件。 大模型本身就有很强的注意力机制。200 行文本里面找 3 条相关的,对 Opus 5 来说,小菜一碟。 但代价是什么?MEMORY.md 必须控制在 200 行以内。第 201 行开始的根本不会被加载,写了也白写。 所以上期讲的 MEMORY.md 是索引非常关键。索引要精简,一条记忆一行摘要就够了。写得啰嗦,重要信息就被噪音淹没了。 这也解释了为什么 Claude Code 会自动整理记忆——合并重复的、删掉过时的。是为了在 200 行的限制内,塞下更多有效信息。 那聪明的你肯定又要问了:有没有更高级的方案? 好像没有,但可以给你提供另外一个思路。比如说之前爆火的 OpenClaw,走的就是另一条路子。 Claude Code 是 Markdown 一个文件干两件事,存和读。OpenClaw 把这两件事拆开了:Markdown 只负责存内容,SQLite 负责找内容。
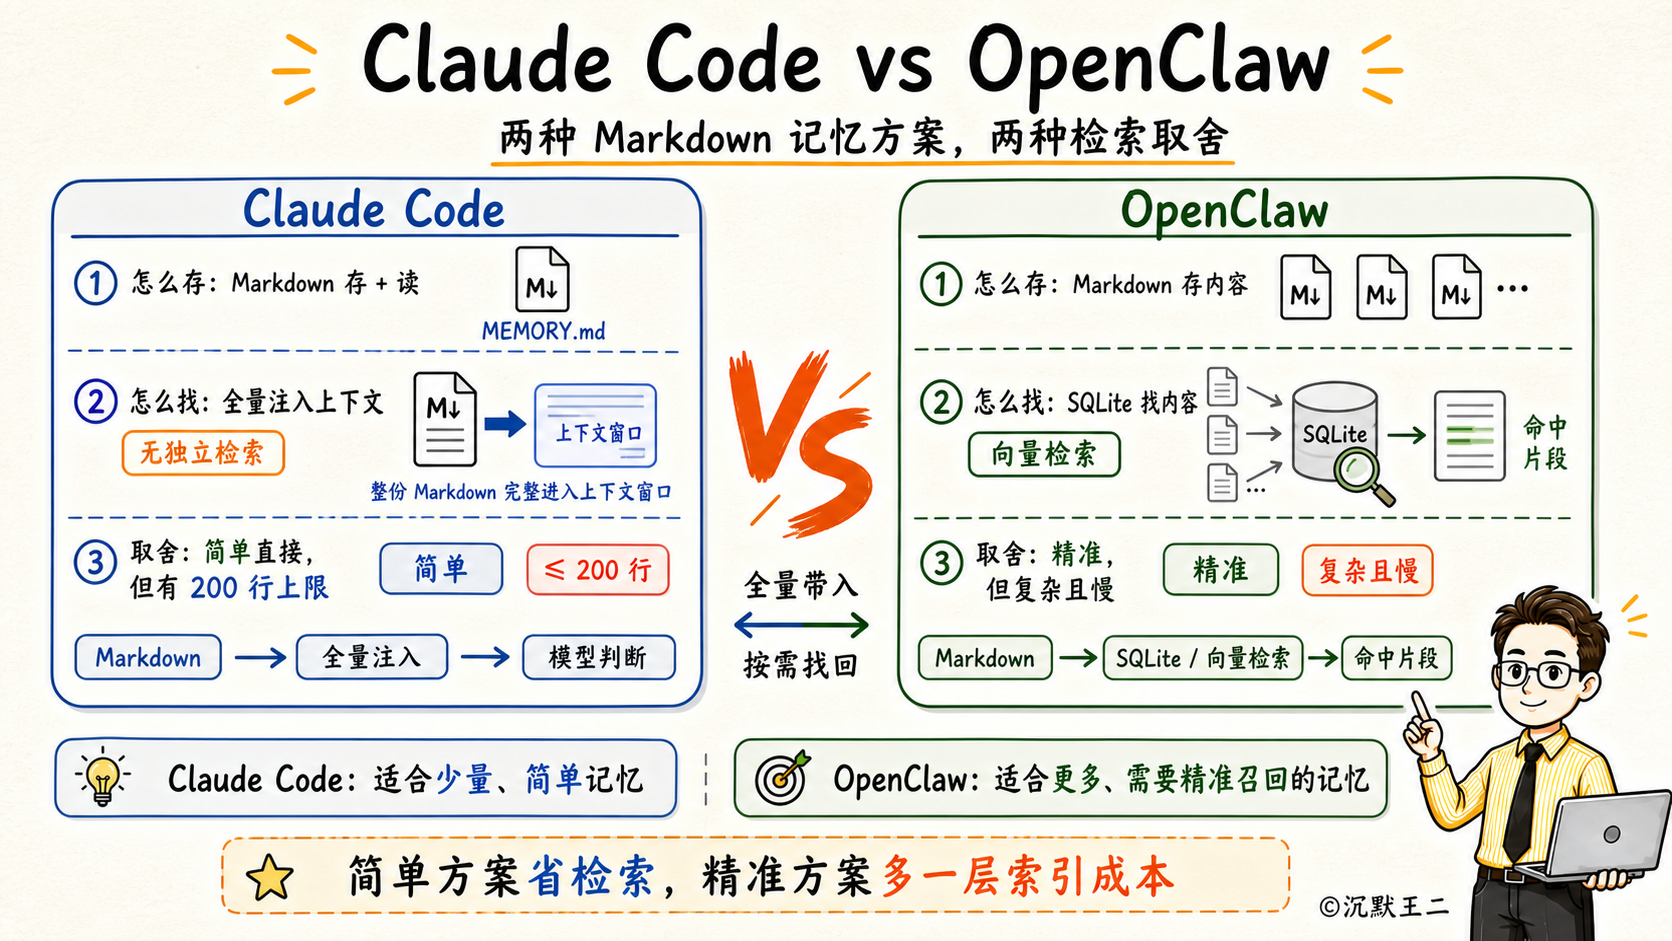
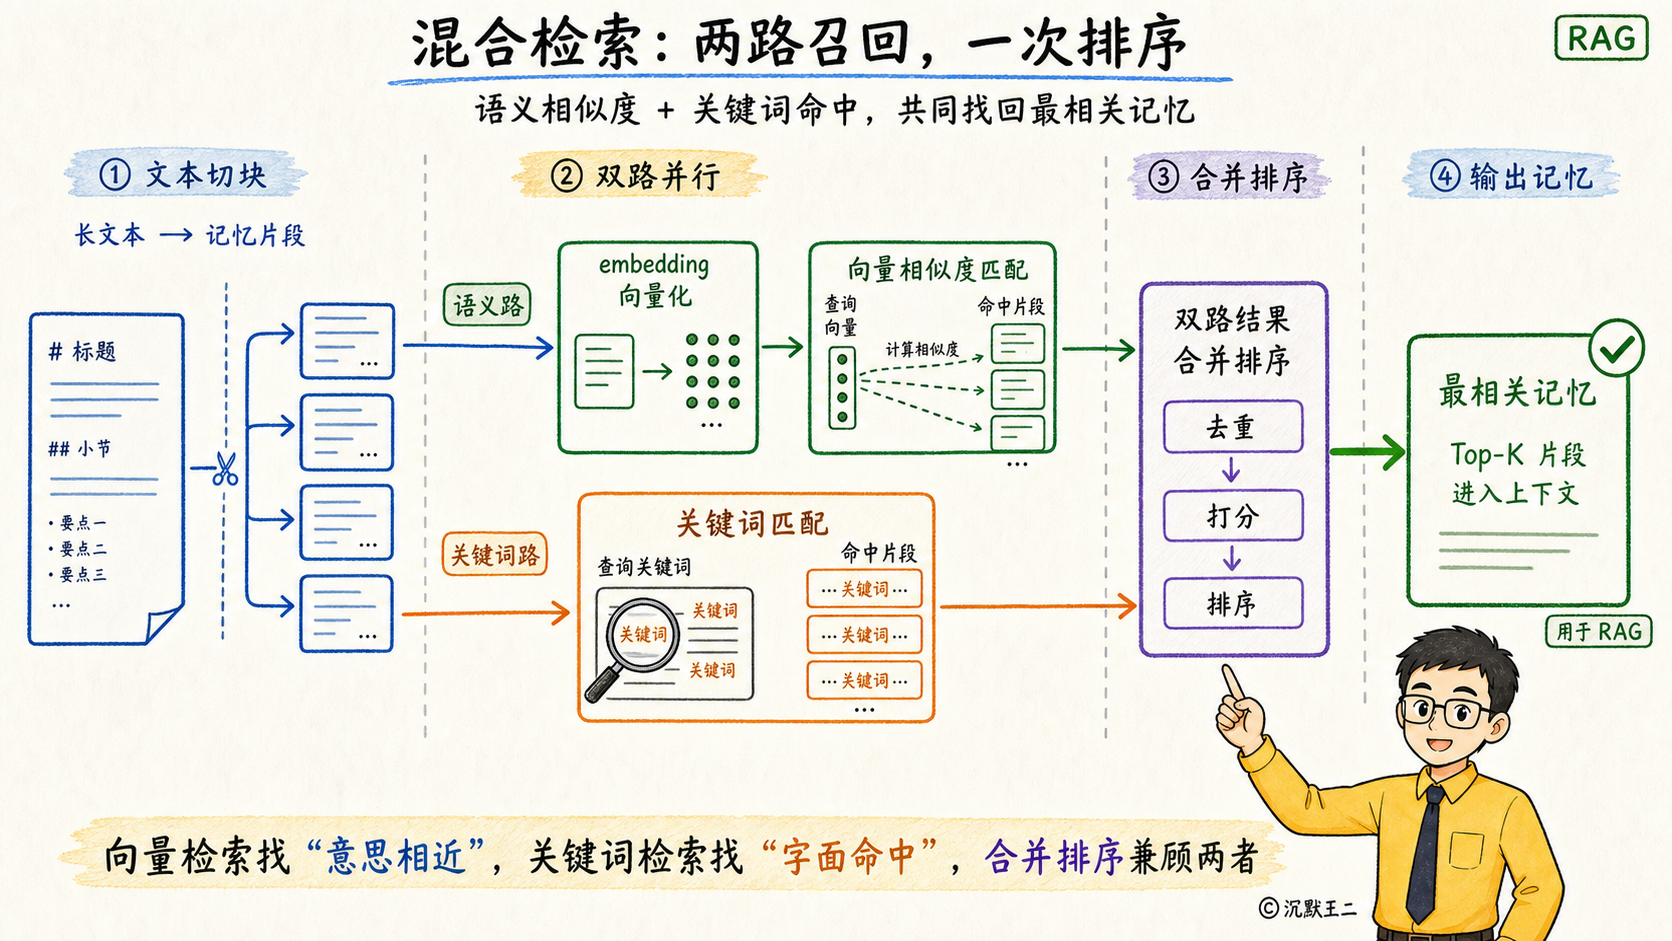
怎么找的呢? 存记忆的时候,OpenClaw 会把 Markdown 内容切成一小块一小块的,然后交给 embedding 模型,把每一块文字转成一串数字,也就是向量。这些向量存进 SQLite。 找记忆的时候,把你当前的问题也转成向量,然后跟 SQLite 里存的向量做相似度匹配。相似度越高,说明这条记忆跟你的问题越相关。 而且 OpenClaw 还会同时跑一遍关键词匹配,两个结果合在一起排序。这就是混合检索——关键词找得准,语义找得全,再来一个排序,是经典的 RAG 思路。
好处是记忆再多也能精准找到。坏处是得额外跑一个 embedding 模型,这也就是为什么OpenClaw会很慢,很迟钝,当然了,当年吹他的人会忽略这个致命的缺点,就是慢。 最后简单总结下。 Claude Code 靠模型注意力检索,简单但有 200 行上限。OpenClaw 靠向量搜索加关键词匹配,精准但复杂。另外,不管用哪种方案,保持 MEMORY.md 精简都是最重要的——一条记忆一行摘要。 这个知识点你学废了吗?想解锁更多 AI 硬核知识,点赞关注,我是二哥,咱们下期见!
在 GitHub 上编辑此页 上次编辑于: 贡献者: 沉默王二 上一页 Claude Code 长期记忆 下一页 CLAUDE.md 写法