


Claude Code 的长期记忆是怎么实现的? 沉默王二 原创 AI 面试 AI Agent 面试题 Claude Code 长期记忆 CLAUDE.md 约 969 字 大约 3 分钟 AI的药,绝不能停 #027 你想不想知道 Claude Code 的长期记忆是怎么实现的? AI Agent 面试题 Claude Code 长期记忆 CLAUDE.md WATCH / 抖音视频 在抖音打开 王二讲Agent 每天3分钟,带你吃透Agent。 你不想?哦不,你想,你必须想。😄 对于 AI 来说,短期记忆就像是电脑内存里的数据,关机就没了。那聪明的你肯定想到了,长期记忆不会是存在磁盘上的文件吧?每次打开 Claude Code 的时候自动加载? 还真是。 那 Claude Code 具体是怎么做的?文件存在哪?长什么样?怎么加载的? 我自己研究过Claude Code的源码,并从零到一手搓了一个终端Agent,名叫 PaiCLI,就开源在GitHub上,所以可以自信地、大方地、光明磊落地帮你搞清楚这三件事: 长期记忆存在哪里,长什么样? 记忆是怎么被记住的? 下次打开新对话,记忆是怎么加载回来的?
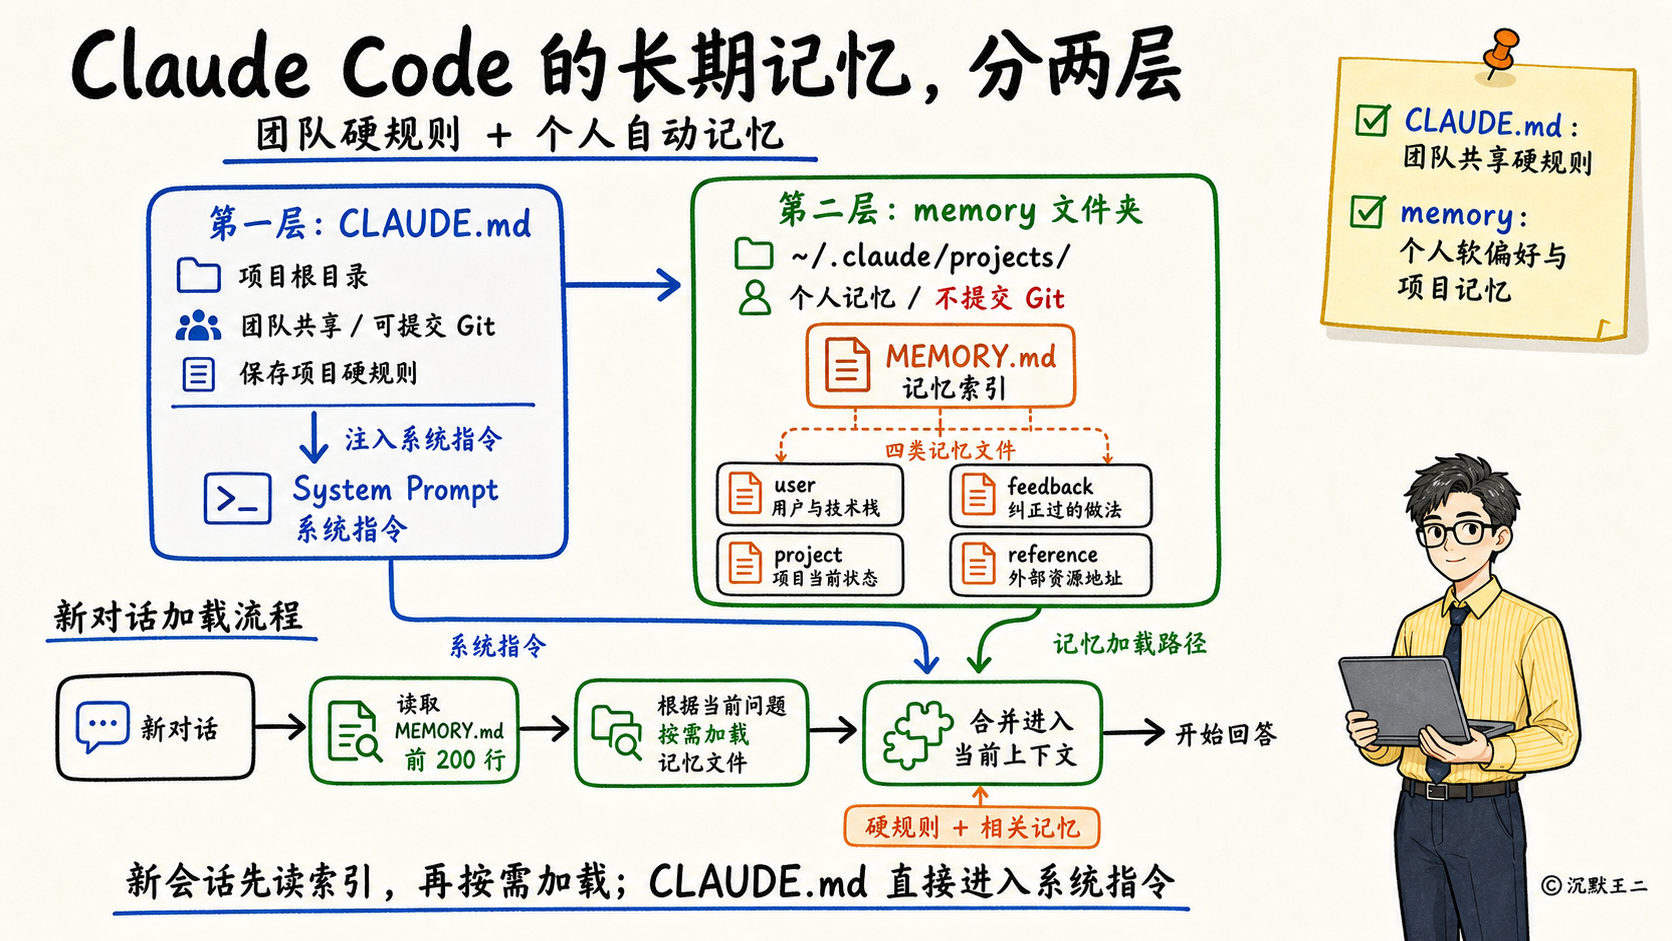
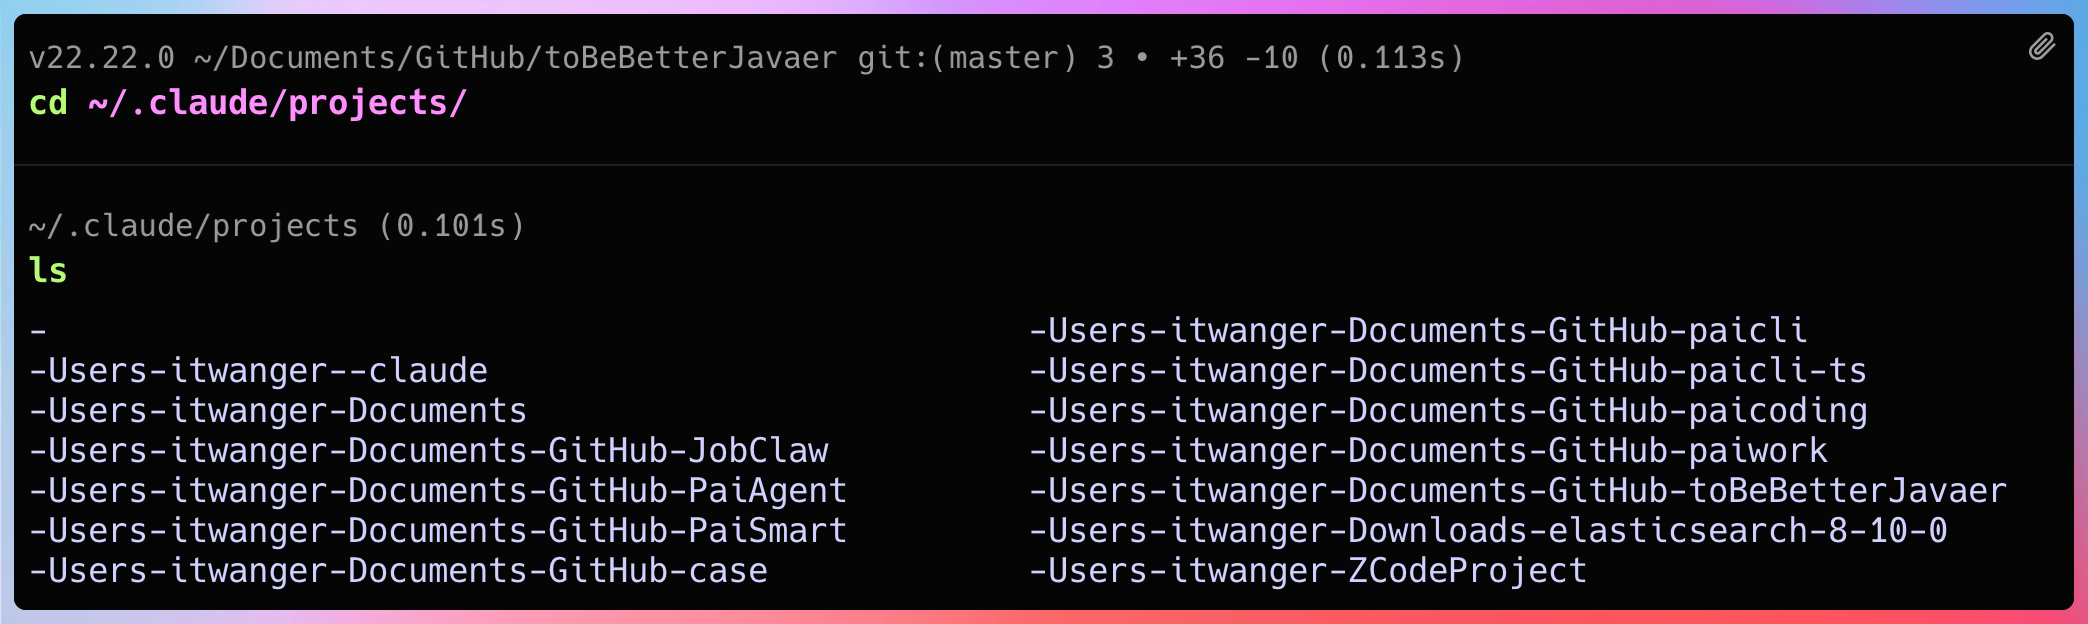
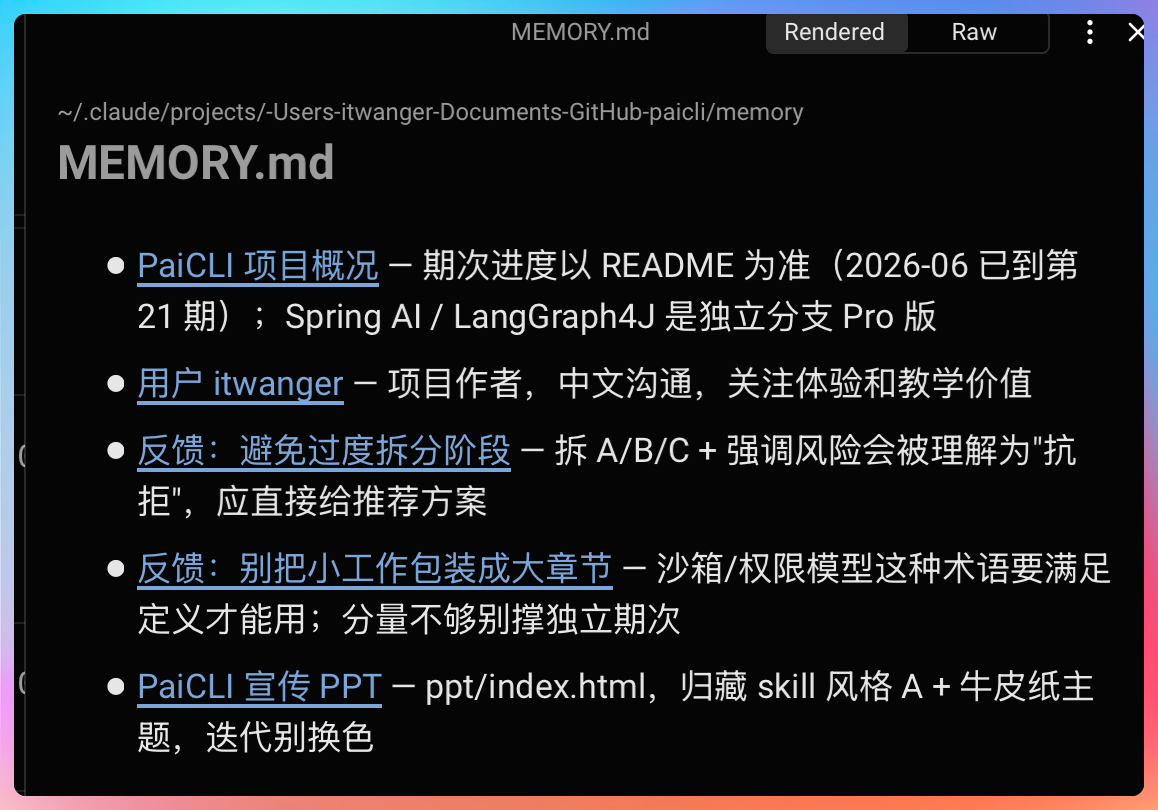
哈喽大家好,我是二哥呀。今天用 3 分钟,给你讲清楚 Claude Code 的长期记忆是怎么实现的。 先说第一件事,长期记忆存在哪里,长什么样。 Claude Code 的长期记忆分两层。 第一层是 CLAUDE.md。这是你自己写的项目规则文件,放在项目根目录下,可以提交到 Git,整个团队共享。比如你在里面写"用 4 空格缩进""禁止使用 var""数据库用 PostgreSQL",每个团队成员打开 Claude Code 都能读到这些规则。 第二层是 memory 文件夹。它藏在 ~/.claude/projects/ 下面,是 Claude Code 自动帮你记的,属于你个人,不会提交到 Git。
这个文件夹里有一个 MEMORY.md 索引文件,加上一堆独立的记忆文件。每个记忆文件的开头写标题、描述和类型,下面是具体内容。
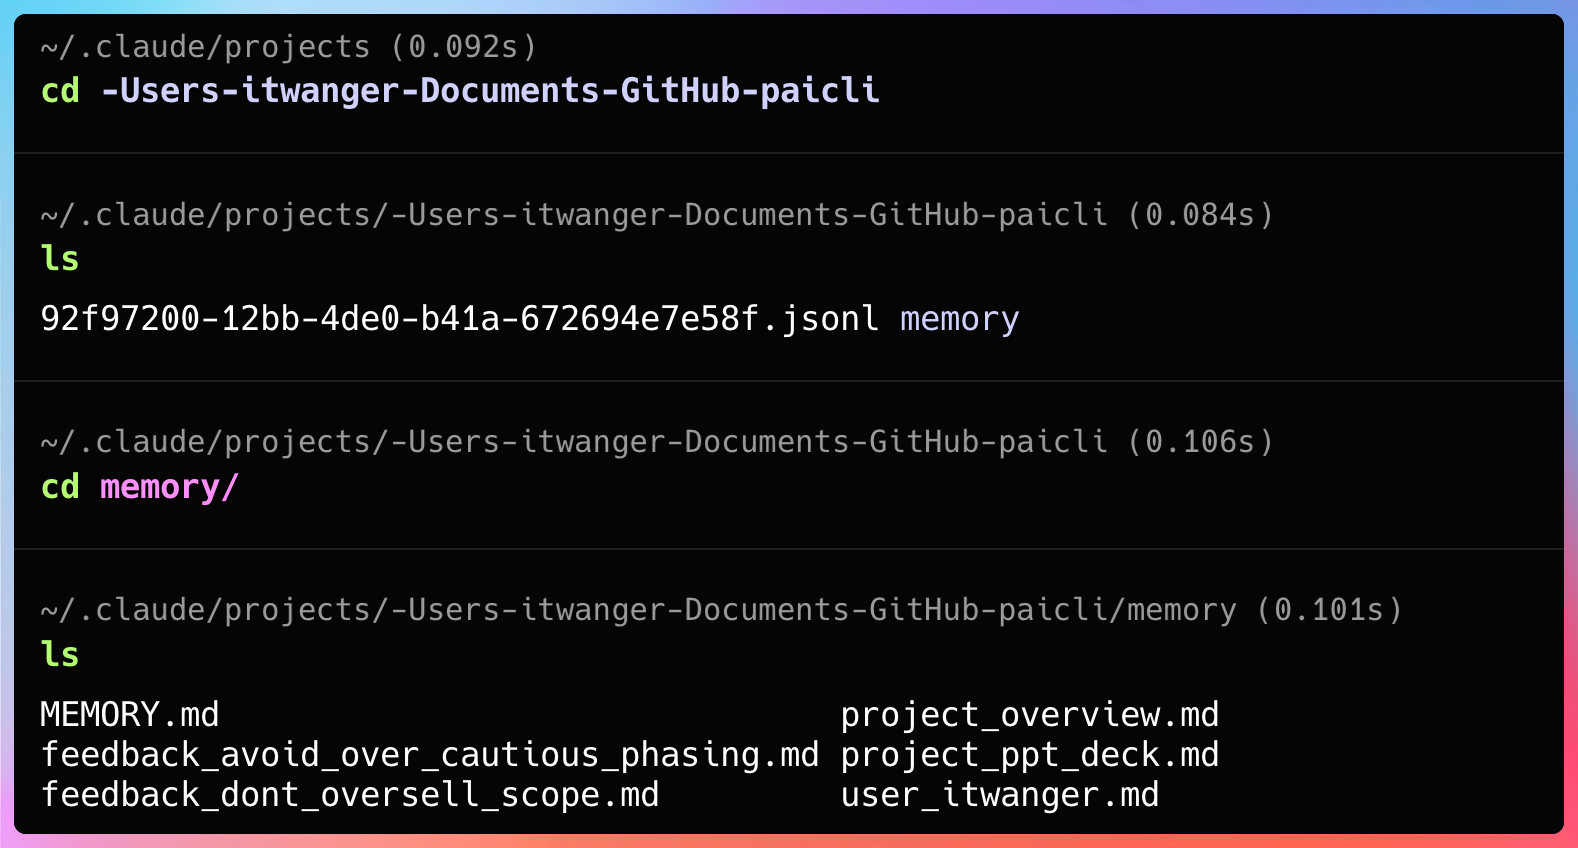
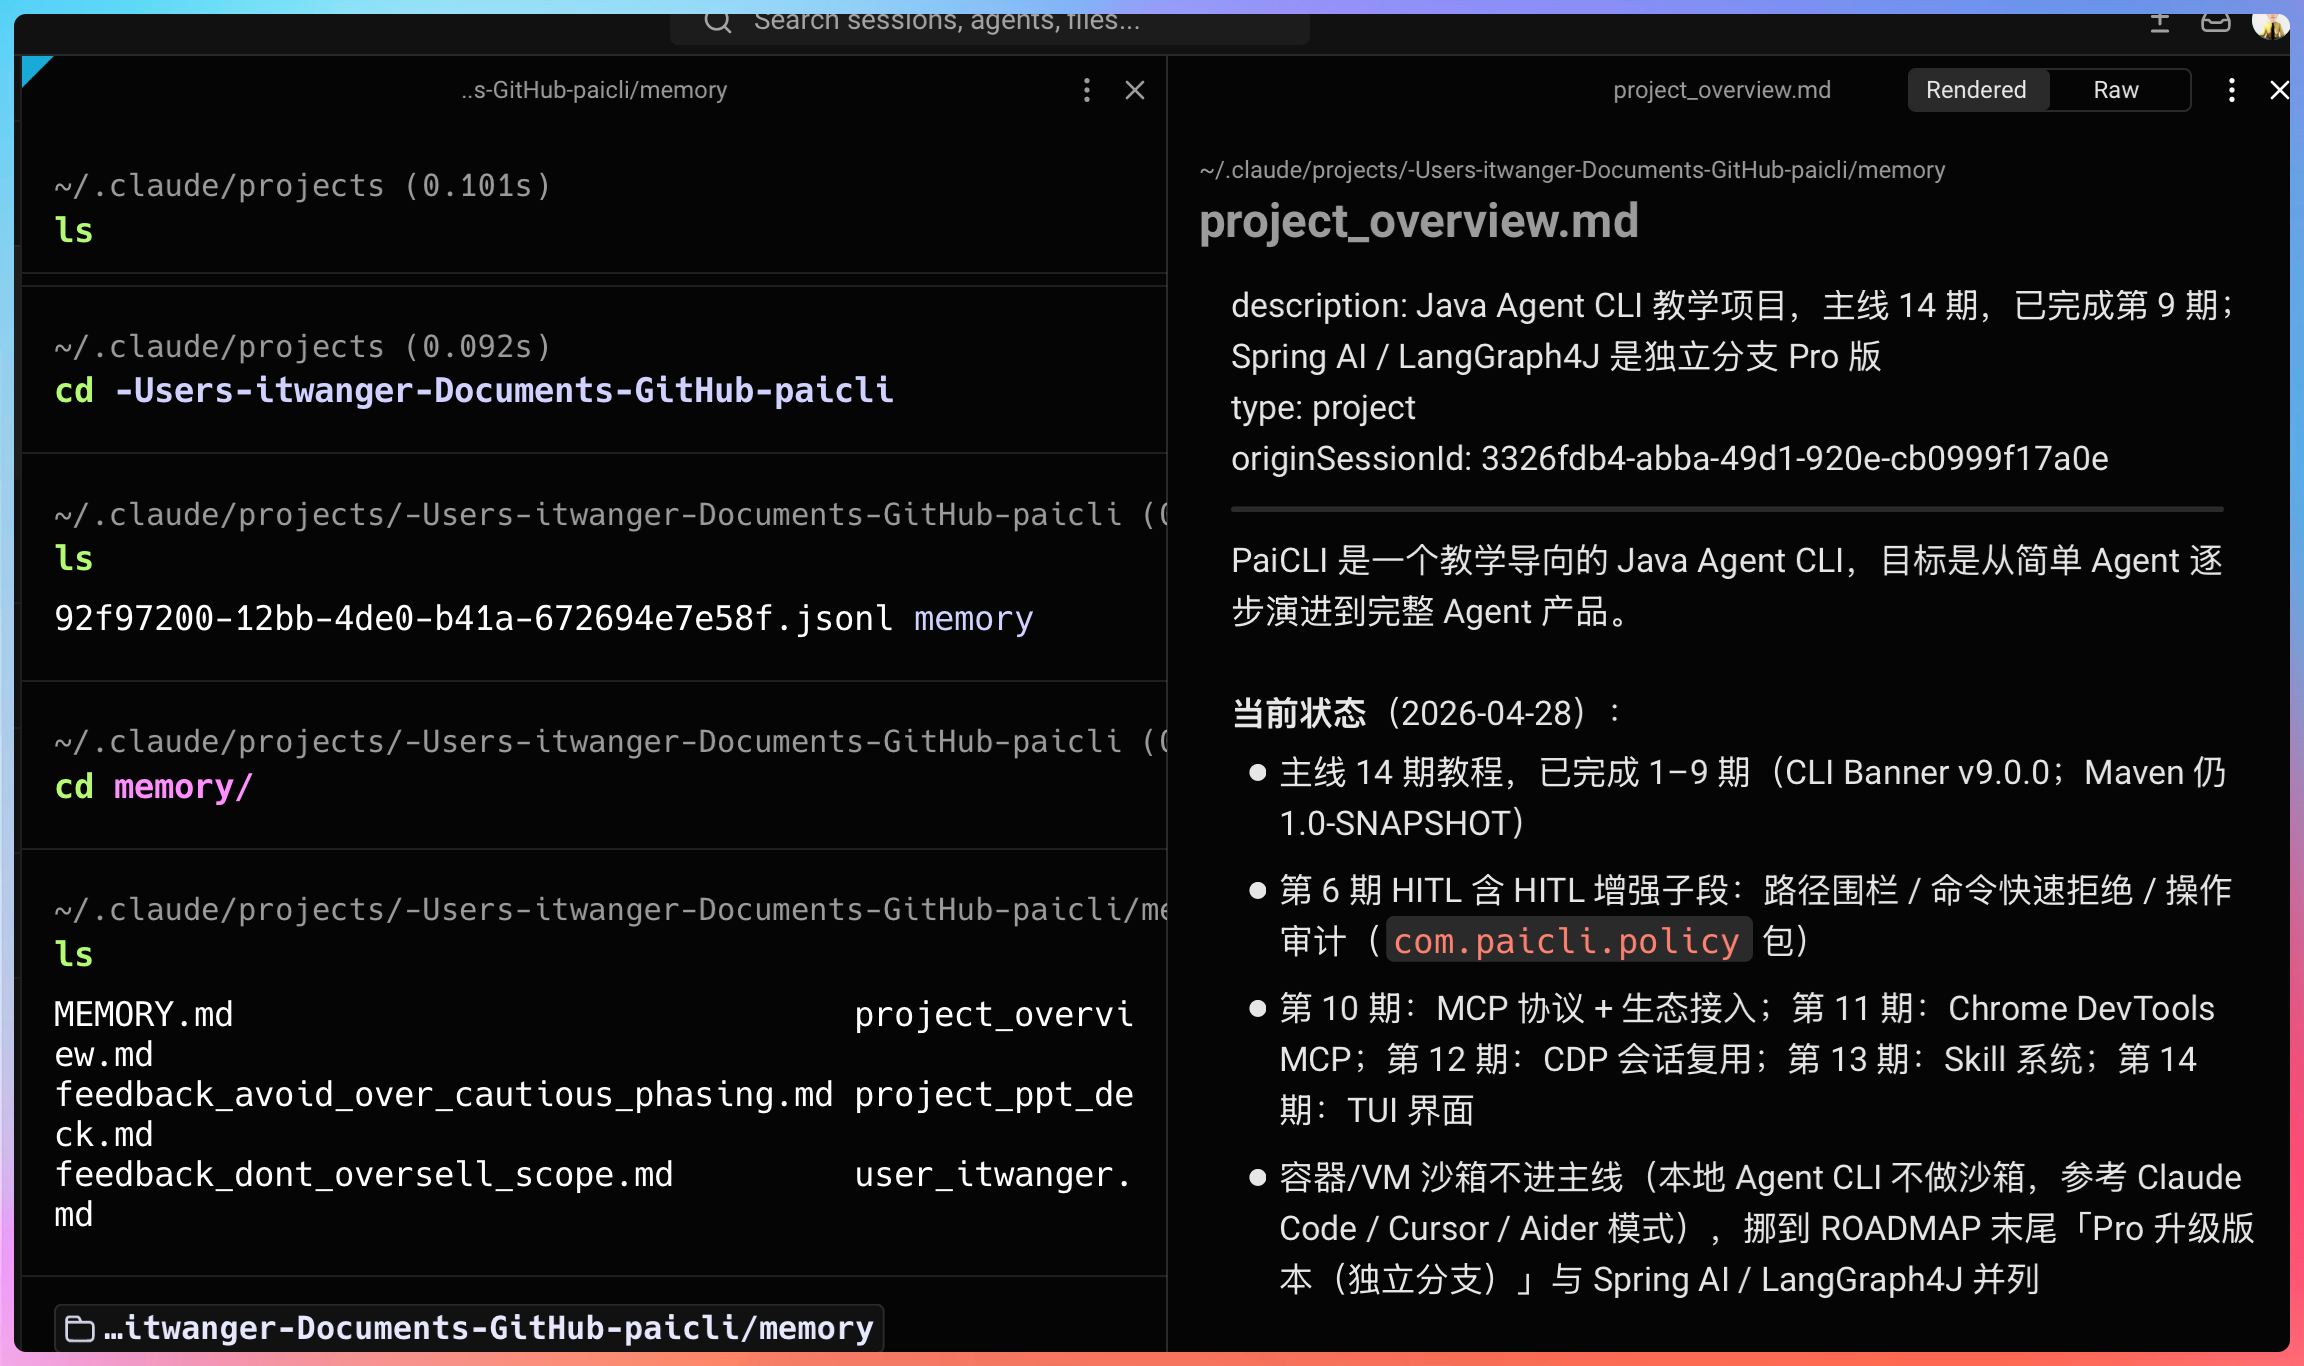
记忆分四种类型:user,记录你是谁、你的技术栈;feedback,记录你纠正过的做法;project,记录项目当前的状态;reference,记录外部资源的地址。 那聪明的你肯定想到了:这些记忆是怎么被存进去的? 两种方式。自动和手动。 自动的情况是,你写代码的时候,Claude Code 会自己判断哪些信息值得长期保留,悄悄帮你存下来。比如你说"别用 Lombok,这个项目不用",它就自动存一条 feedback 类型的记忆,下次你再开新对话,它就不会再给你生成 Lombok 的代码了。 手动的情况是,你直接告诉它"记住:测试用 JUnit 5,不要用 JUnit 4",它立刻存。 两种方式存出来的格式一样,都是带 frontmatter 的 Markdown 文件。 那聪明的你肯定又要问了:存是存了,下次打开新对话,它怎么知道去哪里找? 每次新开一个对话,Claude Code 会自动去读 MEMORY.md 这个索引文件,最多读前 200 行。通过索引知道有哪些记忆之后,再按需加载具体的记忆文件。
CLAUDE.md 更特殊。它直接注入到系统指令里,上下文压缩的时候永远不会被丢掉。所以团队必须遵守的硬规则,一定要写在 CLAUDE.md 里。个人的软偏好,交给 auto memory 就行。 最后简单总结下。 Claude Code 的长期记忆分两层:CLAUDE.md 是你自己写的硬性规则,memory 文件夹是 Claude Code 帮你记的个人偏好。另外,新项目第一件事建议先写 CLAUDE.md,把技术栈、代码规范、禁忌项写清楚,能省掉后面大量的重复沟通。 这个知识点你学废了吗?想解锁更多 AI 硬核知识,点赞关注,我是二哥,咱们下期见!
在 GitHub 上编辑此页 上次编辑于: 贡献者: 沉默王二 上一页 Claude Code 短期记忆 下一页 Claude Code 记忆检索