


为什么聊着聊着 Agent 就变笨了? 沉默王二 原创 AI 面试 AI Agent 面试题 Context Rot 上下文污染 Agent 退化 约 1040 字 大约 3 分钟 AI的药,绝不能停 #021 你有没有遇到过这种情况:用 Claude Code 或者 Codex 干活,前面还好好的,后面突然开始犯蠢——明明说过的事它又问你一遍,明明强调的细节它又忘了,明明之前读过的文件它又读一遍? AI Agent 面试题 Context Rot 上下文污染 Agent 退化 WATCH / 抖音视频 在抖音打开 王二讲Agent 每天3分钟,带你吃透Agent。 是 Agent 变傻了吗? 不不不,他没傻,只是忘了。 而且这不是 bug,是所有 Agent 都绕不开的一个现实问题。前两期我们讲了 Claude Code 和 Codex 的短期记忆机制,今天有必要讲一讲: 为什么 Agent 聊着聊着就变傻了? 摘要压缩到底丢了什么? 怎么做才能让 Claude Code 或者 Codex 尽量少忘事?
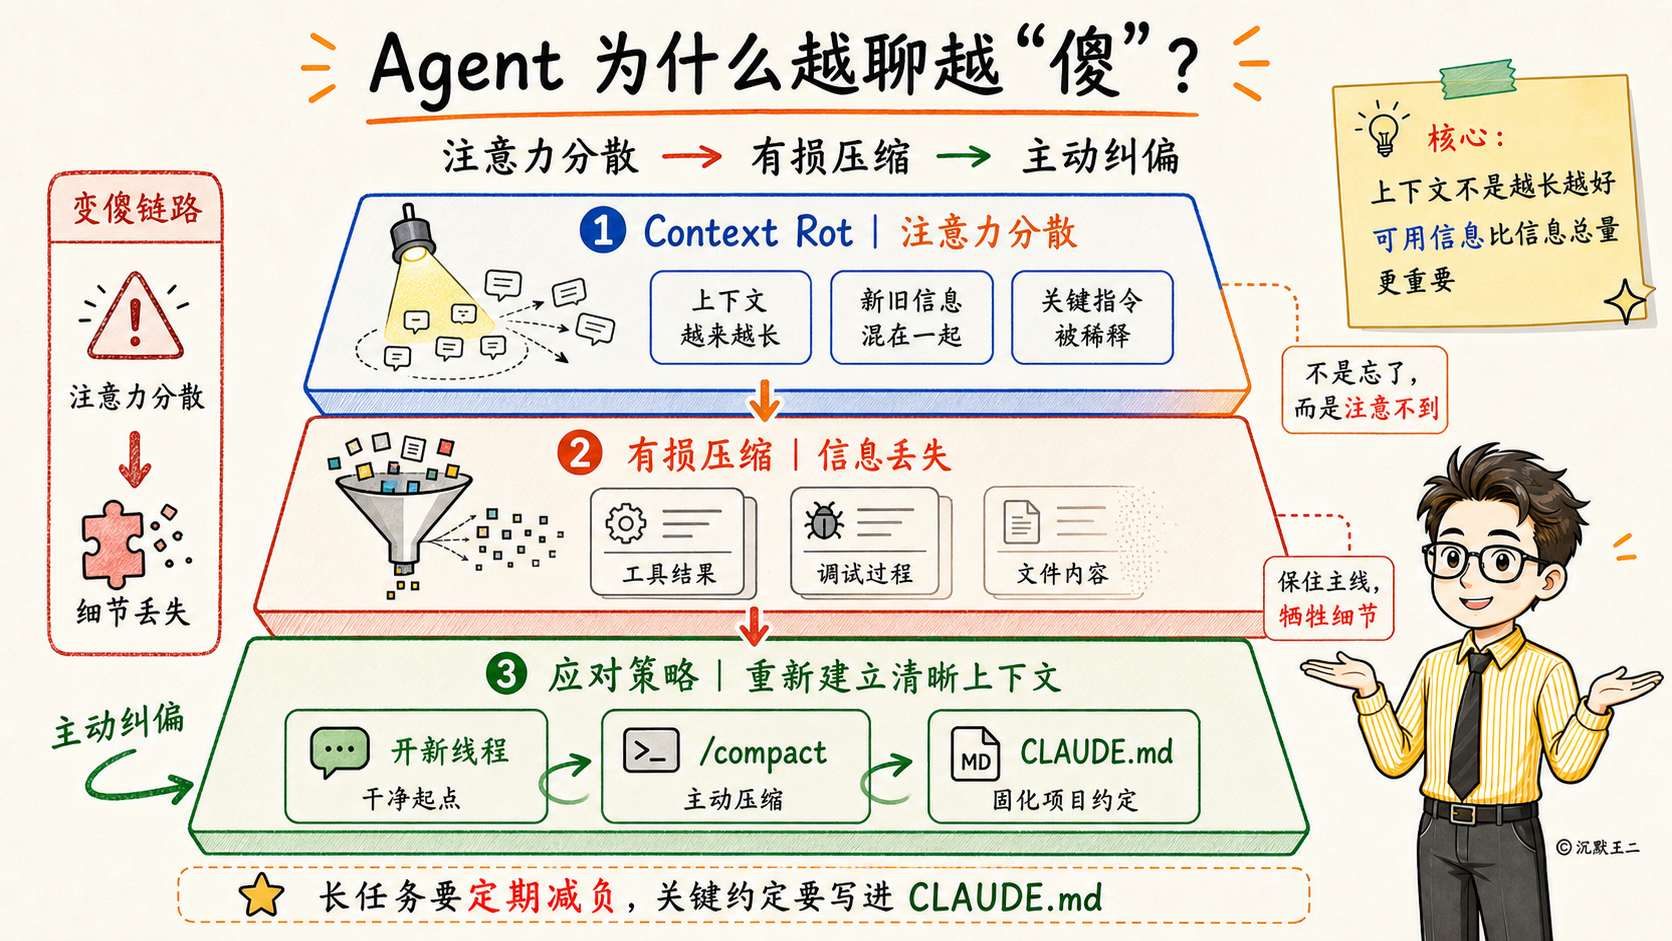
哈喽大家好,我是二哥呀。今天用 3 分钟,给你讲清楚为什么 Agent 聊着聊着就变傻了。 先说第一个,为什么会变傻。 前两期说过,不管是 Claude Code 还是 Codex,短期记忆都是靠重发聊天记录来实现的。你发一句,Agent 就记一句。你让它读文件,文件的内容就记进去。你让它跑命令,命令的结果也记进去。 聊着聊着,这份记录就变得非常非常非常长。 问题来了。模型的注意力是有限的。就像你桌子上摆了 1000 本书,但你同一时间真正能看的,还是眼前那几本。桌子越大书越多,找书反而越慢。 这个现象有个工程上的名字,叫 Context Rot,也就是上下文腐烂。 而且记录不能无限长,上下文窗口是有上限的。快满的时候,Agent 会自动触发压缩,把旧的聊天记录压缩成一份摘要。 但压缩是有损的。 那聪明的你肯定想到了:压缩到底丢了什么? Claude Code 这边,工具返回的长结果会被丢掉。比如你让它搜代码,搜出来 500 行,压缩后可能只剩一句"搜索了 XX 文件"。中间的调试过程、早期的对话细节,也会被压缩成几句话的摘要。 Codex 这边更狠。上期讲过,它的压缩结果是加密的,你根本看不到里面保留了什么。而且文件内容压缩后可能直接没了,所以 Codex 经常重新搜索、重新读取同样的文件。 最要命的是,压缩可能不止发生一次。你聊得越久,压缩的次数就越多。每压一次丢一点,就像复印件的复印件,越印越模糊,俗称包浆。 那聪明的你肯定又要问了:有没有办法让它少忘事? 有,三条实操建议。 第一,一个线程只干一件事。针对 Codex,改完 bug 就开新线程,别接着在同一个线程里写文档、跑测试。线程越短,压缩越少,忘得灸越少。 第二,主动压缩。Claude Code 有个命令叫 /compact,你可以在聊到一半的时候主动触发。而且后面可以跟一句话,告诉它该保留什么。比如 /compact 重点保留数据库设计,调试过程可以丢弃。主动压缩比被动触发效果更好,因为这时候记录还比较干净,生成的摘要质量更高。 当然你也可以使用 /clear 这条命令,如果有你 Skill,重新清空上下文后,让 Claude Code 从干净的上下文开始帮你重新干活,Fable 5 的 1 兆上下文窗口足够你干完一件长程任务。 第三,把重要信息写进 CLAUDE.md 或者 AGENTS.md。这些文件的内容属于系统指令,不会被压缩。不管你的聊天记录压了多少次,系统指令永远在。 最后简单总结下。 Agent 变傻不是 bug,是压缩带来的信息损耗。记住三条:一个线程干一件事,主动 /compact 和 /clear,重要规则写进 CLAUDE.md。 这个知识点你学废了吗?想解锁更多 AI 硬核知识,点赞关注,我是二哥,咱们下期见!
在 GitHub 上编辑此页 上次编辑于: 贡献者: 沉默王二 上一页 避免上下文爆炸 下一页 LLM 为什么没记忆