


为什么越来越多人用MapStruct_ 作者: 苏三 2026-08-03 技术文章 前言 最近缺项目经历想快速提升项目实战能力(包含多个AI项目),或者最近找工作,或者想学习AI的小伙伴,可以看看下面👇🏻的 这个链接 (或许真的能够帮到你)。 从BeanUtils到MapStruct,Java对象映射的一次性能革命 前几天帮一个团队做性能优化,发现了一个非常典型的场景——他们的订单服务CPU使用率经常飙到85%以上,响应时间从50ms暴涨到300ms。 我一看火焰图,热点竟然集中在对象映射上。 就是那些看起来人畜无害的 BeanUtils.copyProperties() 调用。 在高并发场景下,反射带来的性能开销被无限放大了。 后来他们把对象映射从BeanUtils换成了MapStruct,CPU使用率直接降到了30%,响应时间回到了50ms以内。 这不是个例。 MapStruct正在成为越来越多Java项目的标配。 今天这篇文章,我就把MapStruct为什么这么火的原因,从头到尾给你拆解一遍。 希望对你会有所帮助。 一、对象映射到底有什么难的? 有些小伙伴可能会说:“对象映射不就是把A对象的字段赋值给B对象吗?有什么难的?” 如果你这么想,说明你还没被真实项目的复杂度毒打过。 在Java分层架构中,对象映射几乎无处不在: Controller层接收VO → 转换成DTO传给Service Service层使用DTO → 转换成Entity存进数据库 Repository层操作Entity → 查询结果转成DTO返回给前端 每层都有自己的数据模型,每层之间都需要转换。 在MapStruct出现之前,Java Bean映射主要有两种方案,各有明显的短板: 第一种:手写getter/setter
// 手动映射——又臭又长
UserDTO userDTO = new UserDTO();
userDTO.setId(user.getId());
userDTO.setName(user.getName());
userDTO.setAge(user.getAge());
userDTO.setEmail(user.getEmail());
// ... 如果有20个字段,就写20行
一个对象十几个字段,写一两个还好,一旦嵌套了几层对象,代码又臭又长,还特别容易出错。 第二种:BeanUtils反射拷贝
// 一行代码搞定,看起来很爽
BeanUtils.copyProperties(user, userDTO);
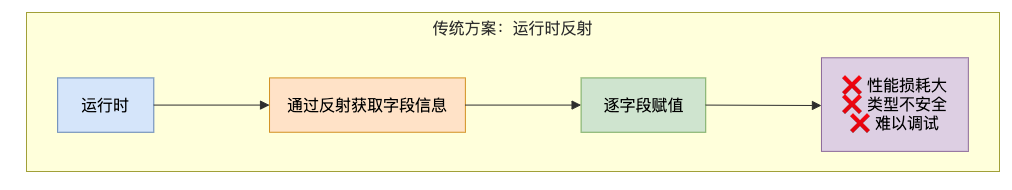
代码写起来确实爽,但你知道这背后发生了什么吗? 每次调用都会通过反射获取类的字段信息,进行类型检查,然后逐个赋值。 在每秒处理几千个对象转换的高并发场景下,反射调用次数直接爆表。 而且 BeanUtils.copyProperties() 的异常处理机制——它会悄悄地吞掉转换失败的字段,你压根不知道数据丢了。 那有没有一种方案,既有手写代码的性能,又有BeanUtils的便捷? 有。MapStruct。 二、MapStruct到底是什么? MapStruct是一个Java注解处理器,用于在 编译时 自动生成类型安全、高性能的对象映射代码。 你只需要定义一个接口,告诉它“把A变成B”,它就会在项目编译时,自动生成一个实现了这个接口的类,里面包含了所有字段映射的代码。 核心优势一句话总结:编译期生成代码,运行时零反射。
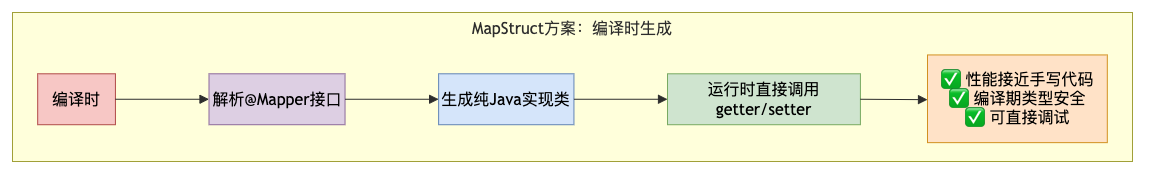
三、底层原理 有些小伙伴可能会好奇:“MapStruct到底是怎么做到又方便又快的?” 这得从它的底层原理说起。 3.1 基于JSR 269的注解处理器 MapStruct的核心是一个 注解处理器(Annotation Processor) ,它基于 JSR 269 规范实现。 JSR 269是Java提供的一个API,允许开发者在编译期介入,分析带有特定注解的Java类,并根据这些注解生成新的代码。 MapStruct在 javac 编译阶段的工作流程是这样的:

3.2 生成的代码长什么样? 这是关键。我们来看一个实际的例子。 你定义的接口:
@Mapper(componentModel = "spring")
public interface UserMapper {
 UserDTO userToUserDTO(User user);
}
MapStruct编译后生成的实现类:
@Component
public class UserMapperImpl implements UserMapper {
 @Override
 public UserDTO userToUserDTO(User user) {
 if (user == null) {
 return null;
 }
 UserDTO userDTO = new UserDTO();
 userDTO.setId(user.getId());
 userDTO.setName(user.getName());
 userDTO.setAge(user.getAge());
 // ... 其他字段直接赋值
 return userDTO;
 }
}
看到了吗?生成的代码就是最原始的getter/setter调用,跟你手写的一模一样 。 3.3 为什么反射这么慢? 反射的性能问题主要来自三个方面: 方法查找开销 :每次调用都需要通过字符串名称查找Method对象 安全检查成本 :每次调用都要验证访问权限 优化限制 :JIT难以对反射调用进行内联等优化 简单来说:反射调用无法被JVM优化,而直接的方法调用可以被JIT编译���内联优化成极高效的机器码。 MapStruct在编译期就完成了所有这些查找工作,生成的代码就像开发者手写的一样直接 。 四、性能对比 光说理论不够,我们看实测数据。 4.1 1000次对象转换测试 有人在本地做了一组性能测试,映射1000次对象: 工具 耗时 性能对比 手写映射 0.04秒 基准 MapStruct 0.05秒 接近手写 BeanUtils 2.3秒 慢46倍 MapStruct的性能几乎等同于手写代码,比BeanUtils快了 46倍 ! 4.2 为什么MapStruct这么快? 我们来看一个更细粒度的对比: 操作类型 平均耗时(ns) 可内联性 JIT优化空间 直接方法调用 1-2 高 大 反射调用 50-100 无 极小 MapStruct生成代码 1-2 高 大 直接方法调用和MapStruct生成的代码是一个量级 ——1-2纳秒。而反射调用是50-100纳秒,慢了 50-100倍 。 最近缺项目经历想快速提升项目实战能力(包含多个AI项目),或者最近找工作,或者想学习AI的小伙伴,可以看看下面👇🏻的 这个链接 (或许真的能够帮到你)。 在每秒处理数千个对象转换的高并发场景下,这个差距会被无限放大。 4.3 为什么首次调用慢、后续快? 很多人发现BeanUtils第一次调用慢,后面就快了。 这是因为JVM的JIT编译器会对热点代码进行优化。 但即便如此,反射的“天花板”依然很低——JIT无法将反射调用内联优化成直接方法调用。 而MapStruct从一开始就是直接方法调用,没有这个“预热”过程,也没有性能上限。 五、从零开始用MapStruct 光说不练假把式。 下面我带你从零开始,在Spring Boot项目里集成MapStruct。 5.1 第一步:添加依赖 打开 pom.xml ,添加MapStruct核心库和注解处理器:
<properties>
 <org.mapstruct.version>1.6.3</org.mapstruct.version>
</properties>

<dependencies>
 <!-- MapStruct核心库 -->
 <dependency>
 <groupId>org.mapstruct</groupId>
 <artifactId>mapstruct</artifactId>
 <version>${org.mapstruct.version}</version>
 </dependency>
</dependencies>

<build>
 <plugins>
 <plugin>
 <groupId>org.apache.maven.plugins</groupId>
 <artifactId>maven-compiler-plugin</artifactId>
 <version>3.11.0</version>
 <configuration>
 <annotationProcessorPaths>
 <!-- MapStruct注解处理器 -->
 <path>
 <groupId>org.mapstruct</groupId>
 <artifactId>mapstruct-processor</artifactId>
 <version>${org.mapstruct.version}</version>
 </path>
 <!-- 如果用了Lombok,必须放在MapStruct前面 -->
 <path>
 <groupId>org.projectlombok</groupId>
 <artifactId>lombok-mapstruct-binding</artifactId>
 <version>0.2.0</version>
 </path>
 <path>
 <groupId>org.projectlombok</groupId>
 <artifactId>lombok</artifactId>
 <version>1.18.30</version>
 </path>
 </annotationProcessorPaths>
 </configuration>
 </plugin>
 </plugins>
</build>
新手常踩的坑 :你不仅需要添加MapStruct的核心库,还必须配置它的注解处理器。只有这样,Maven在编译时才能找到它并生成代码。 Lombok兼容性 :如果项目同时使用了Lombok,必须把Lombok的注解处理器放在MapStruct 前面 ,否则Lombok生成的getter/setter还没生成,MapStruct就找不到。 5.2 第二步:定义实体和DTO
// 实体类
@Data
public class User {
 private Long id;
 private String userName;
 private Integer userAge;
 private String email;
 private LocalDateTime createTime;
}

// DTO类
@Data
public class UserDTO {
 private Long id;
 private String name;
 private Integer age;
 private String email;
 private LocalDateTime createTime;
}
5.3 第三步:定义Mapper接口
import org.mapstruct.Mapper;
import org.mapstruct.Mapping;
import org.mapstruct.factory.Mappers;

@Mapper(componentModel = "spring")
public interface UserMapper {

 UserMapper INSTANCE = Mappers.getMapper(UserMapper.class);

 // 基础映射:字段名不同时用@Mapping指定
 @Mapping(source = "userName", target = "name")
 @Mapping(source = "userAge", target = "age")
 UserDTO userToUserDTO(User user);

 // 反向映射
 @Mapping(source = "name", target = "userName")
 @Mapping(source = "age", target = "userAge")
 User userDTOToUser(UserDTO userDTO);

 // 集合映射
 List<UserDTO> usersToUserDTOs(List<User> users);
}
componentModel = "spring" :让生成的实现类自动带上 @Component 注解,可以在Spring中通过 @Autowired 注入。 5.4 第四步:在Service中使用
@Service
public class UserService {

 @Autowired
 private UserMapper userMapper;

 public UserDTO getUserDTO(Long id) {
 User user = userRepository.findById(id).orElse(null);
 // 一行代码搞定映射
 return userMapper.userToUserDTO(user);
 }

 public List<UserDTO> getUserDTOList() {
 List<User> users = userRepository.findAll();
 // 集合映射也是一行
 return userMapper.usersToUserDTOs(users);
 }
}
编译后 ,MapStruct会在 target/generated-sources/annotations/ 目录下生成 UserMapperImpl.java 文件。 你可以直接打开看生成的代码,跟手写的一模一样。 六、进阶用法 6.1 字段名不一致 用 @Mapping 注解指定:
@Mapping(source = "userName", target = "name")
@Mapping(source = "userAge", target = "age")
UserDTO userToUserDTO(User user);
6.2 自定义转换逻辑 在Mapper接口中定义 default 方法:
@Mapper(componentModel = "spring")
public interface OrderMapper {

 @Mapping(source = "user.name", target = "userName")
 @Mapping(source = "items", target = "itemCount", qualifiedByName = "itemsToCount")
 OrderDTO orderToOrderDTO(Order order);

 @Named("itemsToCount")
 default int itemsToCount(List<OrderItem> items) {
 return items != null ? items.size() : 0;
 }
}
6.3 使用Java表达式
@Mapping(target = "createTime", expression = "java(java.time.LocalDateTime.now())")
UserVO userToUserVO(User user);
6.4 嵌套对象映射 当源对象和目标对象包含嵌套对象时,MapStruct同样可以处理。只需要为嵌套对象也定义对应的映射方法,MapStruct会自动调用。 6.5 忽略某些字段
@Mapping(target = "password", ignore = true)
UserDTO userToUserDTO(User user);
七、优缺点 优点 1. 性能极高,接近手写代码 MapStruct在编译期生成纯Java getter/setter调用代码,无任何反射开销。性能比BeanUtils快 46倍 。 2. 编译期类型安全 MapStruct在编译时就能发现属性类型不匹配、缺失映射方法等问题。例如,尝试将String映射到LocalDate而没有提供转换器,编译会直接失败。不会出现“代码跑起来才报错”的尴尬。 3. 可调试性强 生成的实现类是标准的Java源文件,你可以像阅读自己写的代码一样阅读、调试它。反射映射像一个黑盒,难以追踪问题根源。 4. 功能丰富且灵活 支持嵌套对象映射、集合映射、自定义类型转换器、表达式、条件映射、默认值设置、异常处理等复杂场景。 5. 低侵入性 无需修改目标Bean类,仅通过接口+注解配置映射规则,符合开闭原则。 6. 与Spring生态无缝集成 通过 componentModel = "spring" 可以让生成的实现类自动成为Spring Bean,通过 @Autowired 注入使用。 7. 支持Java 16+ Records MapStruct支持Java 16引入的Records类型。 8. 无运行时依赖 生成的代码是自包含的,不需要任何运行时依赖。 缺点 1. 学习成本略高 相比一行 BeanUtils.copyProperties() ,MapStruct需要定义接口、配置注解处理器、学习 @Mapping 等注解的用法。 2. 需要额外配置构建工具 必须配置 annotationProcessorPaths ,否则MapStruct不会生成代码。 3. 与Lombok的兼容性问题 如果Lombok和MapStruct的注解处理器顺序配置不对,可能导致MapStruct找不到Lombok生成的getter/setter。 4. 简单场景“杀鸡用牛刀” 对于只有两三个字段的简单对象转换,引入MapStruct可能显得过于重量级。 八、适用场景 场景 推荐程度 理由 Spring Boot分层架构项目 ✅✅✅ 强烈推荐 DTO/VO/Entity转换无处不在 高并发/高性能要求场景 ✅✅✅ 强烈推荐 性能接近手写代码,无反射开销 微服务间数据模型转换 ✅✅✅ 强烈推荐 类型安全,编译期发现问题 复杂嵌套对象映射 ✅✅✅ 强烈推荐 原生支持嵌套和集合映射 长期维护的大型项目 ✅✅✅ 强烈推荐 可读性强、可调试、易维护 简单临时转换 ⚠️ 不推荐 BeanUtils更简单 九、写在最后 回到最初的问题: 为什么越来越多人使用MapStruct? 答案其实很简单—— 因为它解决了对象映射这个高频场景下的核心矛盾:既要快,又要方便,还要安全。 BeanUtils 虽然用起来方便,但反射带来的性能损耗在高并发场景下会被无限放大。而且它偷偷吞掉异常的行为,可能让你在不知不觉中丢失数据。 手写getter/setter 虽然性能最好,但代码冗余、容易出错、维护困难。 MapStruct 走了一条“第三条路”—— 编译时生成代码,运行时零反射 。 你只需要定义接口,MapStruct帮你生成手写级别的代码。 在Spring Boot项目里,对象映射的需求无处不在。 在稍微复杂点的项目里,MapStruct能帮你减少至少 30%的样板代码 ,而且因为映射关系是声明式的(用注解),代码的可读性和可维护性也大大提升。 开源地址 GitHub :https://github.com/mapstruct/mapstruct 官方文档 :https://mapstruct.org 最近缺项目经历想快速提升项目实战能力(包含多个AI项目),或者最近找工作,或者想学习AI的小伙伴,可以看看下面👇🏻的 这个链接 (或许真的能够帮到你)。