


为什么越来越多人用RustFS_ 作者: 苏三 2026-08-13 技术文章 前言 最近缺项目经历想快速提升项目实战能力(包含多个AI项目),或者最近找工作,或者想学习AI的小伙伴,可以看看下面👇🏻的 这个链接 (或许真的能够帮到你)。 最近这段时间,我的技术圈子几乎被同一个项目刷屏了—— RustFS 。 2026年7月20日,RustFS的GitHub Star数正式越过 30,000 大关——从第一行核心代码提交算起,只用了 383天 。 DockerHub镜像下载量突破 220万次 ,八次登上GitHub Trending总榜首位,Rust榜榜首超过40次。 作为一个2024年才立项的年轻项目,社区热度已经压过了Ceph、PostgreSQL这些跑了几十年的老牌基础设施。 很多小伙伴跑来问我:“三哥,这个RustFS到底是什么?为什么突然这么火?越来越多的人在用” 今天这篇文章就专门跟大家一起聊聊RustFS,希望对你会有所帮助。 一、RustFS到底是什么? 1.1 一句话说清 RustFS是一个用Rust语言开发的高性能分布式对象存储系统,100%兼容S3协议,采用Apache 2.0许可证开源 。 它的定位非常清晰—— 做MinIO的开源平替 。 但它的野心不止于此:专为数据湖、AI训练和大数据负载进行了深度优化。 1.2 为什么它突然这么火? MinIO曾经是自托管S3兼容对象存储的“默认答案”。 但从2021年开始,MinIO将开源协议由Apache 2.0调整为 AGPLv3 ,并叠加商业双许可。 AGPLv3有个“网络使用即分发”条款:只要你把MinIO作为网络服务对外提供,哪怕只改了一个配置文件,理论上都得开源你的整个代码栈。 对商业公司来说,这几乎是“劝退级”条款。 再加上2025年5月MinIO删掉了社区版的Console管理控制台,2026年2月又宣布永久停止维护开源仓库——社区彻底炸了。 RustFS正好接住了这个市场缺口 。 它用Apache 2.0协议,对商业公司极其友好;用Rust语言重写,内存安全无GC,性能和稳定性全面超越。 二、一张图看懂RustFS的整体架构 在动手部署之前,我们先建立整体认知。
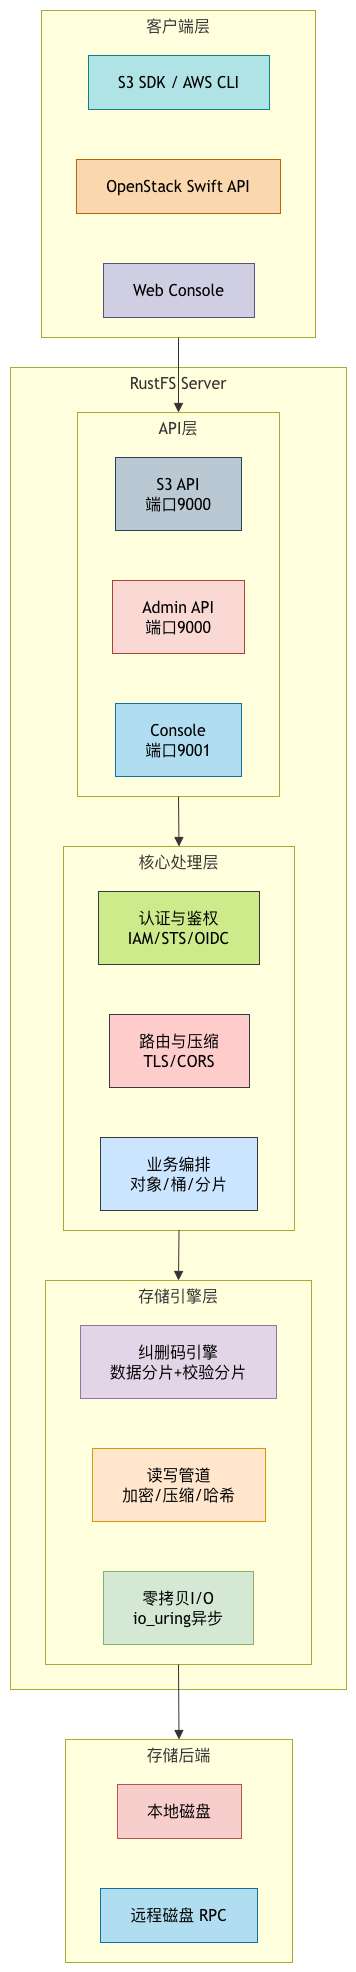
RustFS采用 去中心化的点对点架构,所有节点都是平等的 。 这和传统的分布式存储架构完全不同——传统架构必须有Master节点、MetaData节点和Data Node节点,部署极其复杂。 而RustFS没有中心节点,一条命令就能启动。 架构灵感来源于MinIO的简洁、轻量和可扩展设计,但在底层实现上用Rust彻底重写了。 2.1 四个核心概念 概念 说明 Object(对象) RustFS存储的基本单元,可以是文件、字节流等任何非结构化数据 Bucket(桶) 存储对象的逻辑容器,不同桶之间数据隔离 Drive(磁盘) 物理存储磁盘,所有对象数据最终存储在Drive上 Set(集合) 一组Drive的集合,一个对象存储在一个Set上 一个对象存储在一个Set上;一个集群划分为多个Set;每个Set包含的Drive数量是固定的,由系统根据集群规模自动计算。 三、5分钟跑起来 RustFS支持Linux、macOS、Windows三种操作系统,以及二进制安装、Docker、Helm Charts等多种部署方式。 新手最推荐Docker方式 。 3.1 方式一:Docker一键部署(推荐) 这是最快、最省心的方式。单条命令启动:
docker run -d \
 --name rustfs \
 -p 9000:9000 \
 -p 9001:9001 \
 -v $(pwd)/data:/data \
 -v $(pwd)/logs:/logs \
 rustfs/rustfs:latest
参数说明: -p 9000:9000 ���映射S3 API端口 -p 9001:9001 :映射控制台端口 -v $(pwd)/data:/data :数据持久化目录 -v $(pwd)/logs:/logs :日志目录 用Docker Compose的方式更规范:
# docker-compose.yml
services:
 rustfs:
 image: rustfs/rustfs:latest
 container_name: rustfs-server
 ports:
 - "9000:9000"
 - "9001:9001"
 volumes:
 - ./data:/data
 - ./logs:/logs
 environment:
 - RUSTFS_ROOT_USER=admin
 - RUSTFS_ROOT_PASSWORD=admin123
 restart: unless-stopped
启动服务:
docker-compose up -d
3.2 方式二:二进制安装 RustFS官方提供了一键安装脚本:
curl -O https://rustfs.com/install_rustfs.sh && bash install_rustfs.sh
安装完成后,直接运行:
rustfs server --address :9000 --console-address :9001 /data
3.3 验证安装 启动后,在浏览器打开控制台地址: http://localhost:9001 使用环境变量中配置的用户名和密码登录。 登录后就可以创建存储桶、上传文件了。 四、核心操作:创建桶和上传文件 4.1 通过Web控制台操作 登录控制台(http://localhost:9001) 点击 “Create Bucket” 创建存储桶 输入桶名称,点击创建 进入桶,点击 “Upload” 上传文件 4.2 通过AWS CLI操作 RustFS 100%兼容S3协议,所有S3工具都可以直接使用。 配置AWS CLI连接RustFS:
aws configure
# Access Key ID: 你的AccessKey
# Secret Access Key: 你的SecretKey
# Default region: us-east-1

# 配置endpoint
aws configure set s3.endpoint http://localhost:9000
创建桶:
aws s3 mb s3://my-bucket
上传文件:
aws s3 cp test.txt s3://my-bucket/
列出文件:
aws s3 ls s3://my-bucket/
五、底层原理 有些小伙伴可能会好奇:“RustFS到底凭什么比MinIO快?” 这个问题问到点子上了。 RustFS的性能优势不是营销话术,而是 底层架构的硬实力 。 5.1 读写流程 写入流程 : 客户端上传文件 → 负载均衡 → 元数据校验 → 纠删码编码(数据分片 + 计算校验分片)→ 并行写入多个节点 读取流程 : 客户端请求文件 → 元数据定位 → 只需读取任意4个分片(数据或校验均可)→ 还原原始文件 5.2 两大底层武器
最近缺项目经历想快速提升项目实战能力(包含多个AI项目),或者最近找工作,或者想学习AI的小伙伴,可以看看下面👇🏻的 这个链接 (或许真的能够帮到你)。
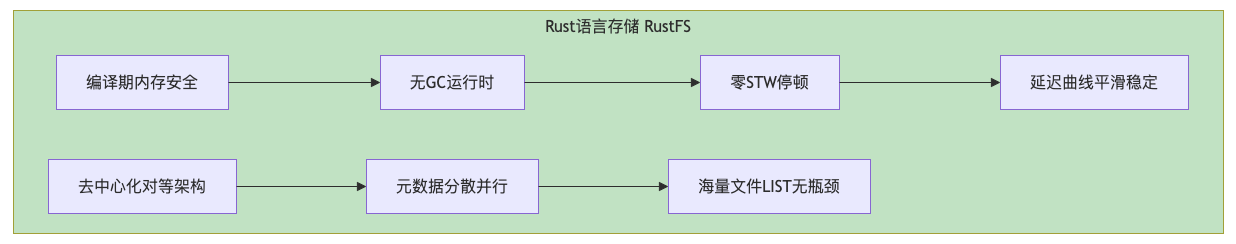
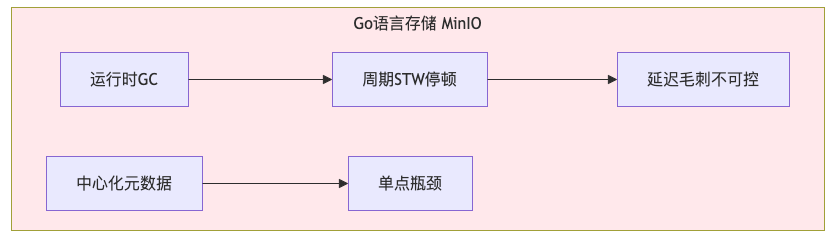
武器一:无GC运行时,彻底消除STW停顿 MinIO基于Go语言,依赖运行时GC自动回收内存。 在海量小文件并发读写场景下,GC会周期性触发 Stop-The-World全局停顿 ,造成不可控的延迟毛刺。 Rust依靠所有权、借用检查、生命周期机制,在 编译阶段完成全部内存安全校验 。 程序运行阶段 不存在垃圾回收线程 ,不会出现任何全局停顿。 这正是RustFS在碎片化文件负载下碾压MinIO的根本原因 。 武器二:去中心化对等架构,消除元数据瓶颈 传统分布式存储依赖中心化的元数据节点,所有LIST请求都要经过它。 在海量小文件场景下,元数据节点会成为性能瓶颈。 RustFS采用去中心化点对点架构, 所有节点都是平等的 。 元数据分散在所有节点上并行检索,从底层消解了元数据瓶颈。 六、把RustFS接入你的后端 作为Java后端开发者,你肯定需要把RustFS接入业务系统。 RustFS完全兼容S3协议,直接用AWS SDK Java就能操作。 6.1 添加依赖
<dependency>
 <groupId>software.amazon.awssdk</groupId>
 <artifactId>s3</artifactId>
 <version>2.25.0</version>
</dependency>
6.2 配置客户端
import software.amazon.awssdk.auth.credentials.AwsBasicCredentials;
import software.amazon.awssdk.auth.credentials.StaticCredentialsProvider;
import software.amazon.awssdk.regions.Region;
import software.amazon.awssdk.services.s3.S3Client;
import software.amazon.awssdk.services.s3.S3Configuration;

import java.net.URI;

public class RustFSClient {

 public static S3Client createClient() {
 // 配置访问凭证
 AwsBasicCredentials credentials = AwsBasicCredentials.create(
 "你的AccessKey",
 "你的SecretKey"
 );

 // 配置S3客户端
 return S3Client.builder()
 .region(Region.US_EAST_1)
 .endpointOverride(URI.create("http://localhost:9000"))
 .credentialsProvider(StaticCredentialsProvider.create(credentials))
 // 关闭路径风格访问(使用虚拟主机风格)
 .serviceConfiguration(S3Configuration.builder()
 .pathStyleAccessEnabled(true)
 .build())
 .build();
 }
}
6.3 创建桶
import software.amazon.awssdk.services.s3.model.CreateBucketRequest;
import software.amazon.awssdk.services.s3.model.HeadBucketRequest;
import software.amazon.awssdk.services.s3.model.S3Exception;

public void createBucket(S3Client s3Client, String bucketName) {
 try {
 // 检查桶是否已存在
 s3Client.headBucket(HeadBucketRequest.builder()
 .bucket(bucketName)
 .build());
 System.out.println("桶已存在: " + bucketName);
 } catch (S3Exception e) {
 if (e.statusCode() == 404) {
 // 创建桶
 s3Client.createBucket(CreateBucketRequest.builder()
 .bucket(bucketName)
 .build());
 System.out.println("桶创建成功: " + bucketName);
 }
 }
}
6.4 上传文件
import software.amazon.awssdk.core.sync.RequestBody;
import software.amazon.awssdk.services.s3.model.PutObjectRequest;
import java.io.File;

public void uploadFile(S3Client s3Client, String bucketName,
 String key, File file) {
 PutObjectRequest request = PutObjectRequest.builder()
 .bucket(bucketName)
 .key(key)
 .build();

 s3Client.putObject(request, RequestBody.fromFile(file));
 System.out.println("文件上传成功: " + key);
}
6.5 下载文件
import software.amazon.awssdk.core.ResponseInputStream;
import software.amazon.awssdk.services.s3.model.GetObjectRequest;
import java.nio.file.Files;
import java.nio.file.Path;
import java.nio.file.Paths;

public void downloadFile(S3Client s3Client, String bucketName,
 String key, String savePath) {
 GetObjectRequest request = GetObjectRequest.builder()
 .bucket(bucketName)
 .key(key)
 .build();

 try (ResponseInputStream<GetObjectRequest> response =
 s3Client.getObject(request)) {
 Files.copy(response, Paths.get(savePath));
 System.out.println("文件下载成功: " + savePath);
 } catch (Exception e) {
 e.printStackTrace();
 }
}
6.6 列出文件
import software.amazon.awssdk.services.s3.model.ListObjectsV2Request;
import software.amazon.awssdk.services.s3.model.ListObjectsV2Response;
import software.amazon.awssdk.services.s3.model.S3Object;

public void listFiles(S3Client s3Client, String bucketName) {
 ListObjectsV2Request request = ListObjectsV2Request.builder()
 .bucket(bucketName)
 .maxKeys(100)
 .build();

 ListObjectsV2Response response = s3Client.listObjectsV2(request);

 System.out.println("桶 " + bucketName + " 中的文件:");
 for (S3Object object : response.contents()) {
 System.out.println(" - " + object.key() +
 " (大小: " + object.size() + " bytes)");
 }
}
代码逻辑拆解 : 创建S3Client时, endpointOverride 指向RustFS的API地址(端口9000) pathStyleAccessEnabled(true) 让RustFS使用路径风格访问( http://localhost:9000/bucket/key ) 所有操作都通过标准S3 API,与AWS S3的代码完全一致 从MinIO迁移到RustFS, Java代码一行都不用改 ——只需要改endpoint配置 七、实测对比 2026年6月,一份基于DuckDB、DuckLake、Iceberg三引擎的权威基准测试报告发布。 7.1 小文件场景:2.3倍碾压 指标 MinIO RustFS 提升 4KB小文件读写 基准 2.3倍 🚀 在4KB对象负载下, RustFS速度是MinIO的2.3倍 。 7.2 Iceberg数据湖:延迟低2~8倍 这是RustFS优势最突出的场景: 指标 MinIO RustFS 提升 1MB小文件写入P50 0.412s 0.116s 3.5倍 1MB文件变更检测 0.505s 0.060s 8.4倍 7.3 Winner Scorecard:7/10维度第一 综合评分体系划分10大性能维度: RustFS:7个维度排名第一 LibreFS:2个维度领先 MinIO:仅1个维度领先 RustFS在Iceberg负载延迟比MinIO低2~8倍 ,优势赛道集中在 数据湖、OLAP分析、湖仓事务、并发混合读写 。 注意 :32MB大文件场景下,三者差距显著收窄。 RustFS的核心优势集中在 碎片化文件负载 ——这恰恰是AI训练和湖仓场景最典型的负载。 八、优缺点 优点 1. 性能碾压 4KB小文件场景下速度是MinIO的 2.3倍 ,Iceberg负载延迟比MinIO低 2~8倍 。 2. 零GC停顿 Rust无GC运行时,彻底消除STW延迟毛刺,性能曲线始终平滑稳定。 3. 内存占用极低 精准内存管控完胜Go语言GC架构,集群资源利用率大幅提升。 4. 商业友好 Apache 2.0协议,可自由使用、修改、商业集成。 5. 原生AI优化 专为AI训练和推理场景设计,S3 Table原生支持全量数据湖特性。 6. 去中心化架构 无单点瓶颈,元数据检索效率随节点增加线性提升。 7. 云原生就绪 提供Docker镜像、Helm Charts和K8s Operator。 8. 多协议支持 除S3外,原生支持OpenStack Swift API和Keystone认证。 缺点 1. 尚处Beta阶段 当前最新版本为1.0.0-beta.12,预计2026年9月发布GA版本。 2. 功能尚在完善中 分布式模式、生命周期管理等功能正在开发中。 3. 大文件场景优势不明显 32MB大文件场景下,与竞品差距显著收窄。 4. 工具链生态不完善 周边客户端、可视化工具、第三方集成丰富度不如MinIO。 5. 生产验证案例有限 作为年轻项目,大规模生产环境的验证案例还不够多。 九、适用场景 场景 推荐程度 理由 AI模型训练/推理存储 强烈推荐 4KB小文件性能碾压 Iceberg数据湖 强烈推荐 元数据操作延迟低2~8倍 信创国产化改造 强烈推荐 Apache 2.0协议商业友好 对内存敏感的场景 强烈推荐 内存占用比MinIO低60%以上 MinIO协议焦虑团队 强烈推荐 100% S3兼容 边缘计算/轻量部署 推荐 Rust二进制轻量、资源占用低 核心生产环境 需评估 等GA版本发布后再上 32MB+大文件场景 需评估 大文件优势不明显 十、写在最后 回到最初的问题: RustFS是什么?为什么突然这么火? 答案其实不复杂—— RustFS用Rust重写了对象存储,在一个被忽视的领域里,把性能和资源效率做到了极致 。 MinIO自己把路走窄了 ——AGPLv3劝退了商业公司,删掉Console让开源版“毛坯化”,永久停止维护开源仓库更是最后一击。 RustFS精准接住了这个市场缺口 ——Apache 2.0商业友好、无GC零停顿、内存占用大幅降低、4KB小文件2.3倍碾压、Iceberg负载延迟低2~8倍。 383天从0到30k Star 不是运气,是技术实力和市场需求的双重验证。 RustFS也有自己的短板——Beta阶段、大文件场景优势不明显、工具链生态还在完善中。 但对于 AI训练、数据湖、信创改造 这些场景来说,它已经是一个非常值得认真评估的选项。 我的建议是 :如果你正在做AI训练存储选型,或者正在被MinIO的协议问题困扰, 花一个下午把RustFS跑一遍 。 Docker一键部署、AWS SDK无缝对接、S3协议完全兼容——你会发现,对象存储的格局,正在被Rust改写。 开源地址 GitHub :https://github.com/rustfs/rustfs 中文文档 :https://docs.rustfs.com.cn 官方网站 :https://rustfs.com 最近缺项目经历想快速提升项目实战能力(包含多个AI项目),或者最近找工作,或者想学习AI的小伙伴,可以看看下面👇🏻的 这个链接 (或许真的能够帮到你)。