


突发,DeepSeek V4 Pro正式发布了 作者: 苏三 2026-08-14 AI DeepSeek 前言 最近缺项目经历想快速提升项目实战能力(包含多个AI项目),或者最近找工作,或者想学习AI的小伙伴,可以看看下面👇🏻的 这个链接 (或许真的能够帮到你)。 就在昨天凌晨—— 2026年8月13日 ,DeepSeek官方悄悄干了一件大事。
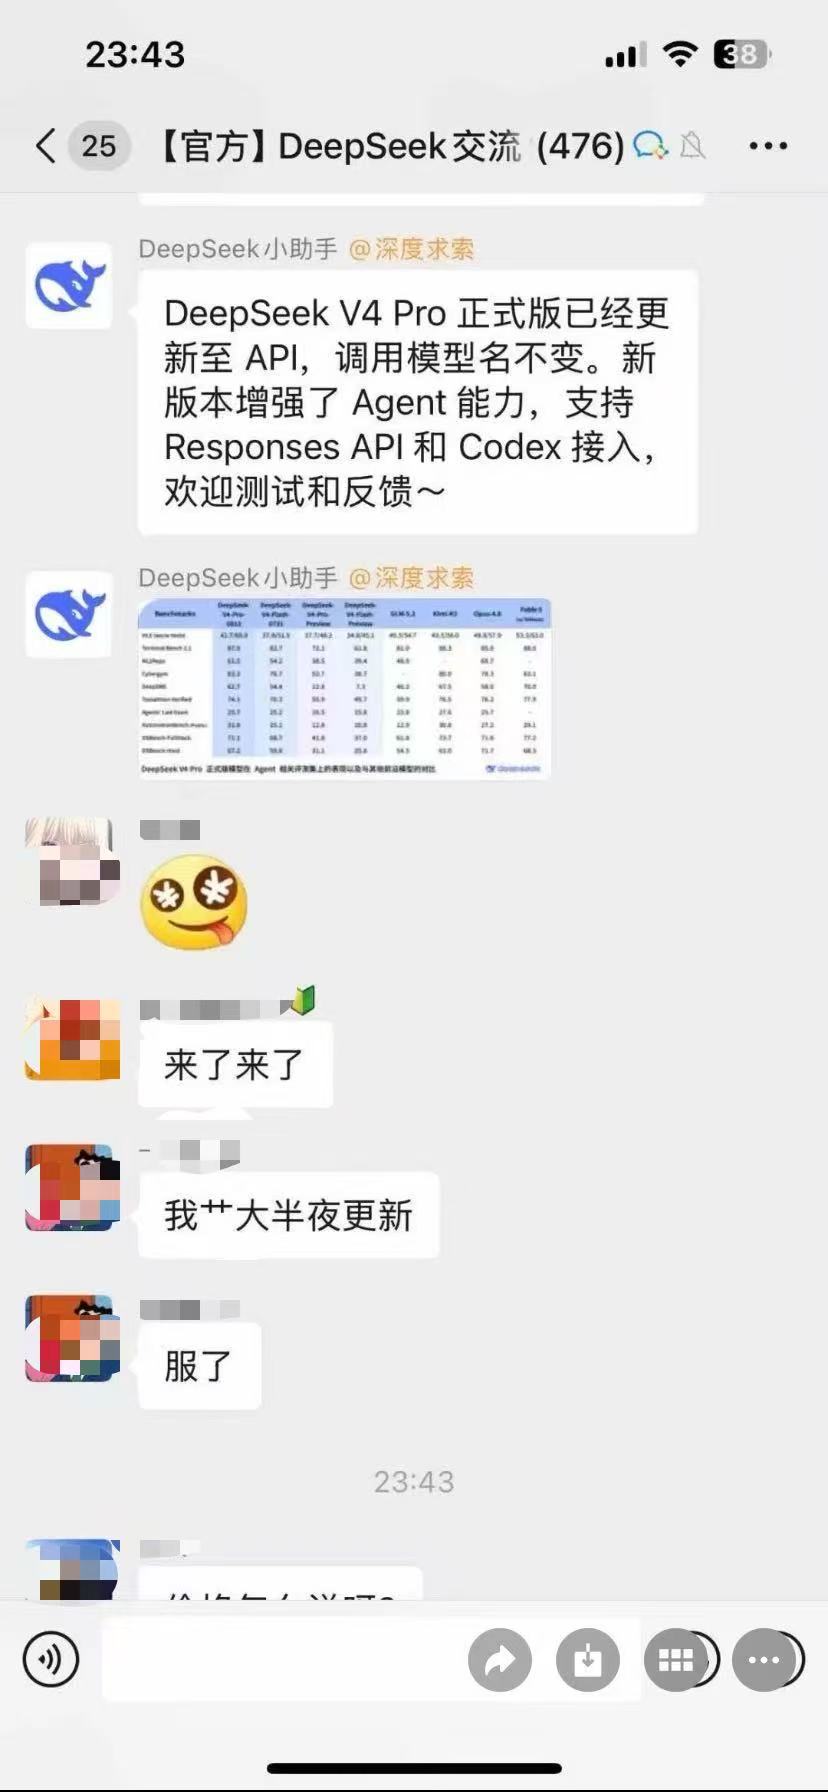
他们把DeepSeek V4 Pro 从预览版正式转正 了。 官方定价页上,模型版本号已经更新为 DeepSeek-V4-Pro-0813 。 消息传出来的时候,我正好在刷技术群。 群里直接就炸了——大家都在问同一个问题: 预览版已经那么强了,正式版还能强到哪里去? 从官方流出的评测对比表来看,DeepSeek V4 Pro正式版在多项测试中 接近Anthropic的Fable 5水平 ,相比之前的预览版能力大幅提升。 这不仅是DeepSeek的一次“版本转正”,更是 开源大模型第一次正面硬刚闭源旗舰 。 今天这篇文章,我就把DeepSeek V4 Pro从技术架构到实战用法,从头到尾给你拆解一遍。 希望对你会有所帮助。 一、什么是DeepSeek V4 Pro? 2026年4月24日,DeepSeek正式发布了第四代旗舰模型系列,包括两个版本: 对比维度 DeepSeek V4 Pro DeepSeek V4 Flash 总参数 1.6T(1.6万亿) 284B(2840亿) 激活参数 49B (490亿) 13B (130亿) 激活比例 ~3.06% ~4.58% 预训练数据 33T tokens 32T tokens 上下文长度 1M tokens 1M tokens 最大输出 384K tokens 384K tokens 开源协议 MIT(可商用) MIT(可商用) 核心架构 MoE + Engram + mHC + DSA MoE + Engram + mHC + DSA 定位 旗舰性能,对标闭源天花板 快捷经济,兼顾推理与速度 V4-Pro是V4系列 最大的模型 ,拥有1.6万亿总参数和490亿激活参数。 V4-Flash则是一个更小、更快的经济版。 最重要的是——两个版本均采用MIT协议开源,商用零门槛 。 用一句话总结: V4-Pro是“智力天花板”,V4-Flash是“性价比之王” 。 二、DeepSeek V4 Pro的核心能力 在聊技术细节之前,我先用三个关键词帮你建立整体认知。 关键词一:1M上下文,开箱即用 V4系列最直观的升级就是 上下文从128K直接拉到1M ,实现了近10倍的容量提升。 1M tokens什么概念? 一次性能处理三部《三体》的体量 ——百万字小说、论文、合同、代码库,不用分段、不丢信息。 而且这不是“实验室数据”,是 官方服务全线标配 ——你调用API,默认就是1M上下文。 关键词二:万亿参数,只激活3% V4-Pro总参数1.6T,但每次推理 只激活约49B(3%)的参数 。 1.6T的参数池承载了海量知识,但推理时只激活需要的部分, 性能和成本之间取得了极致平衡 。 这背后是 MoE(混合专家)架构 ——把一个大模型拆成数千个“专家”,每次只激活其中64个专家来处理当前任务。 关键词三:开源模型,首次硬刚闭源旗舰 V4 Pro在 SWE-bench Verified (衡量真实工程问题解决能力的权威基准)上拿到了 80.6% ,是目前 开源权重模型中最高分 ,与Gemini 3.1 Pro持���。 作为对比:Claude Opus 4.7是87.6%,GPT-5.5是88.7%。 开源和闭源的差距,从十多个百分点被压缩到了7个百分点以内 。 而在编程和推理的某些细分维度上,V4 Pro已经能跟闭源旗舰掰手腕了。 三、V4 Pro凭什么这么强? 有些小伙伴可能会问:“1.6T参数听起来很唬人,但具体是怎么做到的?” V4 Pro的强,不是简单的“参数堆砌”,而是 一场通过四大核心技术驱动的系统性革命 。 3.1 MoE(混合专家):万亿参数的“智能路由” MoE是V4系列实现超大规模模型的 关键技术 。 核心思想是:将一个巨大的稠密模型拆分成多个“专家”子网络,引入一个“门控网络”来动态决定—— 对于每个输入Token,应该激活哪些专家 。 V4-Pro包含数千个专家,但每次前向传播 仅路由并激活其中64个专家(总计49B参数) 。 这带来的��接效果是:1.6T的总参数承载了海量知识,但推理计算量只相当于49B的模型 。 不同的任务可以激活不同的专家组合,实现更专业的处理能力。 3.2 混合注意力架构:破解长上下文的“算力诅咒” 上下文长了,算力消耗会指数级增长。V4系列用了一套 全新的混合注意力架构 来解决这个问题。 这套架构包含两大组件: CSA(压缩稀疏注意力) ——“算什么”:先把每4个token的KV cache压缩成1个entry,再在压缩后的序列上做稀疏注意力。 HCA(重度压缩注意力) ——“存什么”:进行更极致的压缩,维持稠密计算的同时大幅降低存储开销。 再配合 DSA(DeepSeek Sparse Attention)稀疏注意力 技术——模型不再对所有token做全量attention计算,而是 智能判断哪些token真正重要,只对这些“关键区域”分配计算资源 。 效果有多夸张? 在百万Token上下文场景下, V4-Pro的单Token推理FLOPs降至DeepSeek-V3.2的27%,KV缓���占用仅为10% 。 3.3 国产算力:华为昇腾全面适配 V4系列还有一个特别值得关注的点—— 首发即适配华为昇腾 。 昇腾A2、A3及950全系列产品均已完成对DeepSeek V4系列模型的适配。 基于昇腾950超节点, DeepSeek V4-Pro可实现20ms低时延推理 ,在8K输入场景下单卡Decode吞吐达 4700 TPS 。 这意味着什么? 国产大模型+国产算力,已经可以跑出世界级的推理性能。 最近缺项目经历想快速提升项目实战能力(包含多个AI项目),或者最近找工作,或者想学习AI的小伙伴,可以看看下面👇🏻的 这个链接 (或许真的能够帮到你)。 底层从CUDA迁移至华为CANN异构计算架构,下半年昇腾950批量量产后,吞吐和成本将进一步优化。 四、V4 Pro到底有多能打? 我们把V4 Pro的各项指标整理成了下面这张表: 基准测试 DeepSeek V4 Pro 对比模型 说明 SWE-bench Verified 80.6% Claude Opus 4.7: 87.6% 开源最高,与Gemini 3.1 Pro持平 LiveCodeBench 93.5% — 竞赛代码通过率 Codeforces评分 3206 — 算法竞赛水平 GPQA Diamond 90.1% — 科学推理 MMLU-Pro 87.5% — 知识推理 HumanEval 89.2% GPT-5.5: 88.7% 代码生成 Terminal-Bench 2.0 67.9% — 终端Agent任务 几个特别值得关注的点 : 编程能力 :V4 Pro在SWE-bench Verified上拿到 80.6% ,是目前开源权重模型的 最高分 。Codeforces评分 3206 ,在算法竞赛维度上甚至反超了部分闭源旗舰。 推理能力 :在HumanEval上达到 89.2% ,超过了GPT-5.5的88.7%。 Agent能力 :在Agentic Coding评测中达到开源模型 最佳水平 ,已成为DeepSeek 内部默认编码模型 ,实测体验优于Sonnet 4.5,交付质量接近Opus 4.6非思考模式。 五、三步接入DeepSeek V4 Pro DeepSeek API兼容OpenAI格式,Java调用非常简单。 5.1 第一步:获取API Key 访问DeepSeek开放平台:https://platform.deepseek.com,注册账号并创建API Key。 5.2 第二步:添加依赖(Maven) 推荐使用 OkHttp (轻量高性能)配合 Jackson 处理JSON:
<dependency>
 <groupId>com.squareup.okhttp3</groupId>
 <artifactId>okhttp</artifactId>
 <version>4.12.0</version>
</dependency>
<dependency>
 <groupId>com.fasterxml.jackson.core</groupId>
 <artifactId>jackson-databind</artifactId>
 <version>2.17.0</version>
</dependency>
如果项目已经用了Spring Boot,直接用 RestTemplate 或 WebClient 也可以,原理完全一样。 5.3 第三步:非流式调用(Java版)
import okhttp3.*;
import com.fasterxml.jackson.databind.ObjectMapper;
import com.fasterxml.jackson.databind.JsonNode;
import java.io.IOException;

public class DeepSeekExample {
 // DeepSeek API地址(兼容OpenAI格式)
 private static final String API_URL = "https://api.deepseek.com/chat/completions";
 private static final String API_KEY = "你的API Key";

 public static void main(String[] args) throws IOException {
 OkHttpClient client = new OkHttpClient();
 ObjectMapper mapper = new ObjectMapper();

 // 构建请求体(JSON)
 String json = """
 {
 "model": "deepseek-v4-pro",
 "messages": [
 {"role": "system", "content": "你是一个专业的Java技术顾问"},
 {"role": "user", "content": "Spring Boot 4.0和3.x的主要区别是什么?"}
 ],
 "temperature": 0.7
 }
 """;

 RequestBody body = RequestBody.create(
 json,
 MediaType.parse("application/json; charset=utf-8")
 );

 Request request = new Request.Builder()
 .url(API_URL)
 .header("Authorization", "Bearer " + API_KEY)
 .post(body)
 .build();

 // 发送请求
 try (Response response = client.newCall(request).execute()) {
 if (!response.isSuccessful()) {
 throw new IOException("请求失败:" + response.code());
 }

 // 解析返回结果
 String responseBody = response.body().string();
 JsonNode root = mapper.readTree(responseBody);
 String content = root.path("choices")
 .path(0)
 .path("message")
 .path("content")
 .asText();

 System.out.println("AI回复:\n" + content);
 }
 }
}
5.4 流式输出(Server-Sent Events) 如果需要像ChatGPT那样一个字一个字往外蹦,使用流式输出:
import okhttp3.*;
import java.io.BufferedReader;
import java.io.InputStreamReader;
import java.nio.charset.StandardCharsets;

public class DeepSeekStreamExample {
 private static final String API_URL = "https://api.deepseek.com/chat/completions";
 private static final String API_KEY = "你的API Key";

 public static void main(String[] args) throws IOException {
 OkHttpClient client = new OkHttpClient();

 String json = """
 {
 "model": "deepseek-v4-pro",
 "messages": [
 {"role": "user", "content": "写一个快速排序算法"}
 ],
 "stream": true
 }
 """;

 Request request = new Request.Builder()
 .url(API_URL)
 .header("Authorization", "Bearer " + API_KEY)
 .header("Accept", "text/event-stream")
 .post(RequestBody.create(json, MediaType.parse("application/json")))
 .build();

 // 流式读取
 try (Response response = client.newCall(request).execute()) {
 BufferedReader reader = new BufferedReader(
 new InputStreamReader(response.body().byteStream(), StandardCharsets.UTF_8)
 );
 String line;
 while ((line = reader.readLine()) != null) {
 if (line.startsWith("data: ")) {
 String data = line.substring(6);
 if ("[DONE]".equals(data)) {
 break;
 }
 // 解析并打印每个token(简化处理)
 System.out.print(extractContent(data));
 }
 }
 }
 }

 private static String extractContent(String json) {
 // 简化解析,实际项目建议用Jackson解析
 try {
 // 快速提取content字段
 int idx = json.indexOf("\"content\":\"");
 if (idx == -1) return "";
 int start = idx + 11;
 int end = json.indexOf("\"", start);
 return json.substring(start, end);
 } catch (Exception e) {
 return "";
 }
 }
}
5.5 启用深度思考模式(Java版) V4 Pro支持思考模式,通过 reasoning_effort 参数控制思考强度:
// 在请求体中加入reasoning_effort字段
String jsonWithReasoning = """
 {
 "model": "deepseek-v4-pro",
 "messages": [
 {"role": "user", "content": "请分析微服务架构的优缺点"}
 ],
 "temperature": 0.7,
 "reasoning_effort": "high"
 }
 """;
5.6 使用Spring Boot RestTemplate简化调用 如果你的项目已经是Spring Boot,用 RestTemplate 更简洁:
import org.springframework.http.*;
import org.springframework.web.client.RestTemplate;

public class DeepSeekSpringExample {
 private static final String API_URL = "https://api.deepseek.com/chat/completions";
 private static final String API_KEY = "你的API Key";

 public static String chat(String userMessage) {
 RestTemplate restTemplate = new RestTemplate();

 // 构建请求头
 HttpHeaders headers = new HttpHeaders();
 headers.setContentType(MediaType.APPLICATION_JSON);
 headers.setBearerAuth(API_KEY);

 // 构建请求体
 String json = """
 {
 "model": "deepseek-v4-pro",
 "messages": [{"role": "user", "content": "%s"}],
 "temperature": 0.7
 }
 """.formatted(userMessage);

 HttpEntity<String> entity = new HttpEntity<>(json, headers);

 // 发送请求
 ResponseEntity<String> response = restTemplate.exchange(
 API_URL,
 HttpMethod.POST,
 entity,
 String.class
 );

 // 解析响应(使用Jackson或直接截取)
 return extractContentFromResponse(response.getBody());
 }
}
核心要点 : API地址和格式与OpenAI完全一致,迁移成本几乎为零 所有参数( model 、 messages 、 temperature 、 stream 、 reasoning_effort )与官方文档对齐 可以用OkHttp、RestTemplate或WebClient,随你喜欢 用Jackson解析响应,路径是 choices[0].message.content 5.7 代码示例中的关键参数说明 参数 说明 可选值 model 模型名称 deepseek-v4-pro / deepseek-v4-flash temperature 随机性(0-2) 默认0.7,越高越随机 stream 是否流式 true / false reasoning_effort 思考强度(仅V4 Pro支持) low / medium / high / max max_tokens 最大输出Token 默认4096,最大384K 重要 :复杂Agent任务推荐使用 reasoning_effort = "max" ,输出质量最高。普通对话用 medium 即可平衡速度和效果。 六、定价:闭源价格的几分之一
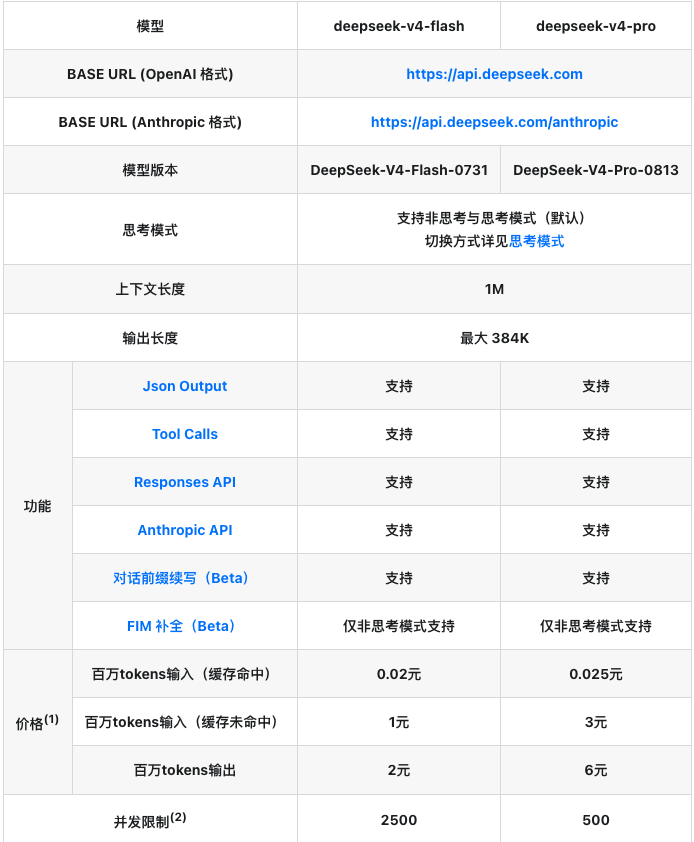
V4 Pro的定价非常有竞争力: 模型 输入(缓存命中) 输入(未命中) 输出 V4-Pro 0.025元 / 1M tokens 3元 / 1M tokens 6元 / 1M tokens V4-Flash 0.02元 / 1M tokens 1元 / 1M tokens 2元 / 1M tokens 注意 :缓存命中价格是限时优惠价。输入未命中时V4-Pro为3元/百万tokens,输出为6元/百万tokens。 横向对比一下:GPT-5.5的API价格是V4 Pro的 8-12倍 。 在成本仅为闭源模型一小部分的情况下,V4 Pro的性能却已经能与之正面竞争。 这是真正的“性价比之王” 。 重要提醒 :旧版API(deepseek-chat / deepseek-reasoner)将于 2026年7月24日停用 ,请尽快迁移到V4系列。 七、适用场景 场景 推荐版本 理由 复杂Agent任务 V4-Pro 多步骤逻辑推导、工具调用链路最优 大型代码库解析 V4-Pro 1M上下文一次读完整个代码库 长篇合同/文档分析 V4-Pro 百万字文献梳理不丢信息 科研材料梳理 V4-Pro 数理推理、专业推理能力突出 智能客服 V4-Flash 高频调用,成本敏感 内容创作 V4-Flash 兼顾推理与速度 快速原型验证 V4-Flash 低成本快速迭代 总结 DeepSeek V4 Pro的正式发布,标志着一个重要的转折点—— 开源模型第一次真正站到了闭源旗舰的擂台上 。 **SWE-bench Verified 80.6%**的开源最高分、 1M上下文 的标配能力、 仅为GPT-5.5八分之一 的价格——这三个数字放在一起,让V4 Pro成为2026年Java/AI开发者工具箱里一个绕不开的选项。 对于Java开发者来说,DeepSeek V4 Pro意味着什么? 第一,代码生成和调试的效率大幅提升。 V4 Pro在HumanEval上已经超过了GPT-5.5,在SWE-bench上拿到了开源最高分。用它来做代码辅助,效果已经不输闭源旗舰。 第二,复杂文档处理不再是问题。 1M上下文一次读完整个代码库或长篇技术文档——不用分段、不丢信息。这对处理大型Spring Boot项目、阅读长篇技术规范文档来说,价值巨大。 第三,成本不再是限制。 当你用V4 Pro做AI开发时,调用成本只有GPT-5.5的几分之一。你可以更大胆地尝试更多场景,不用担心账单爆炸。 当然,V4 Pro不是完美的。 Agent能力与GPT-5.5还有差距,多模态也不是它的主打方向。 选模型,从来不是看“谁最强”,而是看“谁最适合你的场景” 。 官方资源: GitHub开源地址 :https://huggingface.co/deepseek-ai/DeepSeek-V4-Pro API文档 :https://api-docs.deepseek.com 最近缺项目经历想快速提升项目实战能力(包含多个AI项目),或者最近找工作,或者想学习AI的小伙伴,可以看看下面👇🏻的 这个链接 (或许真的能够帮到你)。