


【部署教程】ChatGLM-6B 开源双语对话语言模型 作者:小傅哥
博客: https://bugstack.cn (opens new window) 沉淀、分享、成长,让自己和他人都能有所收获!😄 ChatGLM-6B (opens new window) 开源双语对话语言模型,太牛皮了!我要能做一个这个水平的东西,我就AI创业,融资、赚钱、发财,躺平去!哈哈哈!—— 真好,看到这样一个东西,感觉看到了国内 AI 的希望!感谢清华 ChatGLM 团队。
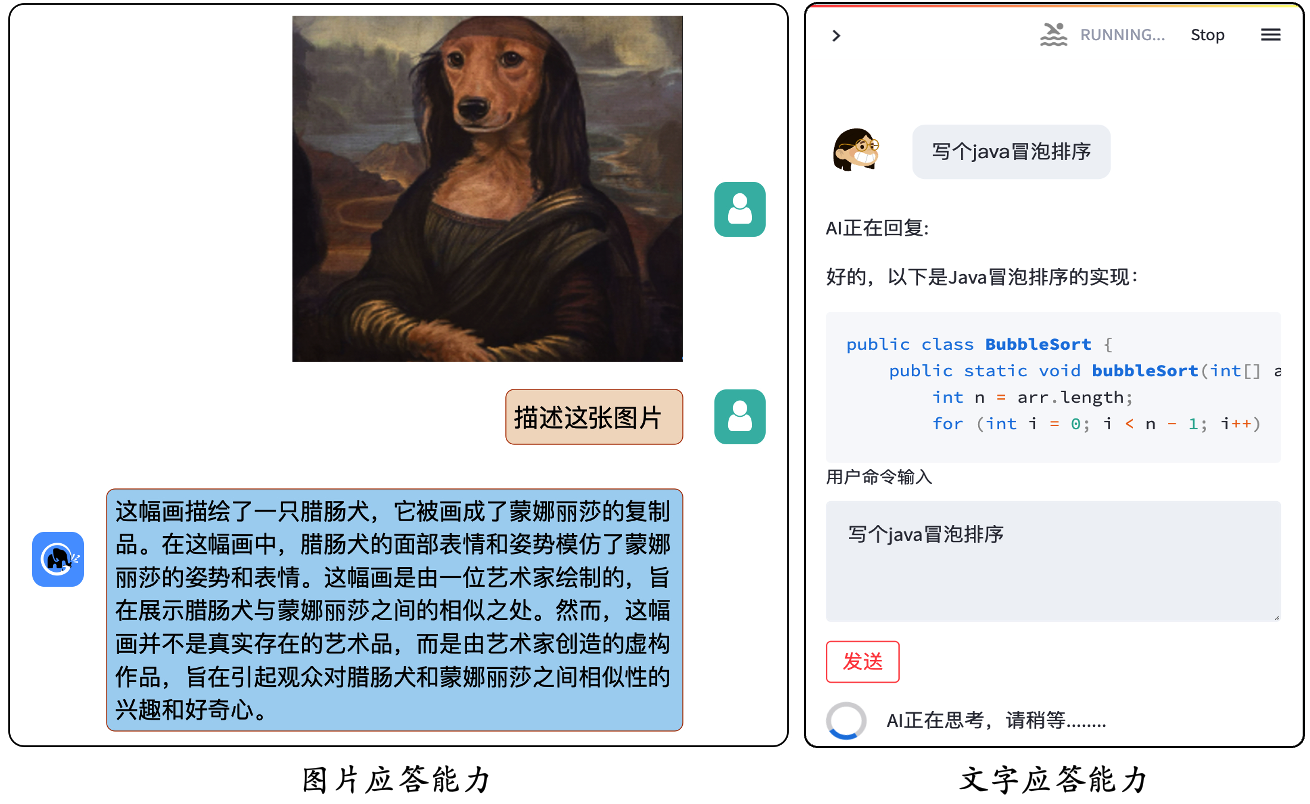
ChatGLM-6B 是清华开源的一个小型对话模型,让大家可以在自己部署起来跑一跑看看效果。但对于本身不是从事此类工作的其他研发伙伴来说,部署这个东西多半都会卡在环境上。所以小傅哥在 本地/云服务 部署体验后,把相关经验分享下,让有需要的伙伴也可以尝尝鲜。 # 一、模型简述 ChatGLM 参考了 ChatGPT 的设计思路,在千亿基座模型 GLM-130B 中注入了代码预训练,通过有监督微调(Supervised Fine-Tuning)等技术实现人类意图对齐。2022年11月,斯坦福大学大模型中心对全球30个主流大模型进行了全方位的评测, GLM-130B 是亚洲唯一入选的大模型👍🏻 。
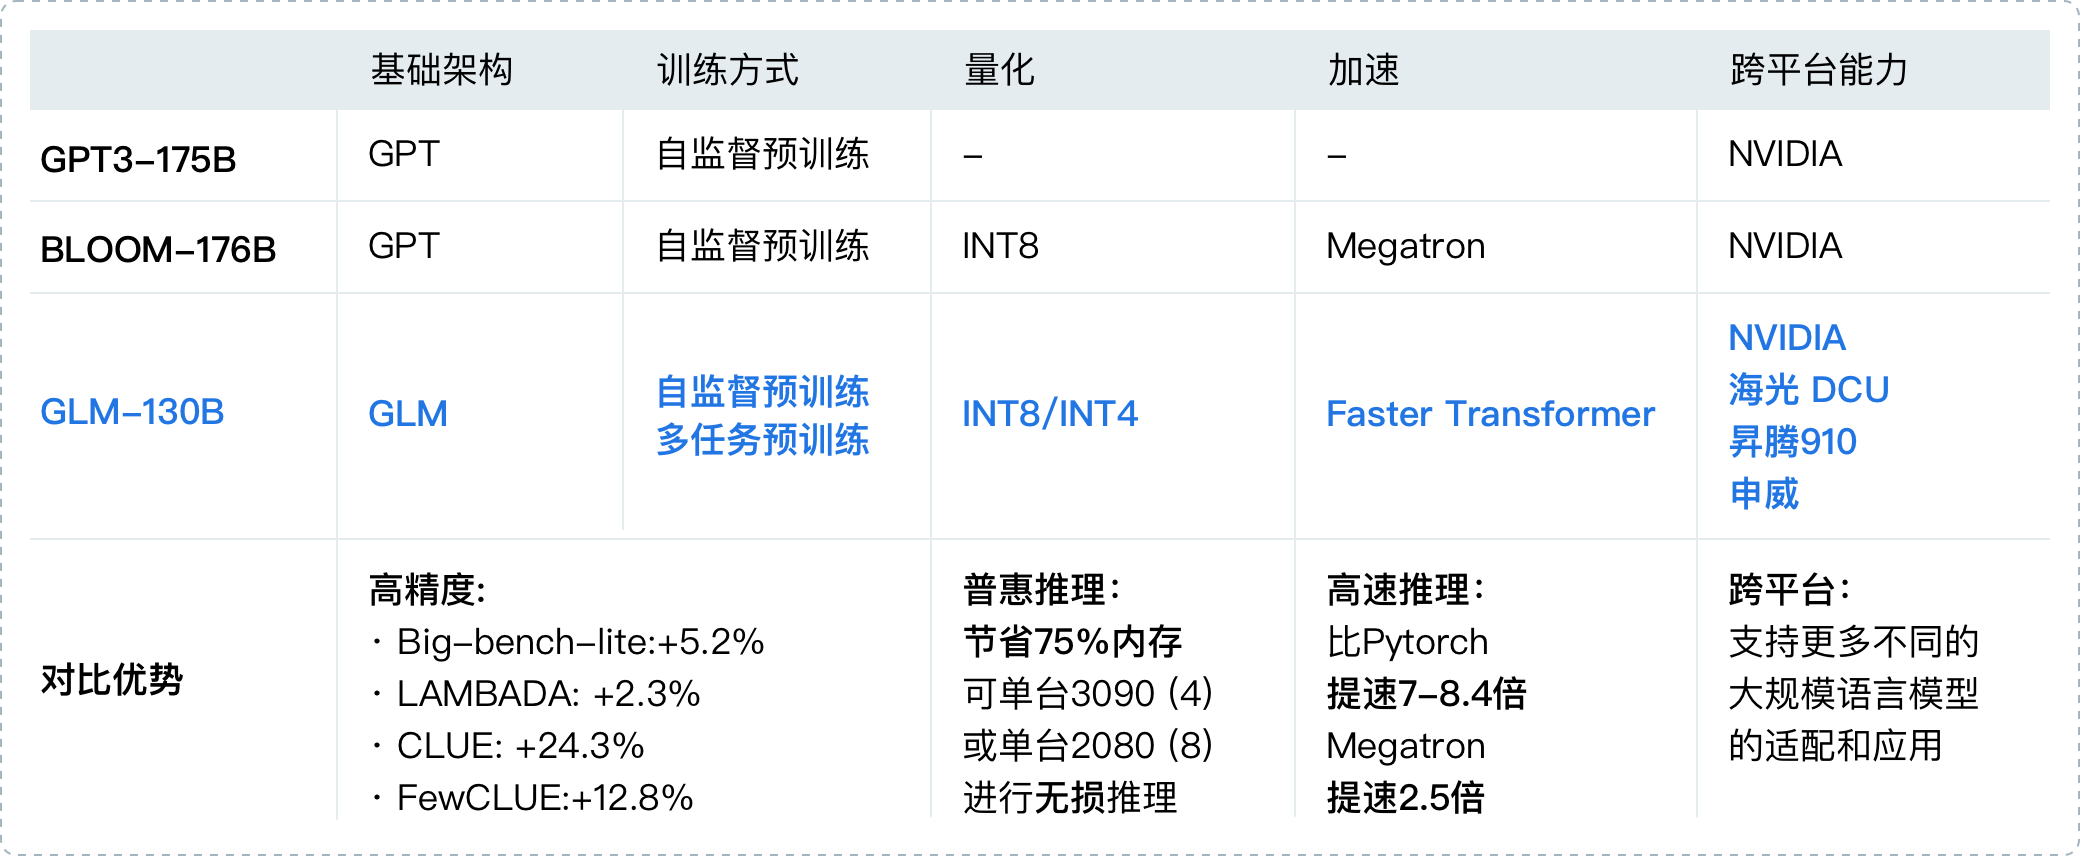
同时 ChatGLM 团队为与社区一起更好地推动大模型技术的发展,清华开源了 ChatGLM-6B 模型。它是一个初具中文问答和对话功能的小型模型,可以让大家即使在本地和一些小型的服务器上就可以部署体验。 源码: https://github.com/THUDM/ChatGLM-6B (opens new window) - 这里有最新更新的内容和部署说明 社区: https://chatglm.cn/blog (opens new window) - 这里有更全面的介绍信息 资源:自己训练的话,建议 10核、64g内存、22g显存 # 二、基础环境 # 1. 服务配置 ChatGLM-6B 虽然已经是很温馨提供的,能最佳支持对话的最小模型了,但实际部署的时候仍需要一个不小的服务器 32G内存 配置或者有较好的 16G NVIDIA 显卡。可能就怕大家部署起来,所以官网上也提供了更低成本的部署方案,INT8和INT4 数据模型。整体所需空间如下; 量化等级 最低 GPU 显存 (推理) 最低 GPU 显存 (高效参数微调) FP16(无量化) 13 GB 14 GB INT8 8 GB 9 GB INT4 6 GB 7 GB 小傅哥自己也是在 Mac M1 、 轻量云主机 ,还有一个专门用于测试 AIGC的服务器 上,都做了测试验证,这样也能避免大家走弯路。就像我在一款8G内存的轻量云主机上,部署 INT4 模型,报错如下;
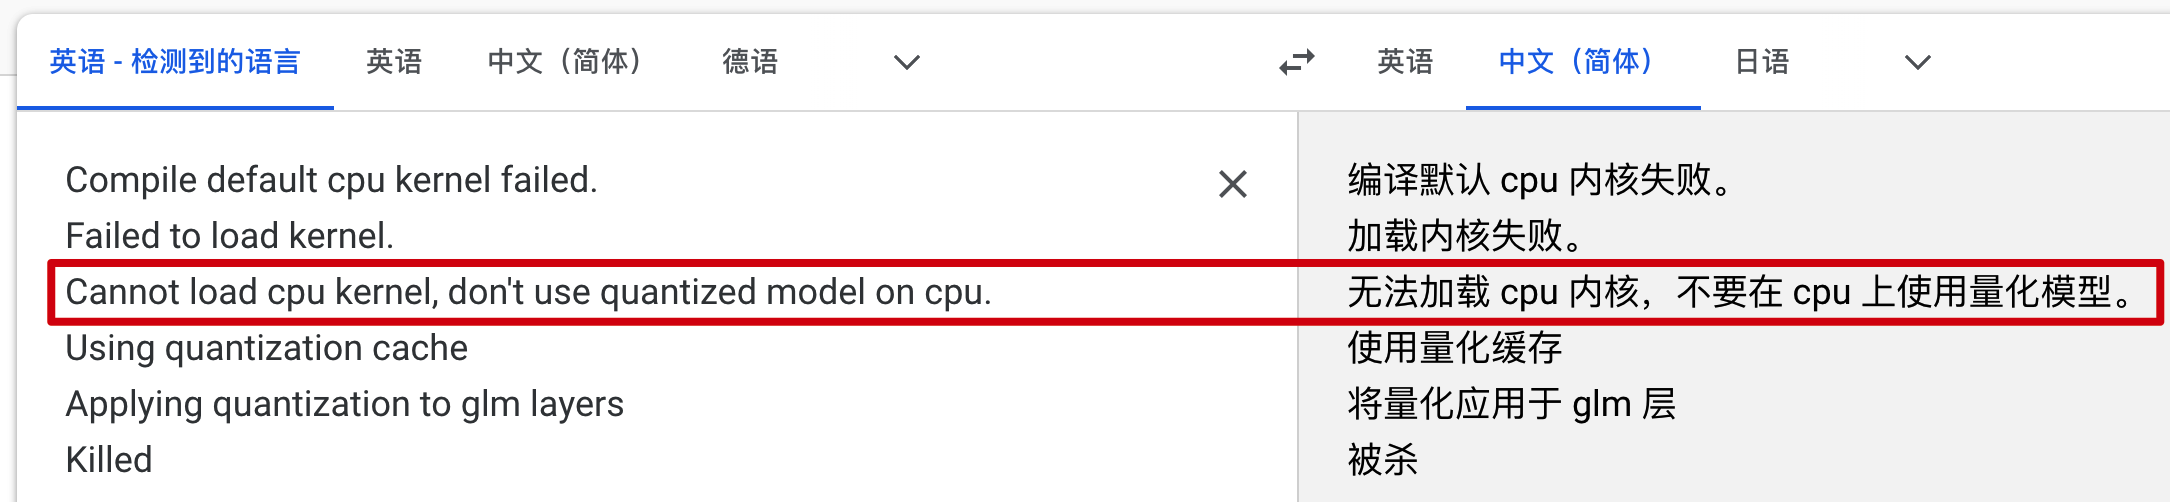
😂 所以别买一些配置不佳的机器,否则你根本跑不起来,还浪费钱。 # 2. 工程代码
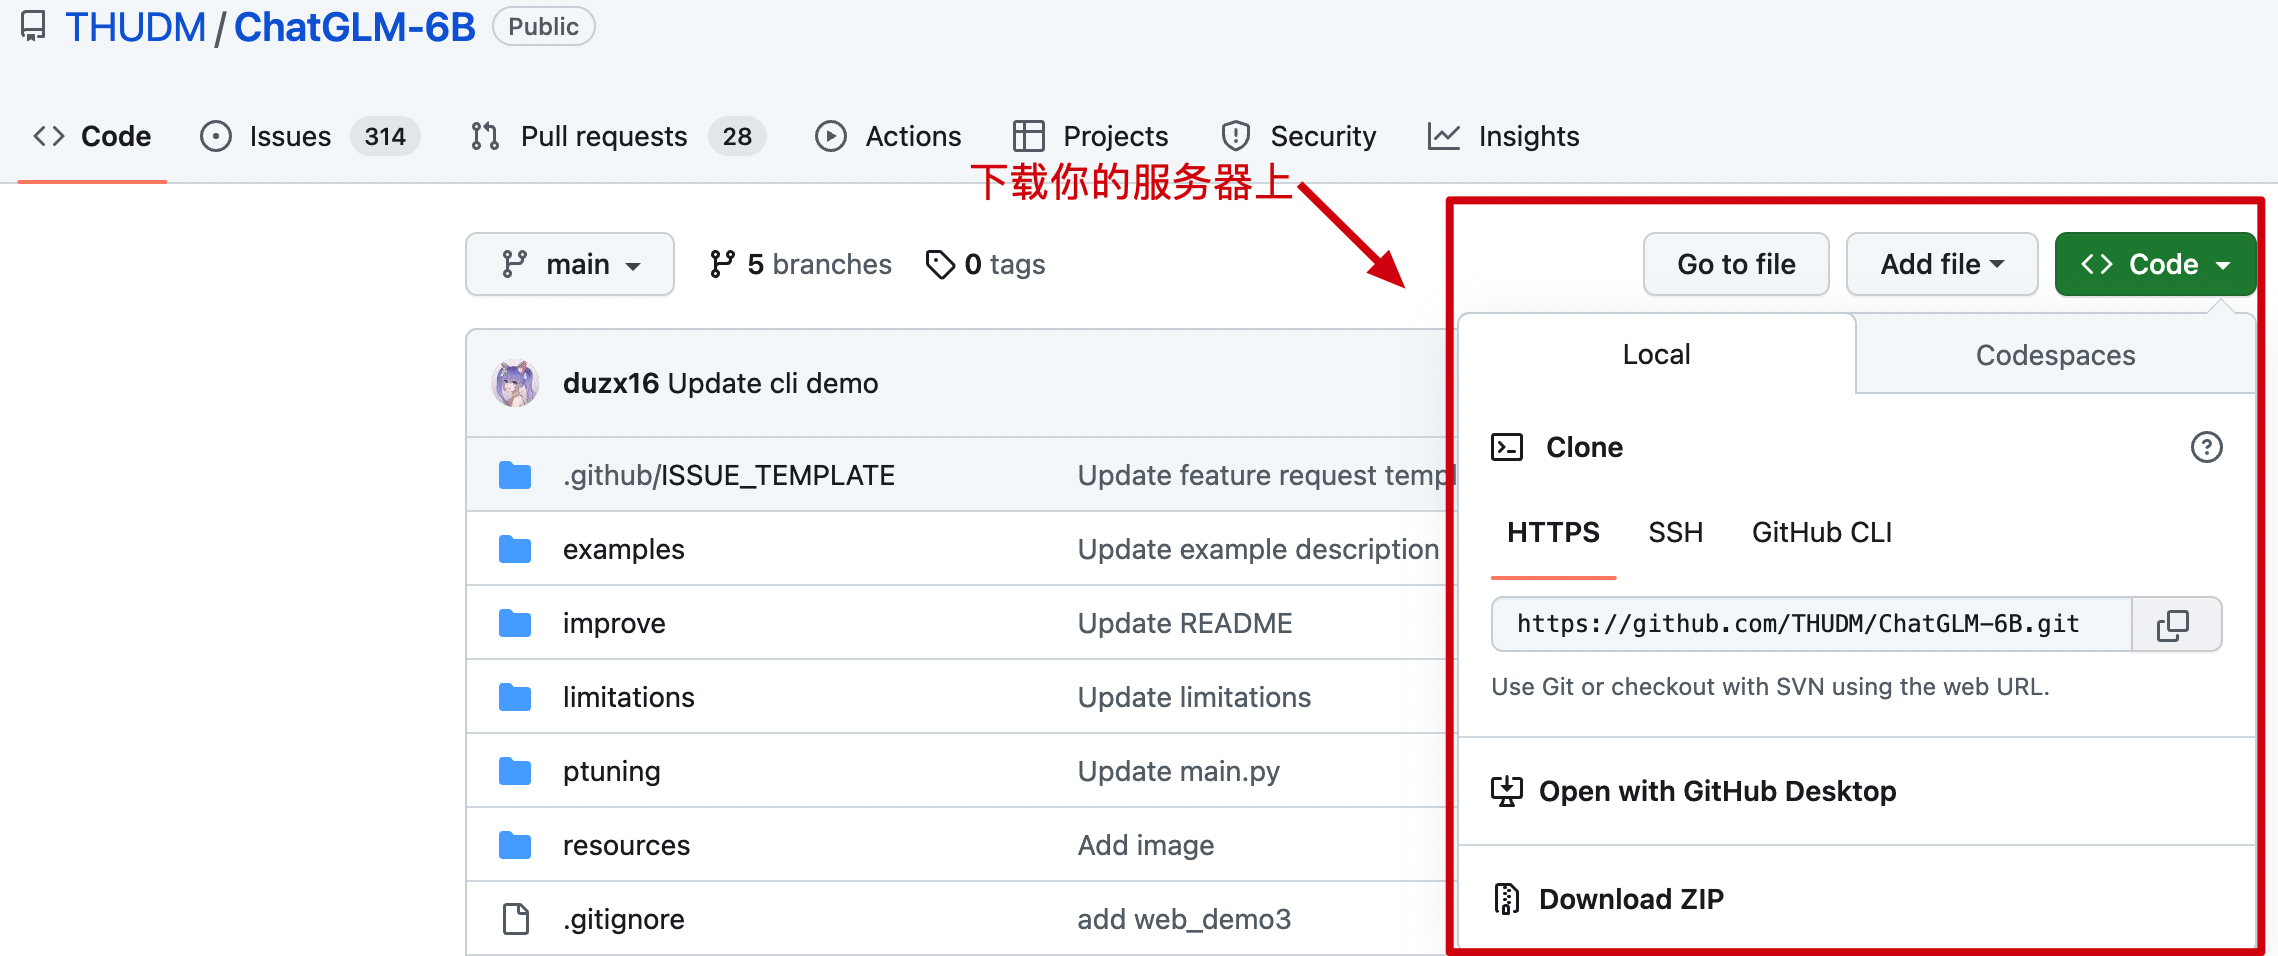
源码 : https://github.com/THUDM/ChatGLM-6B (opens new window) - 无论你使用哪种部署方式,都需要把代码下载到对应的服务上。 # 3. 算法模型 在 ChatGLM-6B 中有一段代码是配置模型地址的,除了说明的Mac电脑,理论上来说它可以自动下载。但这些模型太大了,所以最好是提前下载到本地使用。
// web_demo2.py 部分代码
tokenizer = AutoTokenizer.from_pretrained("/Users/xfg/develop/github/chatglm-6b", trust_remote_code=True)
model = AutoModel.from_pretrained("/Users/xfg/develop/github/chatglm-6b", trust_remote_code=True).half().cuda()
1 2 3