LeetCode刷题Java版028.实现 strStr()
作者:沉默王二
发布时间:2022-08-19T17:54:25.323+0800
028.实现 strStr()
题意
给你两个字符串 haystack 和 needle ,请你在 haystack 字符串中找出 needle 字符串出现的第一个位置(下标从 0 开始)。如果不存在,则返回 -1 。
难度
简单
示例
例1
输入:haystack = "hello", needle = "ll"
例2
输入:haystack = "aaaaa", needle = "bba"
分析
对于这道题,我们很容易直接想到 Java 字符串自带的indexOf()方法,但是我们有没有想过它的内部是怎么实现的呢?为什么它能够有如此优秀的时间复杂度?
今天这道题是一道简单题,因为通过haystack.indexOf(needle)就可以完成题目的要求,但是本着精益求精的态度,我们需要深入研究这背后的原理。
那么,就让我们从最朴素的暴力算法开始吧!
我们从头开始匹配,举例来说,假如 haystack = "hello", needle = "ll",匹配步骤如下图 028-01:
这样子能够实现较为简单的字符串匹配了,时间复杂度,n代表原串的长度,m代表匹配串的长度。但是这样会存在一个问题,当字符串长度非常非常长的时候……这个思路的时间复杂度就不太理想了,有没有什么地方可以优化呢?
再来看下面这个例子,假如 haystack = "abbacabbab", needle = "abbab",匹配步骤如下图 028-02:
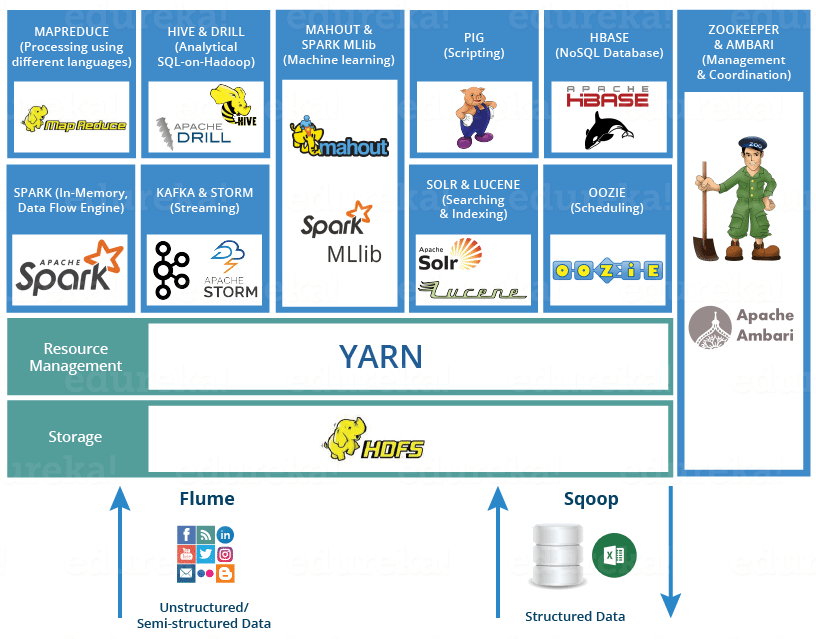
这种方式能匹配,但是,不够好!因为每次匹配失败,匹配串的下标都要回到开头(也就是重新从needle[0]开始),并且原串的下标也要往回移动(从haystack[i+1]开始),真的需要这么麻烦去不断的往回找吗?也就是下图 028-03 的位置。

其实真不用,因为在匹配串的开头有个ab(字符 b 的前缀),和结尾的ab(字符 b 的后缀)是一样的。
如果匹配串abbab在最后一个位置和原串匹配失败了,那么原串前面肯定存在着abba,因为匹配串是以abba开头的,这时候我们要移动的话,就可以保持原串的下标不变(也就是下图 028-04 中箭头指向的“c”的位置 haystack[4])然后让匹配串直接从第一个a的位置开始再度往后匹配,移动匹配串的下标见下图 028-04 :
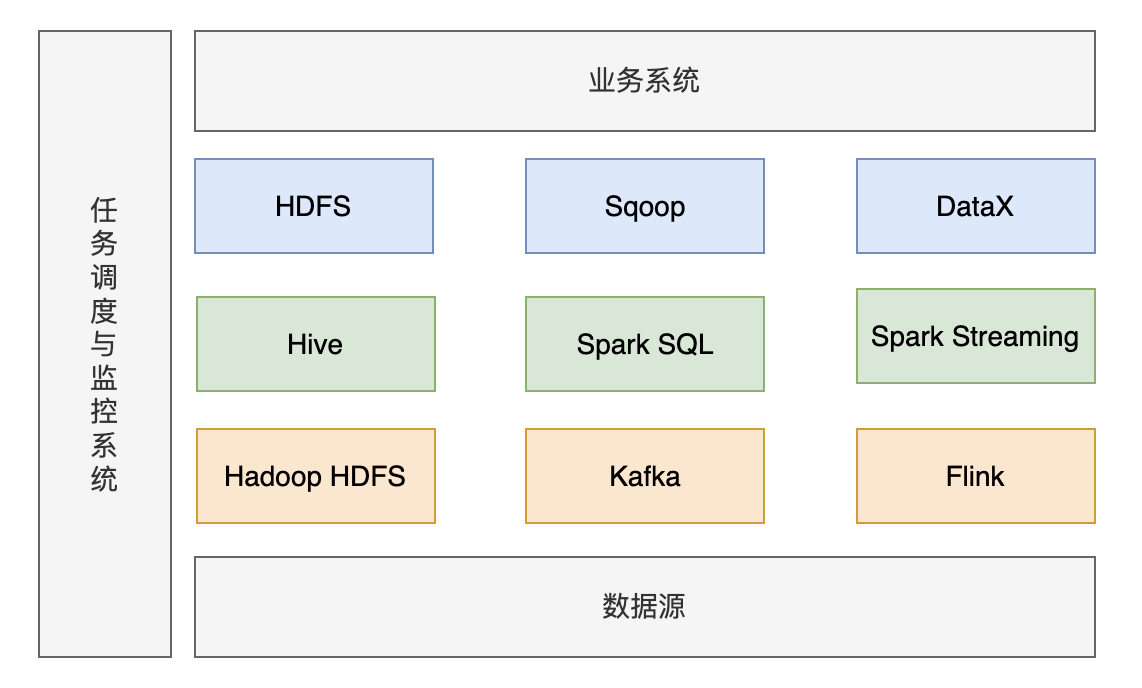
这样子是不是就省去了一部分比较的步骤呢(回看图 028-2,直接就省去了三个步骤)?为什么可以这样做呢?
这就不得不说一说 KMP 算法了。
KMP算法是由 Knuth、Pratt 和 Morris 在 1977 年共同发布的,用来解决字符串匹配问题的算法。
既然要用到 KMP 算法,这道题肯定就不只是简单的程度了,可以说到了 hard 级别。
KMP 算法核心思想概括成一句话就是 利用已经匹配过的残余信息,使原串的比较位置保持不变,而匹配串的比较位置尽快移动到有效的地方。
回顾图 028-02 的暴力步骤,如果从 haystack[i] 开始的那一趟比较失败了,算法会尝试从 haystack[i+1] 开始比较。这种行为,属于典型的“没有从之前的错误中学到东西”。
我们应当注意到,一次失败的匹配,会给我们提供宝贵的信息——再次观察图 028-02 中的移动方法,匹配串abbab在第一次匹配失败后,我们应该如何移动原串和匹配串的下标呢?
答案见下图 028-05,原创的位置保持不变,只需要移动匹配串到第二个 b 的位置就可以了。因为以最后一个位置的b结尾的后缀,最多能与前缀ab匹配。
也就是图中的蓝色部分与绿色部分相匹配。
所以……在匹配失败之后,我们能够让匹配串的比较位置以最快的速度移动到的位置,就是——以 当前比较位置结尾的能够匹配的最长前缀 !!
- 前缀:对于字符串 abcxxxxefg,我们称 abc 属于 abcxxxxefg 的某个前缀。
- 后缀:对于字符串 abcxxxxefg,我们称 efg 属于 abcxxxxefg 的某个后缀。
到这里,我们应该清楚 KMP 为什么相比于暴力解法更快:
- 因为 KMP 利用已匹配部分中相同的「前缀」和「后缀」来加速下一次的匹配。
- 因为 KMP 的原串指针不会进行回溯(没有暴力匹配中回到下一个「发起点」的过程)。
前缀和后缀又是怎么求出来的呢?
这就涉及到了 KMP算法 的next[]数组,它就是匹配串位置能移动到的有效的且最远的位置。
next[]数组到底要怎么求呢?我们显然不能挨个去对每个前缀后缀处理,因为这样子时间开销太大了!
其实只需要匹配串对自身 匹配 一次就可以得出了。
class GetNext{
next[0] = -1; int posK = -1,posJ = 0; while(posJ < p.length()){ if(posK == -1 || p.charAt(posK) == p.charAt(posJ)){ posJ++; posK++; next[posJ] = posK; } else posK = next[posK]; } }}
上述代码中,我们用posJ和posK来求解next[]数组,我们来模拟一遍。
posK就相当于对匹配串自己 匹配 的一个变量,只不过它是后缀来匹配前缀,这样子我们就求解出了next[]数组,然后只需要按照next[]数组的值,在匹配串与原串失配的时候,把匹配串的位置相应的移动即可。
这次,我们再来用next[]数组来优化我们的字符串匹配过程:
class Solution {
next[0] = -1; int posK = -1,posJ = 0; while(posJ < p.length()){ if(posK == -1 || p.charAt(posK) == p.charAt(posJ)){ posJ++; posK++; next[posJ] = posK; } else posK = next[posK]; } } public int strStr(String haystack, String needle) { int[] next = new int[needle.length()+1]; getNext(needle,next); int posI = 0,posJ = 0; while(posI < haystack.length() && posJ < needle.length()){ if(posJ == -1 || haystack.charAt(posI) == needle.charAt(posJ)){ posI++; posJ++; } else{ posJ = next[posJ]; } } if(posJ == needle.length()) return posI - posJ; return -1; }}
时间复杂度:
整个过程,我们都是利用 已经匹配过的信息 来对我们匹配失败的地方进行处理,不断调整匹配串的匹配位置,时间复杂度只有对于匹配串自身匹配的时间以及匹配串匹配原串的时间,所以只有 n + m。
当我们理解了 “简简单单” 的indexOf()的内部原理,再来写return haystack.indexOf(needle);是不是有不同的感觉呢?当然Java实现的indexOf()的内部还有各种各式各样的优化,但是实际上时间复杂度并没有变化,这些常数优化的技巧就不包括在算法本身了。
总结
本次的一道简单题,因为我们能够站在前人的肩膀上,直接一行return haystack.indexOf(needle);解决,但是学习计算机其实是一个自顶向下的一个过程,在我们掌握了return haystack.indexOf(needle);之后,其实我们更应该做的是去理解它的内核—— KMP。
我们来比较一下暴力和 KMP 之间的差别:
力扣链接:https://leetcode.cn/problems/implement-strstr/
一步一个脚印
不积跬步无以至千里,不积小流无以成江海。LeetCode - 100天从算法小白到卷王正式启动了,我们计划周一到周五至少每天更新一篇,周六周日更新一篇,目标 300 道 LeetCode 经典题。
PDF 版本目前只针对**二哥编程星球 的球友开放,如果你也想一起打卡学习算法的话,戳链接 **加入我们吧。
一个人可以走得很快,但一群人才能走得更远。二哥编程星球 (目前已有 650 多名球友加入)里面的每个球友都非常的友善,除了鼓励你,还会给你提出合理的建议,一起冲!
028.实现 strStr()
题意
给你两个字符串 haystack 和 needle ,请你在 haystack 字符串中找出 needle 字符串出现的第一个位置(下标从 0 开始)。如果不存在,则返回 -1 。
难度
简单
示例
例1
输入:haystack = "hello", needle = "ll"
例2
输入:haystack = "aaaaa", needle = "bba"
分析
对于这道题,我们很容易直接想到 Java 字符串自带的indexOf()方法,但是我们有没有想过它的内部是怎么实现的呢?为什么它能够有如此优秀的时间复杂度?
今天这道题是一道简单题,因为通过haystack.indexOf(needle)就可以完成题目的要求,但是本着精益求精的态度,我们需要深入研究这背后的原理。
那么,就让我们从最朴素的暴力算法开始吧!
我们从头开始匹配,举例来说,假如 haystack = "hello", needle = "ll",匹配步骤如下图 028-01:
这样子能够实现较为简单的字符串匹配了,时间复杂度,n代表原串的长度,m代表匹配串的长度。但是这样会存在一个问题,当字符串长度非常非常长的时候……这个思路的时间复杂度就不太理想了,有没有什么地方可以优化呢?
再来看下面这个例子,假如 haystack = "abbacabbab", needle = "abbab",匹配步骤如下图 028-02:
这种方式能匹配,但是,不够好!因为每次匹配失败,匹配串的下标都要回到开头(也就是重新从needle[0]开始),并且原串的下标也要往回移动(从haystack[i+1]开始),真的需要这么麻烦去不断的往回找吗?也就是下图 028-03 的位置。
其实真不用,因为在匹配串的开头有个ab(字符 b 的前缀),和结尾的ab(字符 b 的后缀)是一样的。
如果匹配串abbab在最后一个位置和原串匹配失败了,那么原串前面肯定存在着abba,因为匹配串是以abba开头的,这时候我们要移动的话,就可以保持原串的下标不变(也就是下图 028-04 中箭头指向的“c”的位置 haystack[4])然后让匹配串直接从第一个a的位置开始再度往后匹配,移动匹配串的下标见下图 028-04 :
这样子是不是就省去了一部分比较的步骤呢(回看图 028-2,直接就省去了三个步骤)?为什么可以这样做呢?
这就不得不说一说 KMP 算法了。
KMP算法是由 Knuth、Pratt 和 Morris 在 1977 年共同发布的,用来解决字符串匹配问题的算法。
既然要用到 KMP 算法,这道题肯定就不只是简单的程度了,可以说到了 hard 级别。
KMP 算法核心思想概括成一句话就是 利用已经匹配过的残余信息,使原串的比较位置保持不变,而匹配串的比较位置尽快移动到有效的地方。
回顾图 028-02 的暴力步骤,如果从 haystack[i] 开始的那一趟比较失败了,算法会尝试从 haystack[i+1] 开始比较。这种行为,属于典型的“没有从之前的错误中学到东西”。
我们应当注意到,一次失败的匹配,会给我们提供宝贵的信息——再次观察图 028-02 中的移动方法,匹配串abbab在第一次匹配失败后,我们应该如何移动原串和匹配串的下标呢?
答案见下图 028-05,原创的位置保持不变,只需要移动匹配串到第二个 b 的位置就可以了。因为以最后一个位置的b结尾的后缀,最多能与前缀ab匹配。
也就是图中的蓝色部分与绿色部分相匹配。
所以……在匹配失败之后,我们能够让匹配串的比较位置以最快的速度移动到的位置,就是——以 当前比较位置结尾的能够匹配的最长前缀 !!
- 前缀:对于字符串 abcxxxxefg,我们称 abc 属于 abcxxxxefg 的某个前缀。
- 后缀:对于字符串 abcxxxxefg,我们称 efg 属于 abcxxxxefg 的某个后缀。
到这里,我们应该清楚 KMP 为什么相比于暴力解法更快:
- 因为 KMP 利用已匹配部分中相同的「前缀」和「后缀」来加速下一次的匹配。
- 因为 KMP 的原串指针不会进行回溯(没有暴力匹配中回到下一个「发起点」的过程)。
前缀和后缀又是怎么求出来的呢?
这就涉及到了 KMP算法 的next[]数组,它就是匹配串位置能移动到的有效的且最远的位置。
next[]数组到底要怎么求呢?我们显然不能挨个去对每个前缀后缀处理,因为这样子时间开销太大了!
其实只需要匹配串对自身 匹配 一次就可以得出了。
class GetNext{
next[0] = -1; int posK = -1,posJ = 0; while(posJ < p.length()){ if(posK == -1 || p.charAt(posK) == p.charAt(posJ)){ posJ++; posK++; next[posJ] = posK; } else posK = next[posK]; } }}
上述代码中,我们用posJ和posK来求解next[]数组,我们来模拟一遍。
posK就相当于对匹配串自己 匹配 的一个变量,只不过它是后缀来匹配前缀,这样子我们就求解出了next[]数组,然后只需要按照next[]数组的值,在匹配串与原串失配的时候,把匹配串的位置相应的移动即可。
这次,我们再来用next[]数组来优化我们的字符串匹配过程:
class Solution {
next[0] = -1; int posK = -1,posJ = 0; while(posJ < p.length()){ if(posK == -1 || p.charAt(posK) == p.charAt(posJ)){ posJ++; posK++; next[posJ] = posK; } else posK = next[posK]; } } public int strStr(String haystack, String needle) { int[] next = new int[needle.length()+1]; getNext(needle,next); int posI = 0,posJ = 0; while(posI < haystack.length() && posJ < needle.length()){ if(posJ == -1 || haystack.charAt(posI) == needle.charAt(posJ)){ posI++; posJ++; } else{ posJ = next[posJ]; } } if(posJ == needle.length()) return posI - posJ; return -1; }}
时间复杂度:
整个过程,我们都是利用 已经匹配过的信息 来对我们匹配失败的地方进行处理,不断调整匹配串的匹配位置,时间复杂度只有对于匹配串自身匹配的时间以及匹配串匹配原串的时间,所以只有 n + m。
当我们理解了 “简简单单” 的indexOf()的内部原理,再来写return haystack.indexOf(needle);是不是有不同的感觉呢?当然Java实现的indexOf()的内部还有各种各式各样的优化,但是实际上时间复杂度并没有变化,这些常数优化的技巧就不包括在算法本身了。
总结
本次的一道简单题,因为我们能够站在前人的肩膀上,直接一行return haystack.indexOf(needle);解决,但是学习计算机其实是一个自顶向下的一个过程,在我们掌握了return haystack.indexOf(needle);之后,其实我们更应该做的是去理解它的内核—— KMP。
我们来比较一下暴力和 KMP 之间的差别:
力扣链接:https://leetcode.cn/problems/implement-strstr/
一步一个脚印
不积跬步无以至千里,不积小流无以成江海。LeetCode - 100天从算法小白到卷王正式启动了,我们计划周一到周五至少每天更新一篇,周六周日更新一篇,目标 300 道 LeetCode 经典题。
PDF 版本目前只针对**二哥编程星球 的球友开放,如果你也想一起打卡学习算法的话,戳链接 **加入我们吧。
一个人可以走得很快,但一群人才能走得更远。二哥编程星球 (目前已有 650 多名球友加入)里面的每个球友都非常的友善,除了鼓励你,还会给你提出合理的建议,一起冲!
            知识星球


        扫码加入星球
        查看更多优质内容

    https://wx.zsxq.com/mweb/views/joingroup/join_group.html?group_id=15522885221412