


面试官:“OpenClaw的Memory和RAG有什么区别?”我轻描淡写:“一个用SQLite,一个用ElasticSearch。”面试官:“明天二面。”
老王劈头盖脸地问:“OpenClaw 的 Memory 和 RAG 很相似,了解吗?”
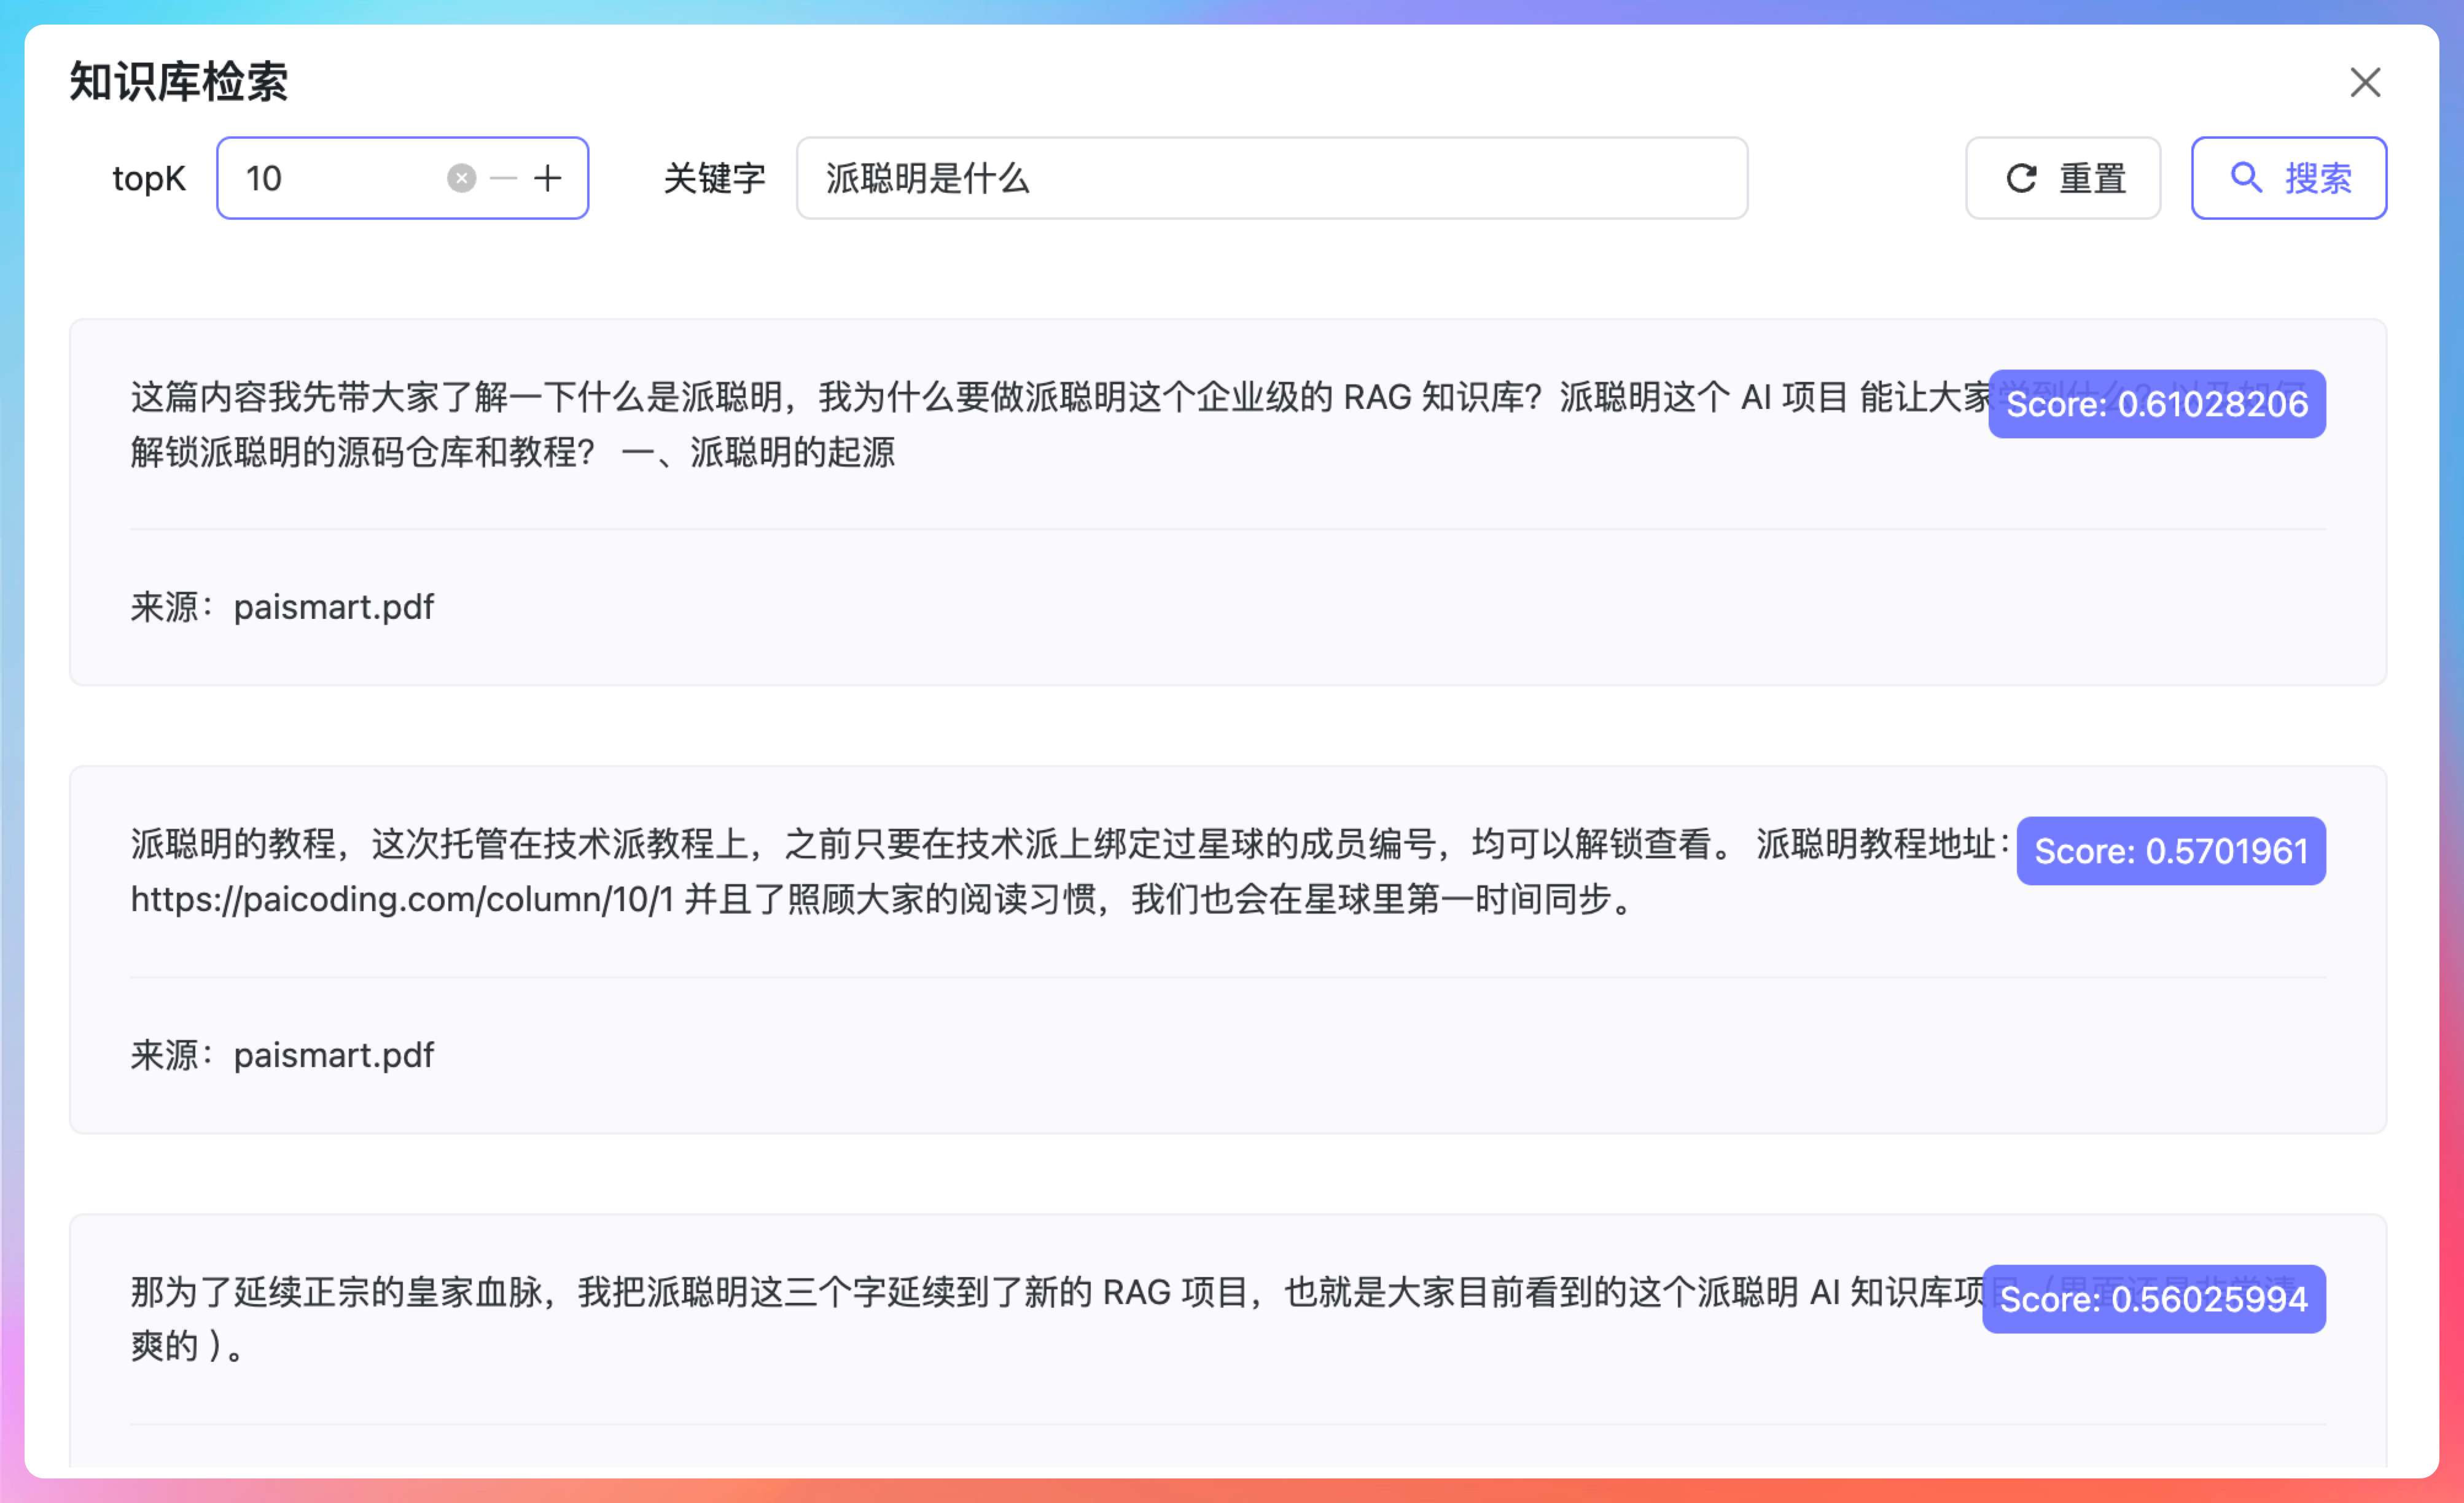
透过厚厚的近视镜片,我触碰到了老王那对世界仍然充满热情的双眼,我懂他想要的答案:“必须啊,混合检索用到了向量和关键字,和我做的派聪明 RAG 有着异曲同工之妙,也有 FTS5、BM25、rerank 这些。”
“你小子,看来是做了功课的。”老王扶了扶他的眼镜,搓了搓他的手继续问,“OpenClaw 的 Memory 分了两层,一层是会话级别的,一层是长期记忆的,他们之间有什么区别?”
不得承认,老王不是那种浮在表面的面试官,是真的有研究过,对技术有渴望的人。
content
01、Memory 和 Session 的区别?
“王哥,Memory 是 OpenClaw 最核心的机制之一,它让 Agent 有了‘记忆’的能力。”
短期记忆
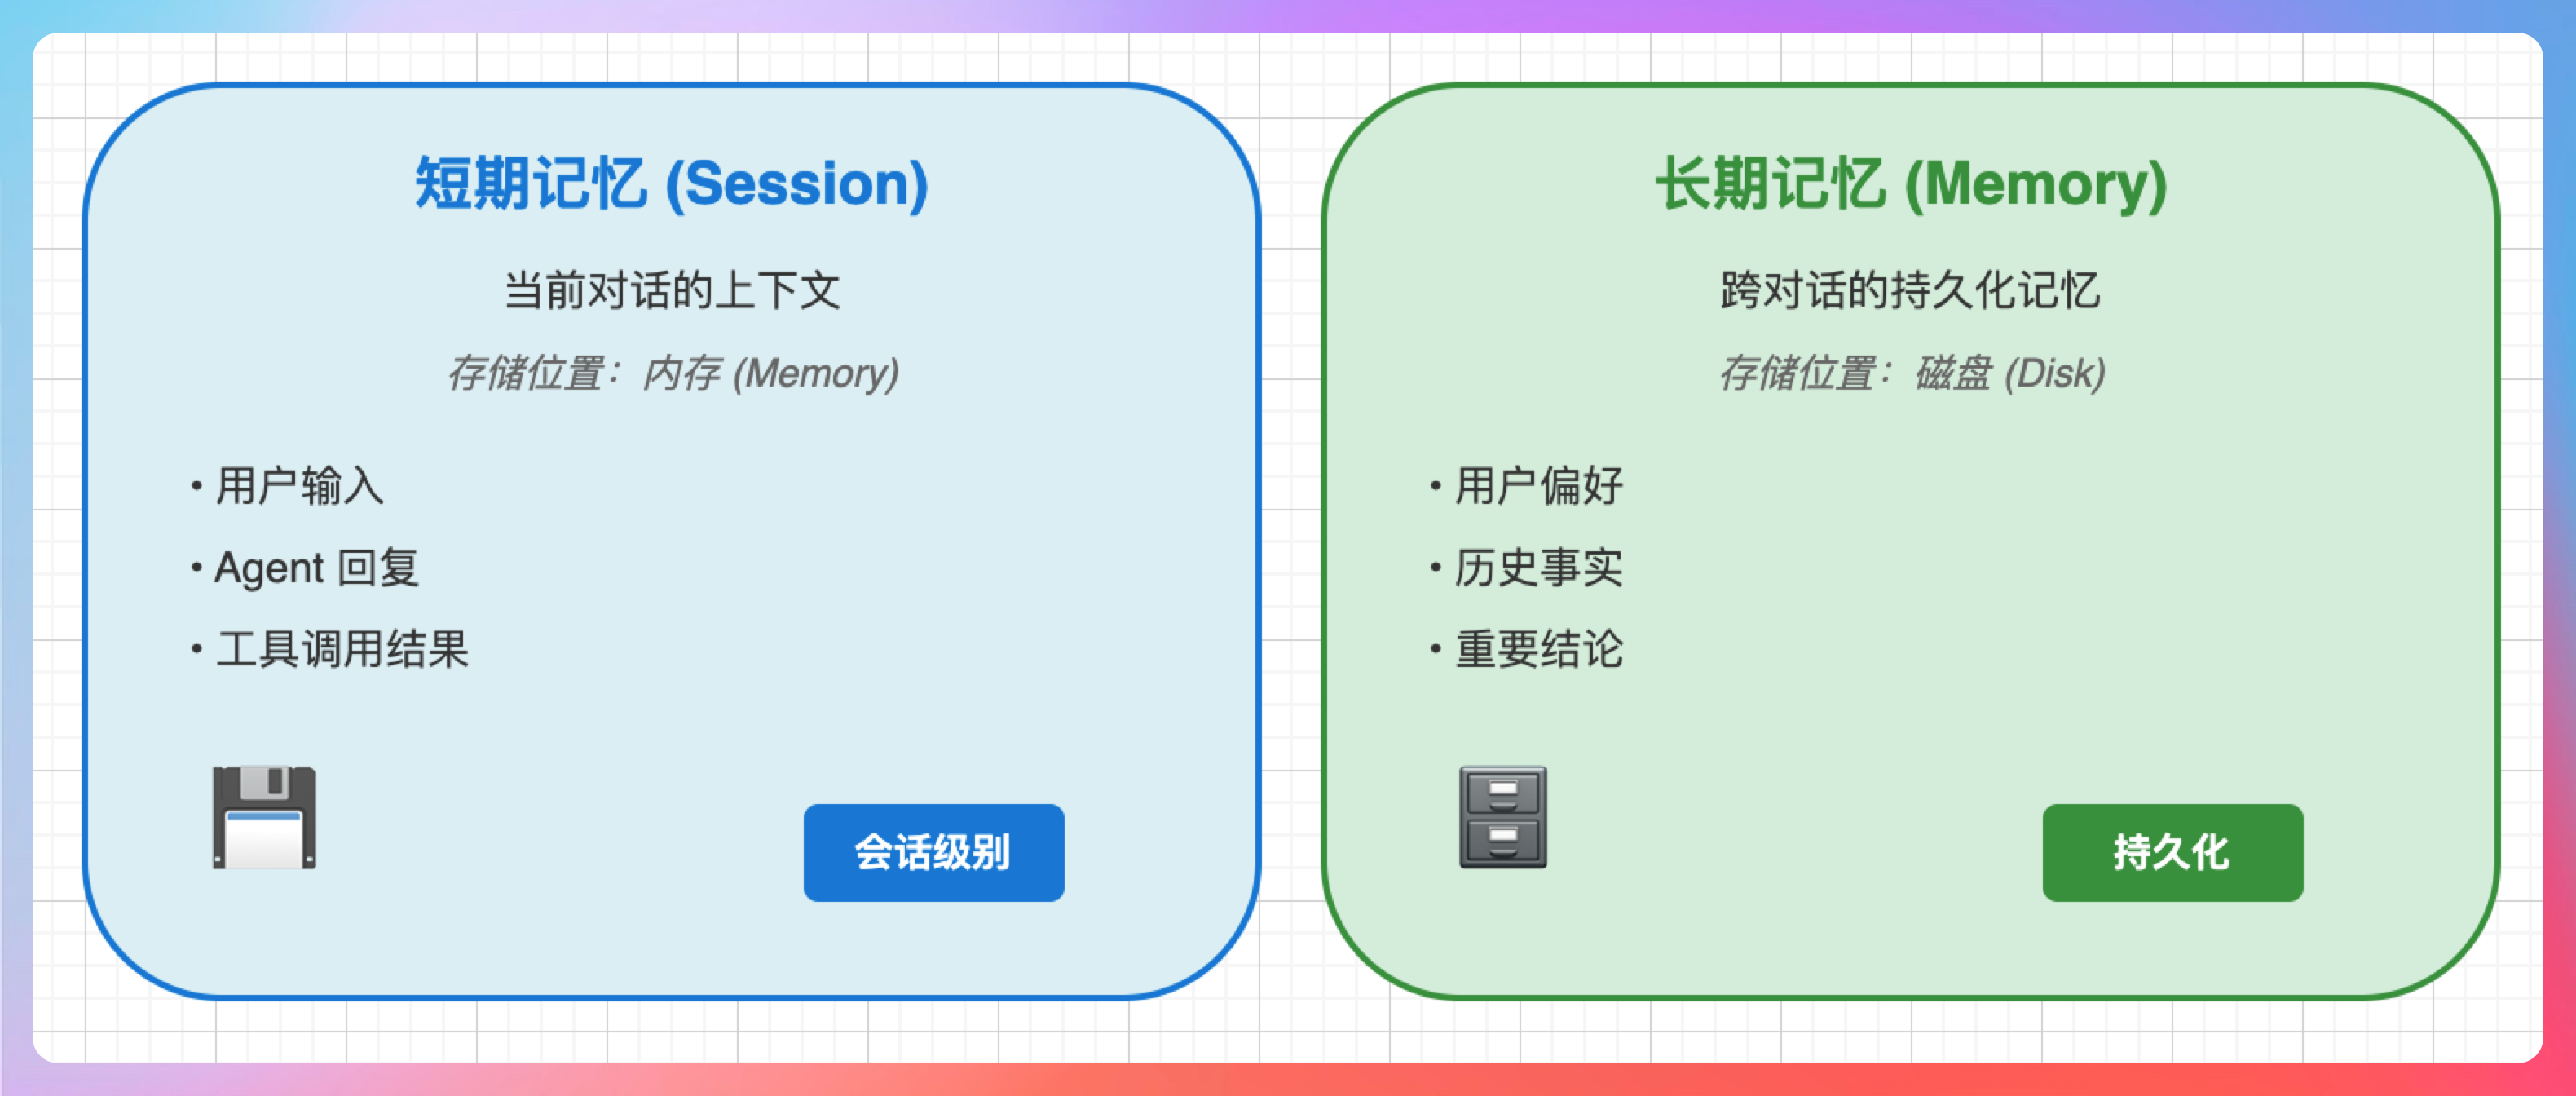
短期记忆存储在~/.openclaw/agents/{agentId}/sessions/*.jsonl文件中,自动记录。
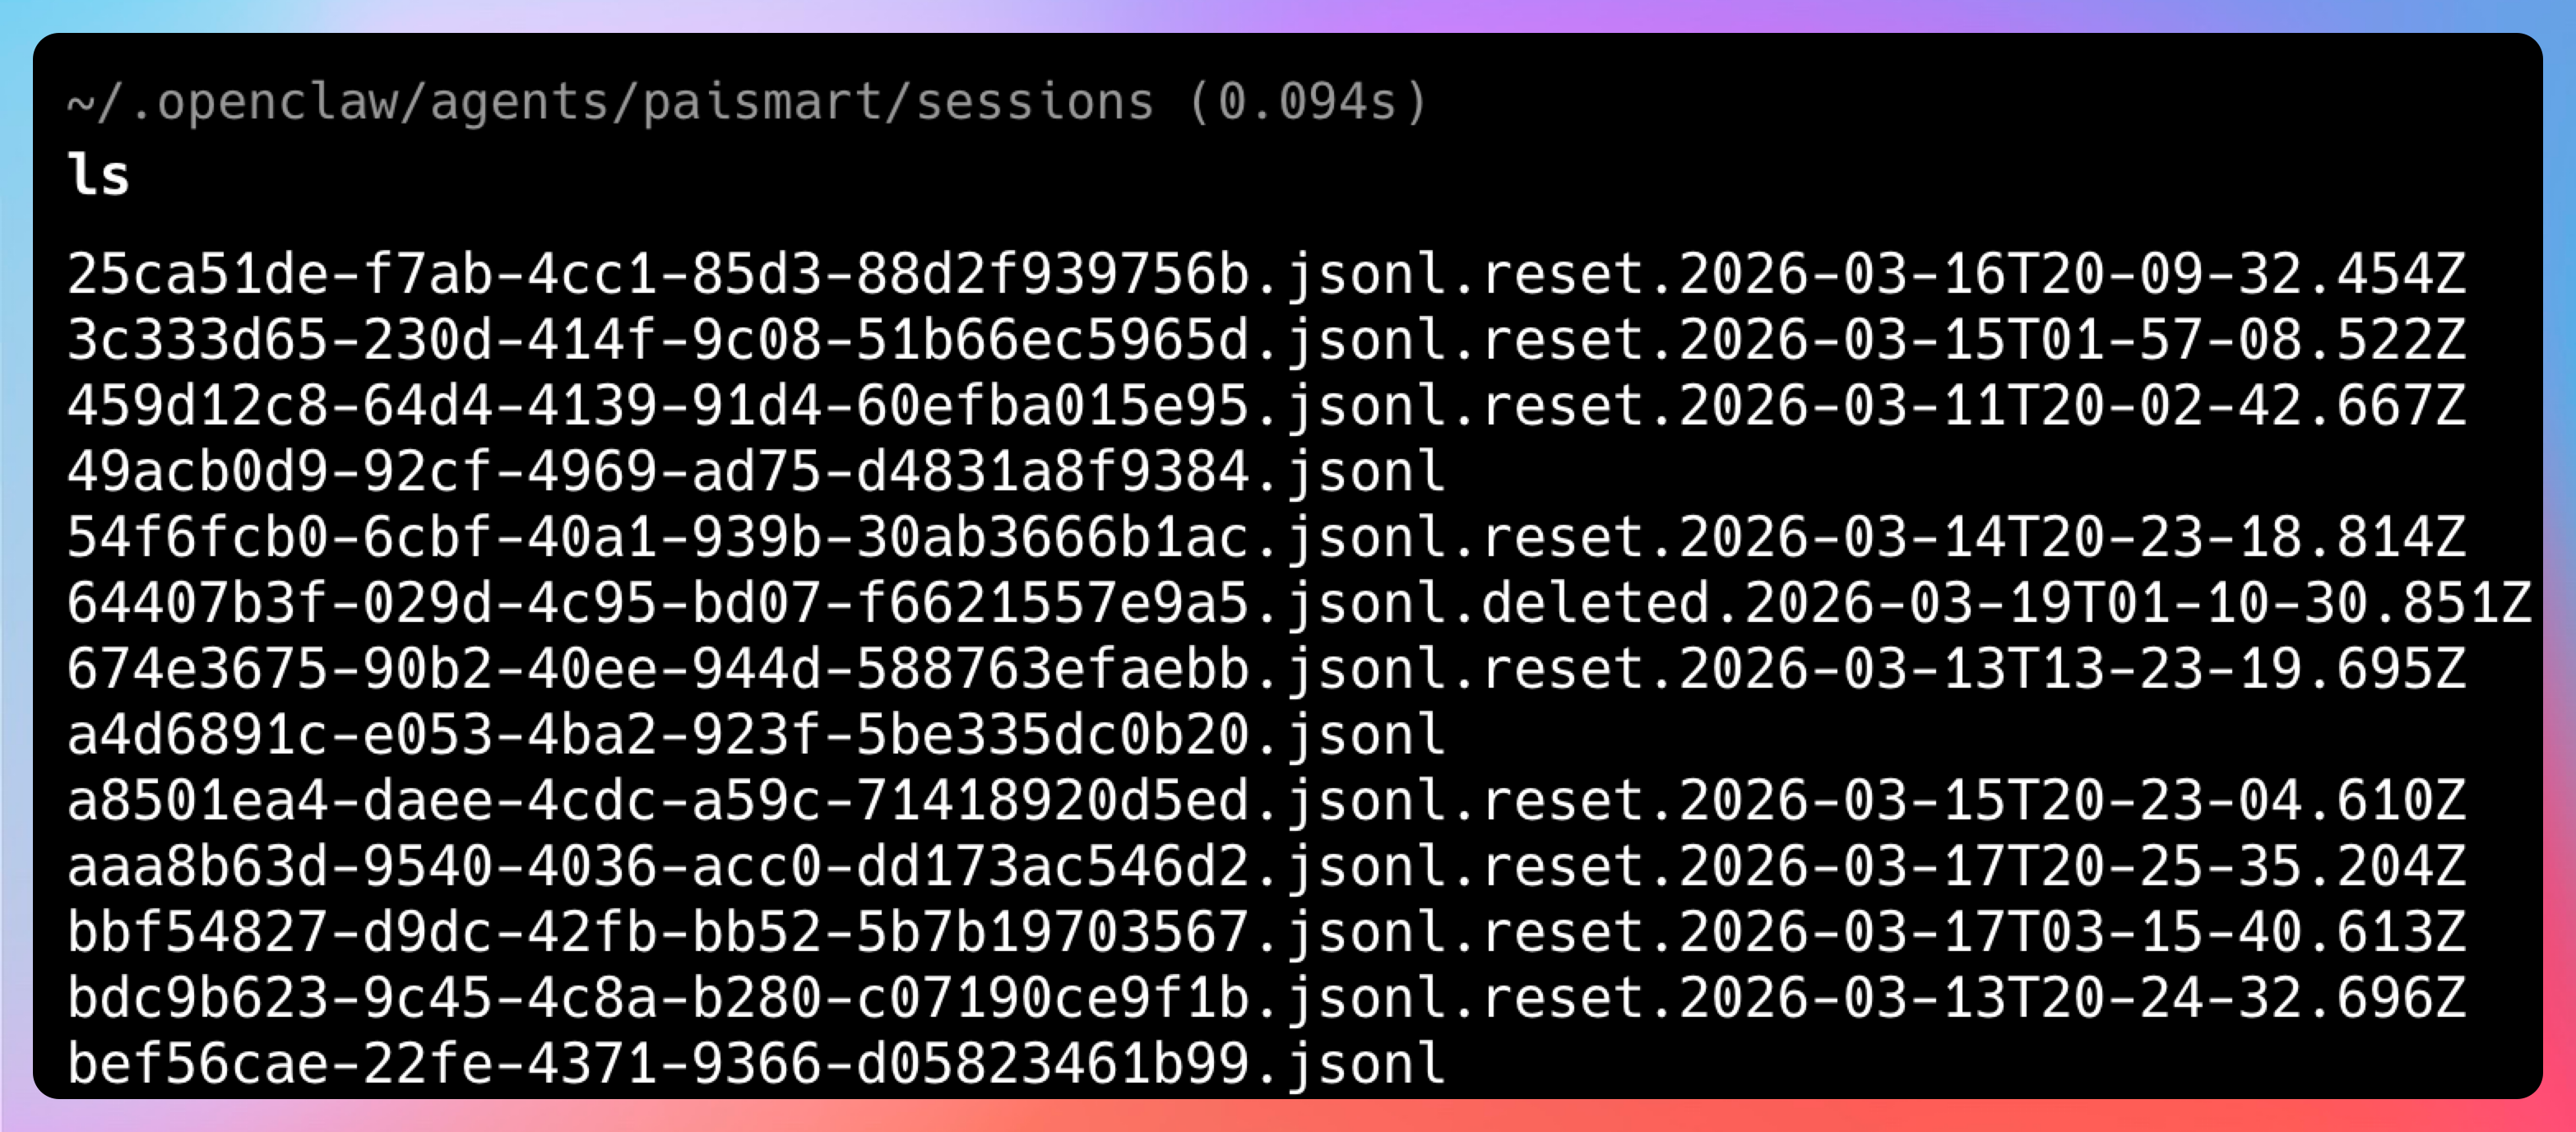
每次和龙虾对话,OpenClaw 就会自动将对话内容追加到 JSONL 格式的会话日志文件中,这是最原始的、未经处理过的记忆。
长期记忆
长期记忆存储在~/.openclaw/workspace/MEMORY.md和memory/*.md文件中,可以手动创建,但一般交给 OpenClaw 自动生成。
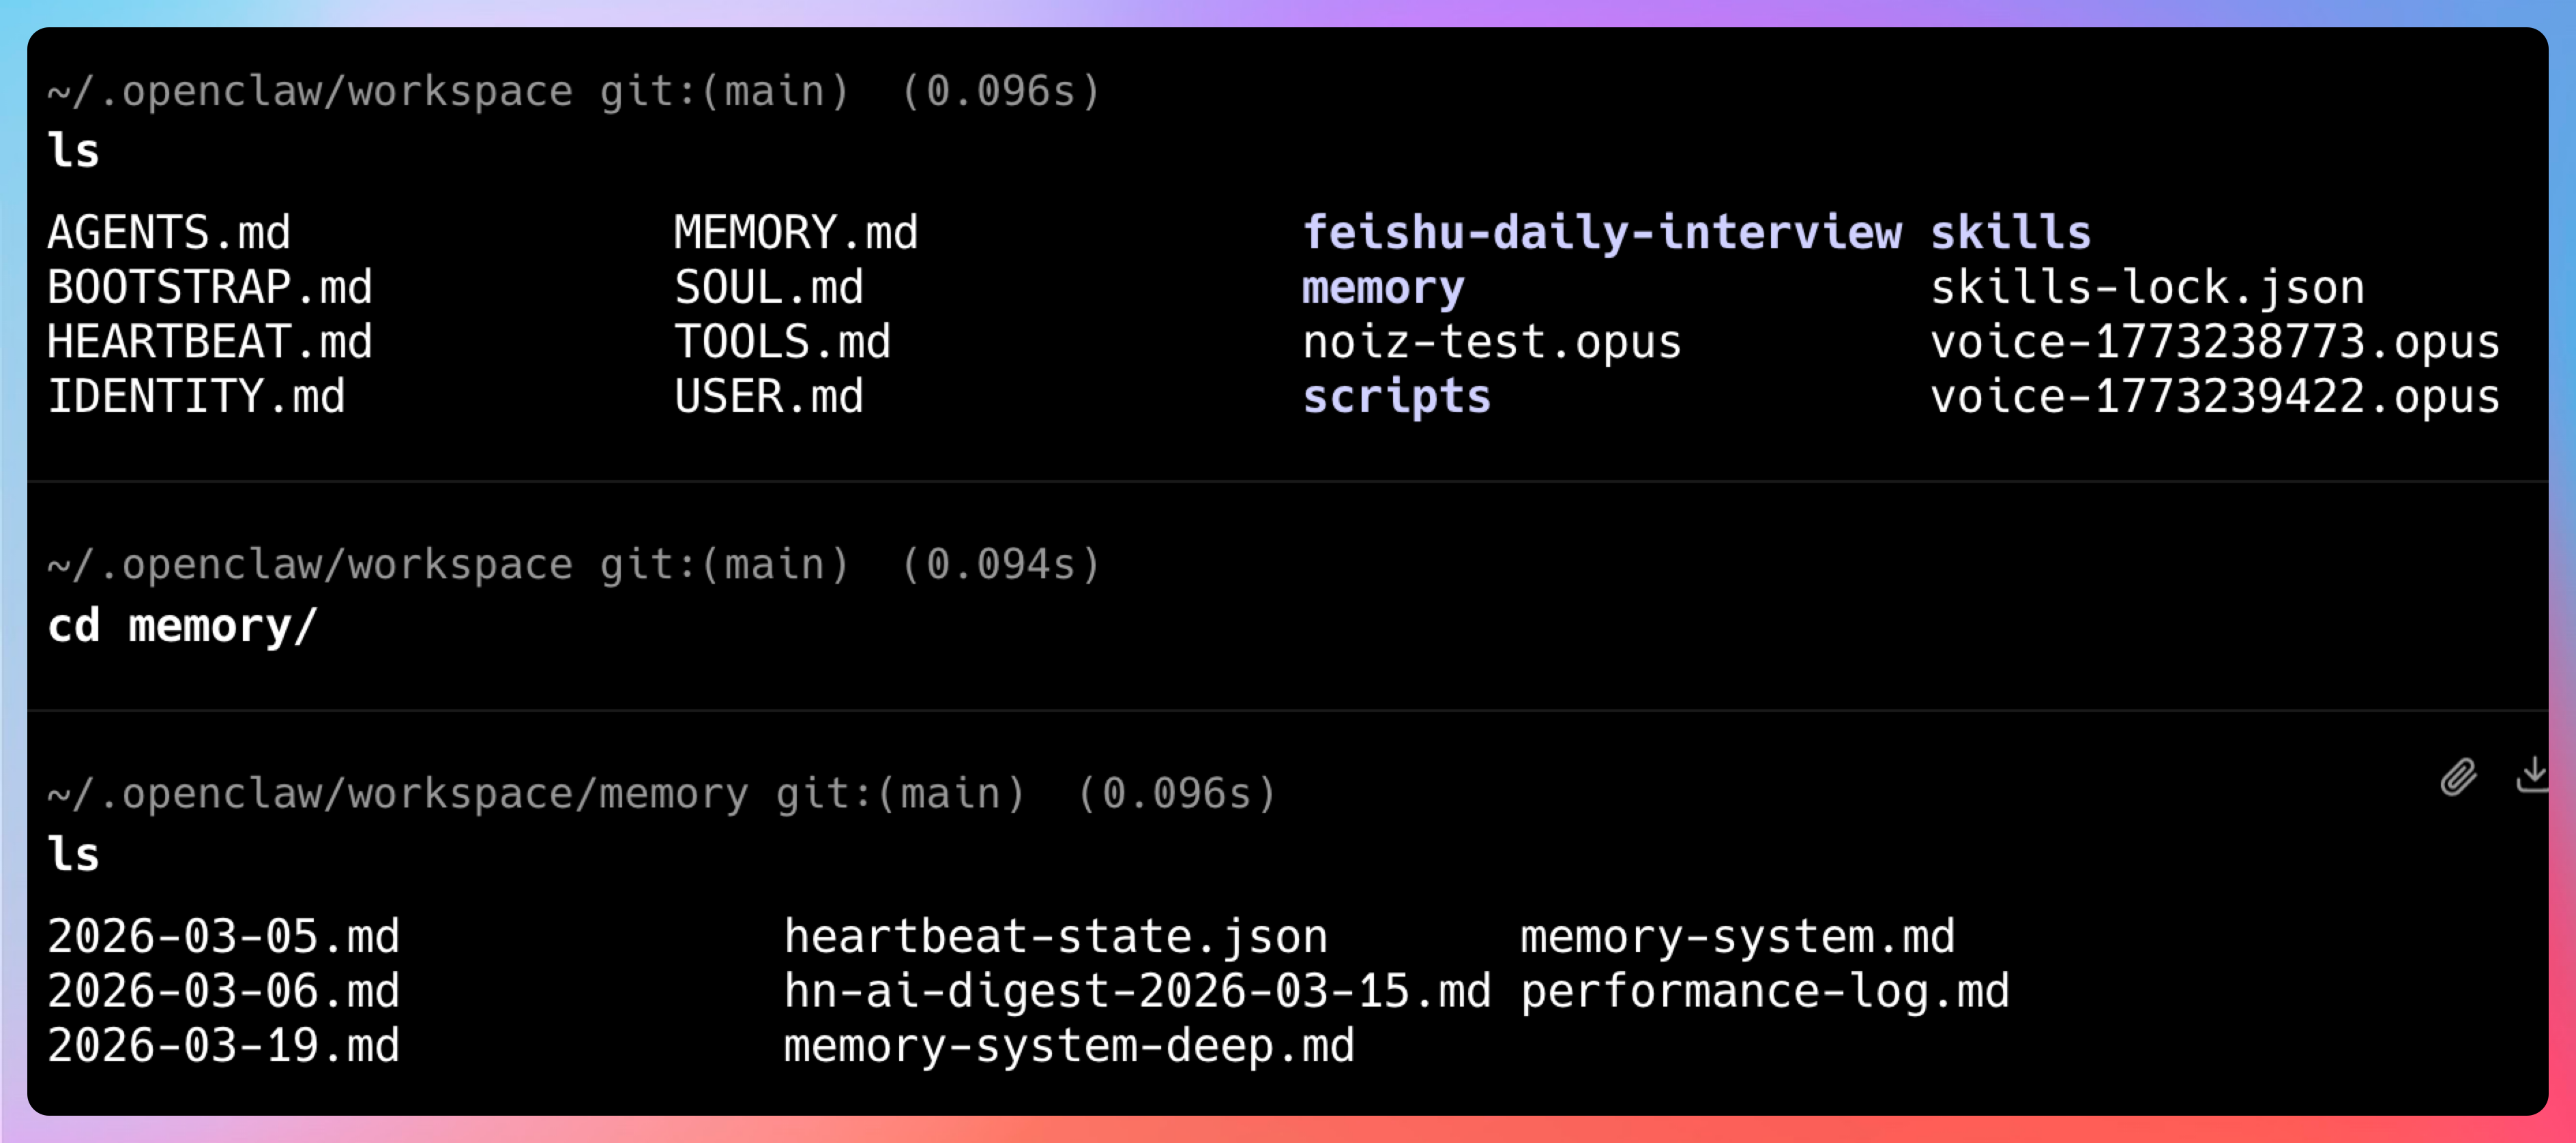
可以理解成是从短期的琐碎记忆中提炼出来的需要 OpenClaw 重点记住的内容,比如用户的性格、身份信息、回答偏好等。
举个例子,你告诉 Agent:“我是 Java 后端开发,回答问题时请用 Java 相关技术栈。”这句话就会被提炼成长期记忆,存储在 Markdown 文件中。下次对话时,龙虾会自动检索到这条记忆,按照你的偏好回答。
老王追问:“那长期记忆和短期记忆之间是怎么转换的?”
我说:“王哥,有研究啊。”
02、记忆是如何自动转换的?
“记忆转换有两种触发机制。”
机制一:session-memory Hook
当用户执行/new命令重置会话时,OpenClaw 会触发 session-memory Hook,自动将上一个会话的关键内容转换为 Markdown 文件。
这个过程是自动化的,不需要手动干预。系统会分析 JSONL 文件中的对话内容,提取出关键信息,比如用户的偏好、重要的上下文、需要长期记住的事实等,然后写入memory/YYYY-MM-DD.md文件。
机制二:Memory Flush
这是一个非常关键的自动化机制。
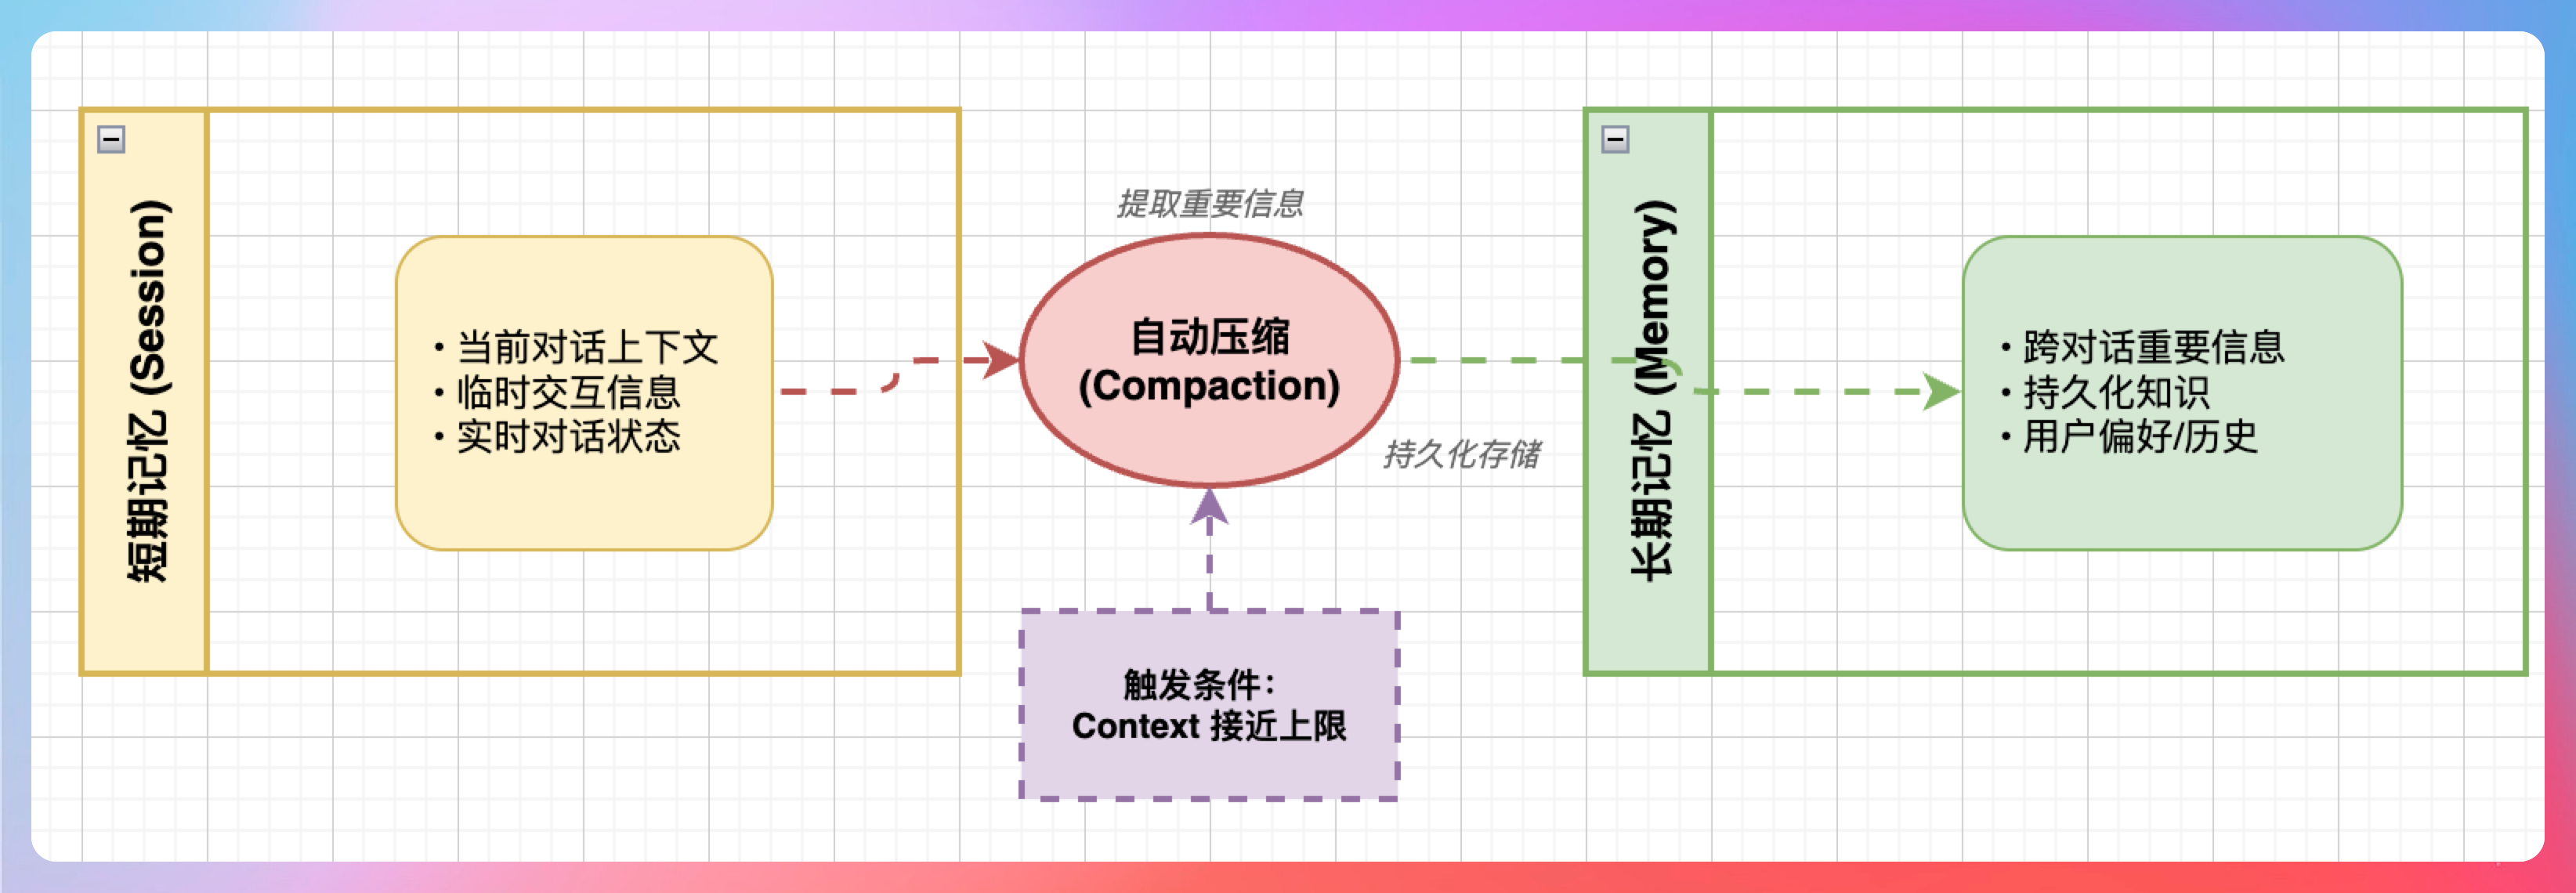
当 Session 接近 context 上限时,OpenClaw 会触发 Compaction 机制。Agent 会分析当前 Session 的内容,提取重要信息,写入 Memory。
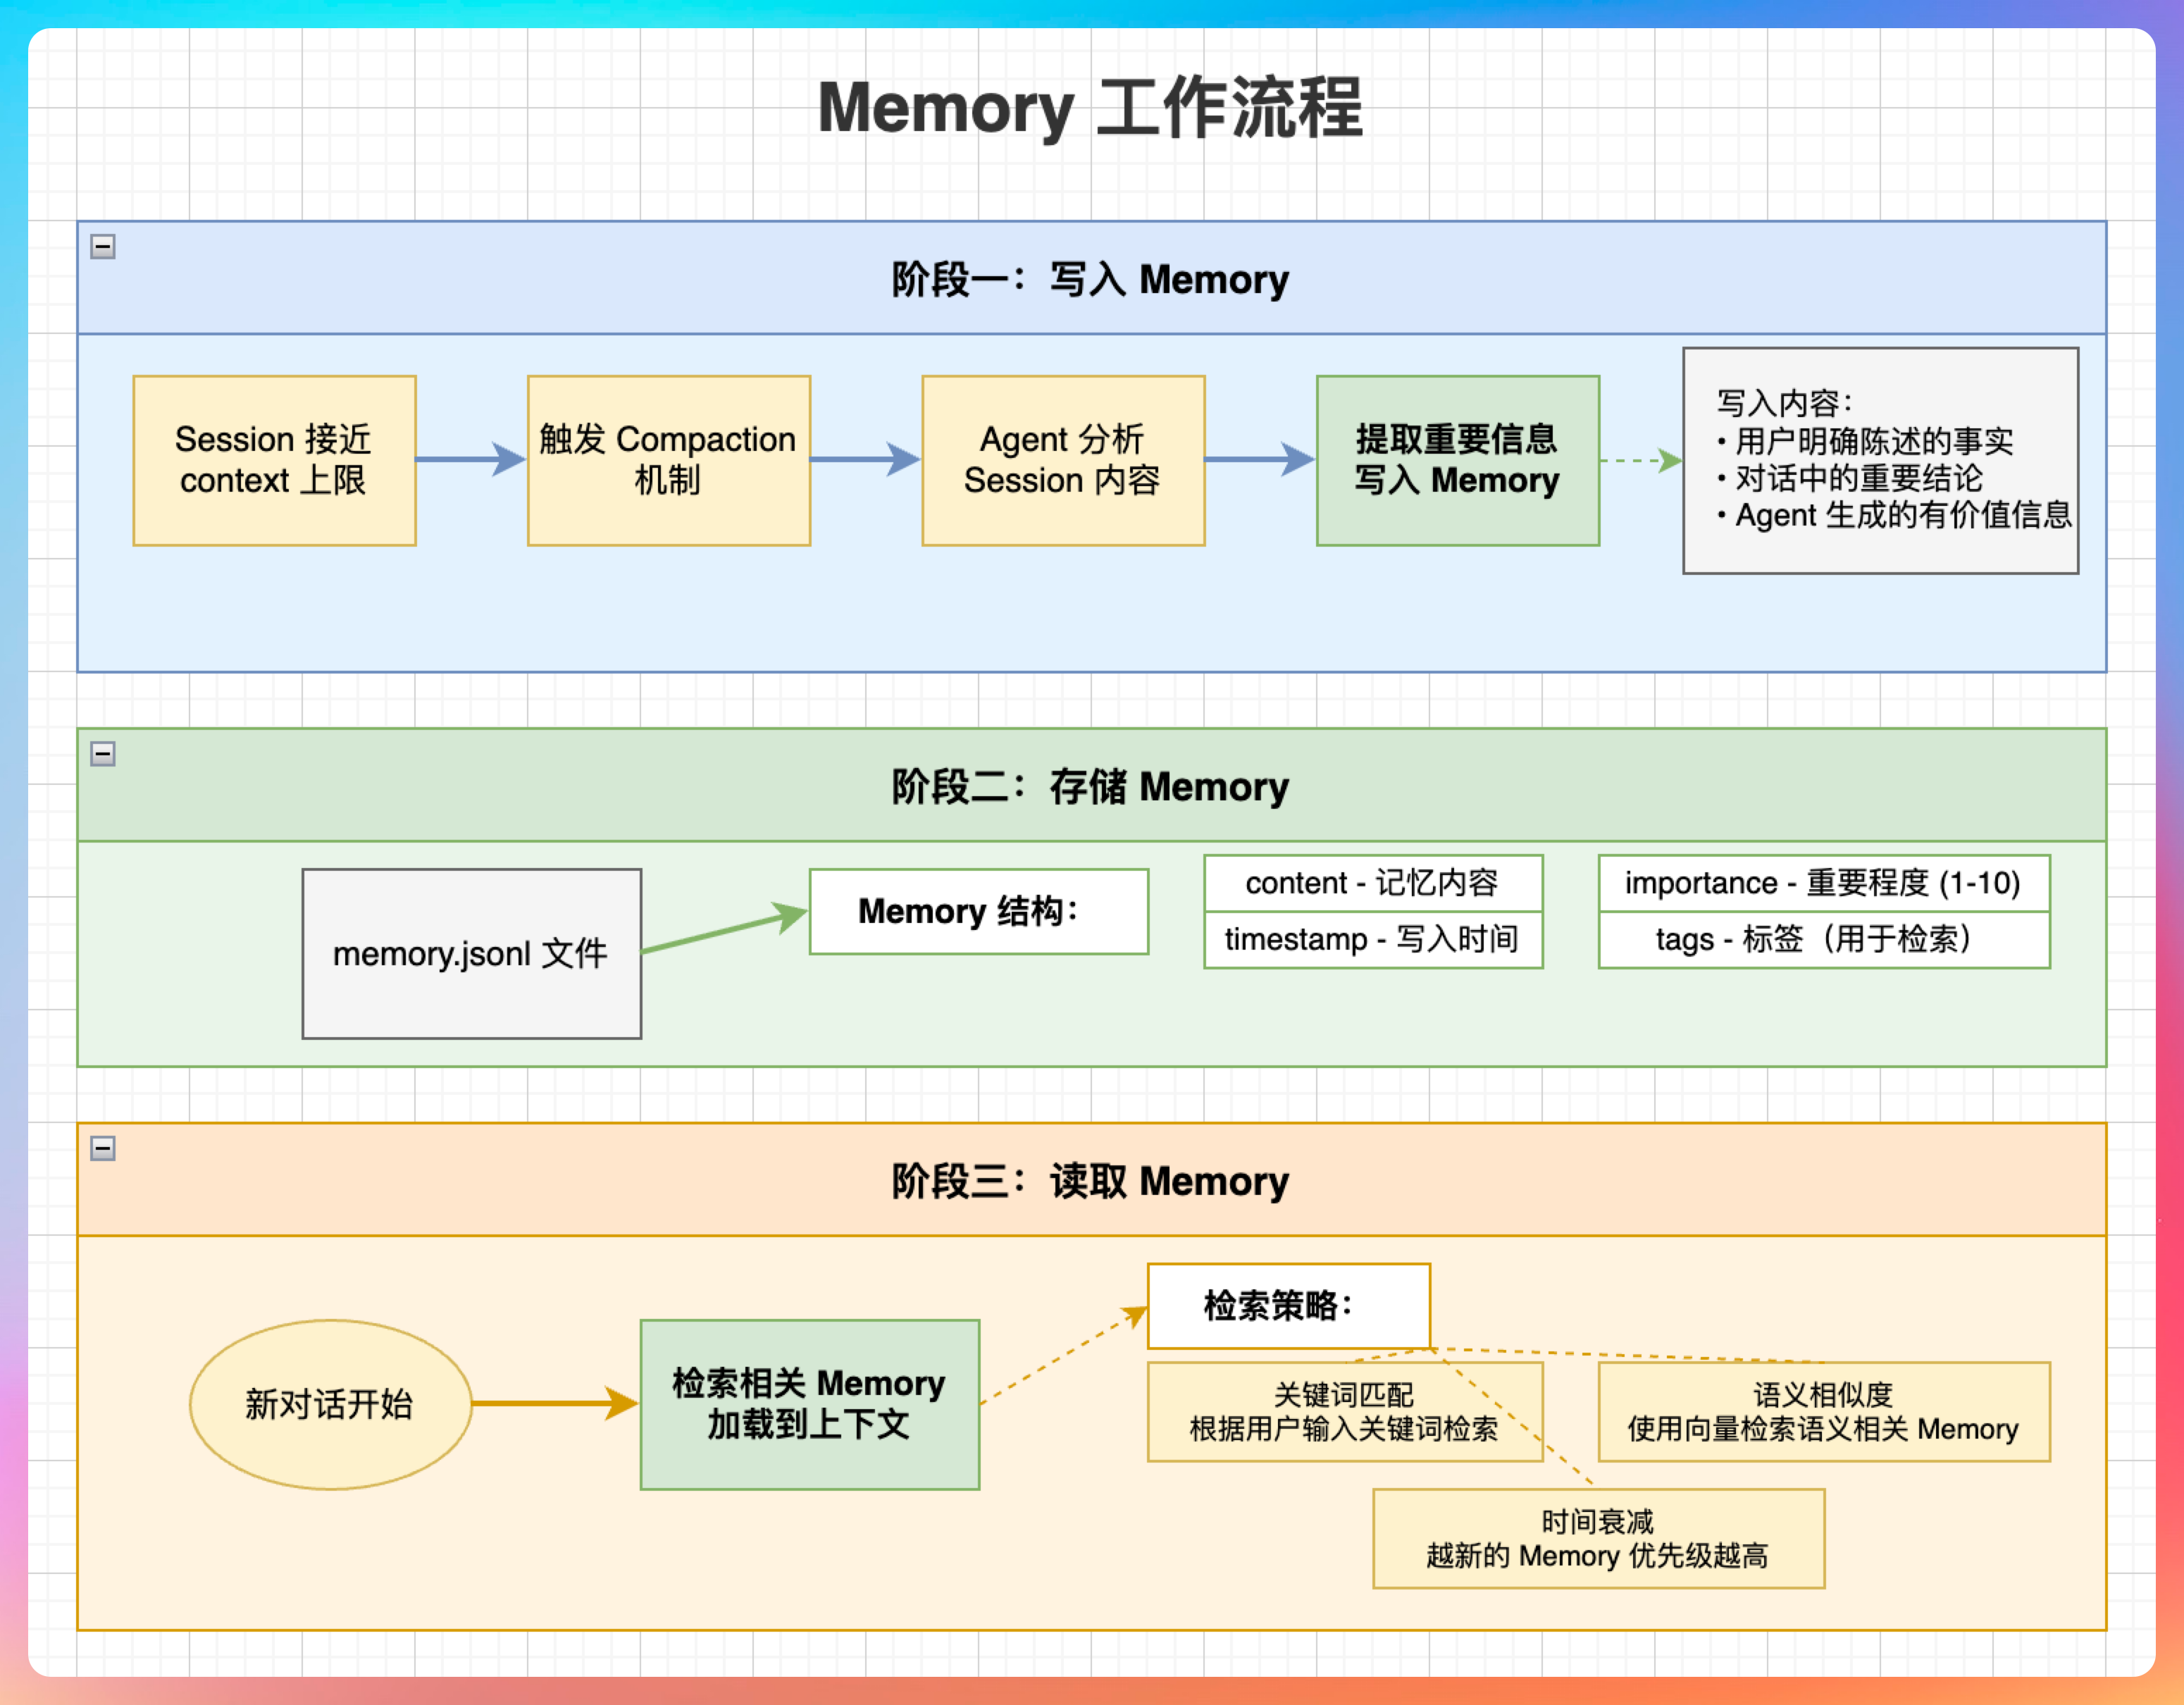
老王点点头:“那这些 Markdown 文件是怎么被检索的?总不能每次都遍历所有文件吧?”
03、Memory 的索引到底是怎么建起来的?
“王哥,真正难的不是‘记下来’,而是‘下次还能在几百份文件里把它找回来’。”
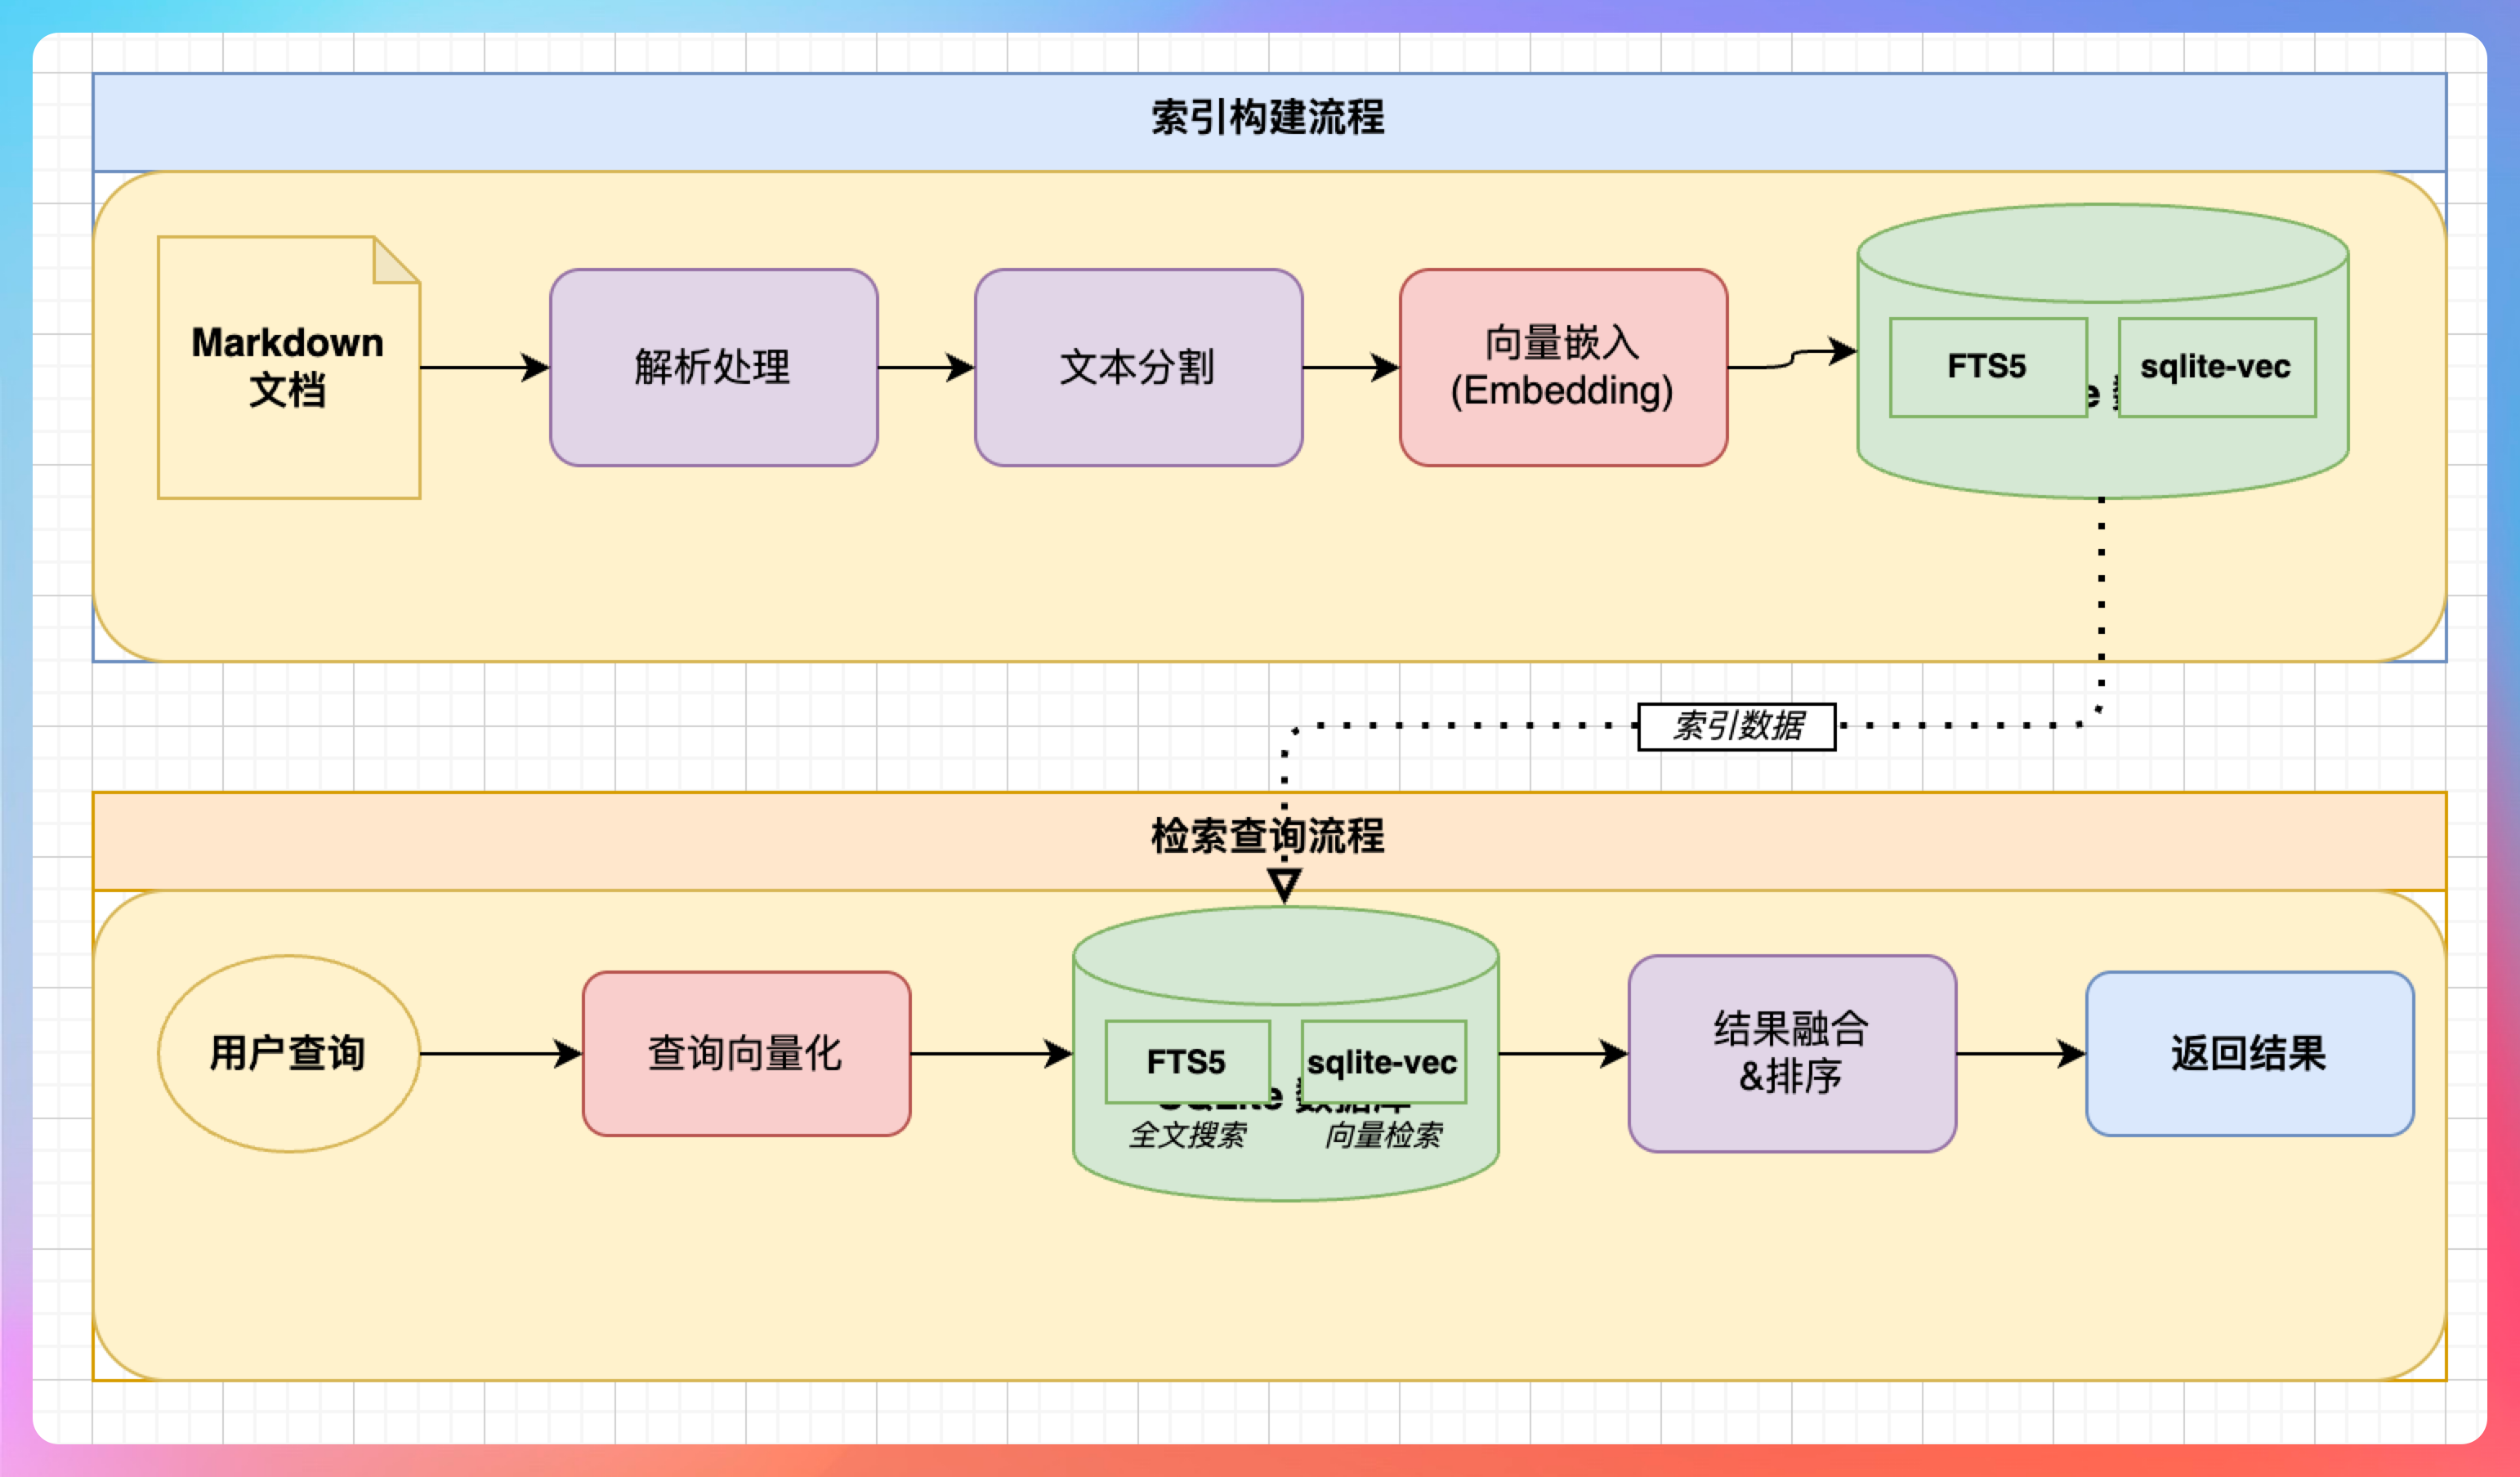
OpenClaw 是这样处理 Memory 的:
- Markdown 文件是记忆本体,也就是 source of truth。
- SQLite 是加速层,负责把这些 Markdown 变成“可检索”的东西。
不了解的人会以为 SQLite 就是 Memory 本身,但其实不是。
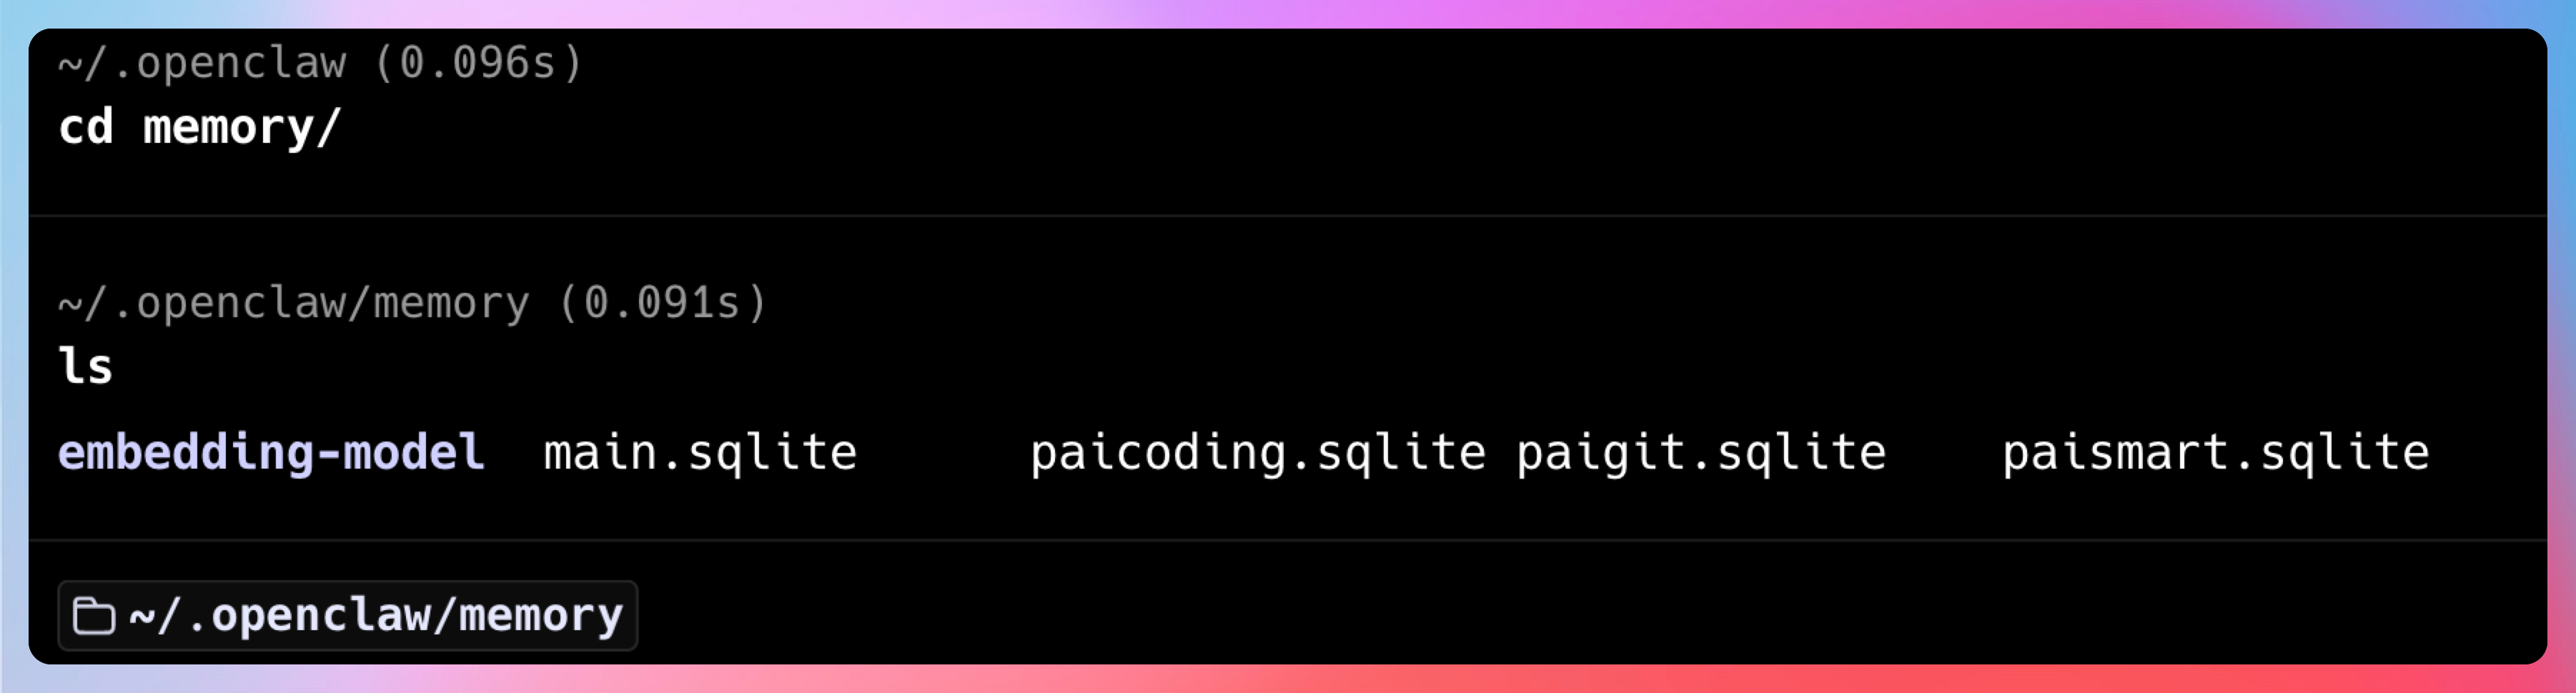
那些 markdown 文件才是 Memory 本身,其中
MEMORY.md:记录的是长期记忆,偏“结论”和“偏好”memory/YYYY-MM-DD.md属于日记式记忆,偏“当天发生了什么”
OpenClaw 不是“每次查询时去扫描一遍目录”,而是提前把 Markdown 切块、建索引、落到 SQLite 文件里。等 Agent 真要查历史时,直接查索引就行,不仅可以查关键字,还可以查语义,这样的 Agent 就很智能。
从命令行看也更直观:
openclaw memory status
这条命令会告诉我们现在 Memory 能不能用,正在用什么模型,索引建了多少,库文件放在哪,全文检索和向量检索是不是正常。
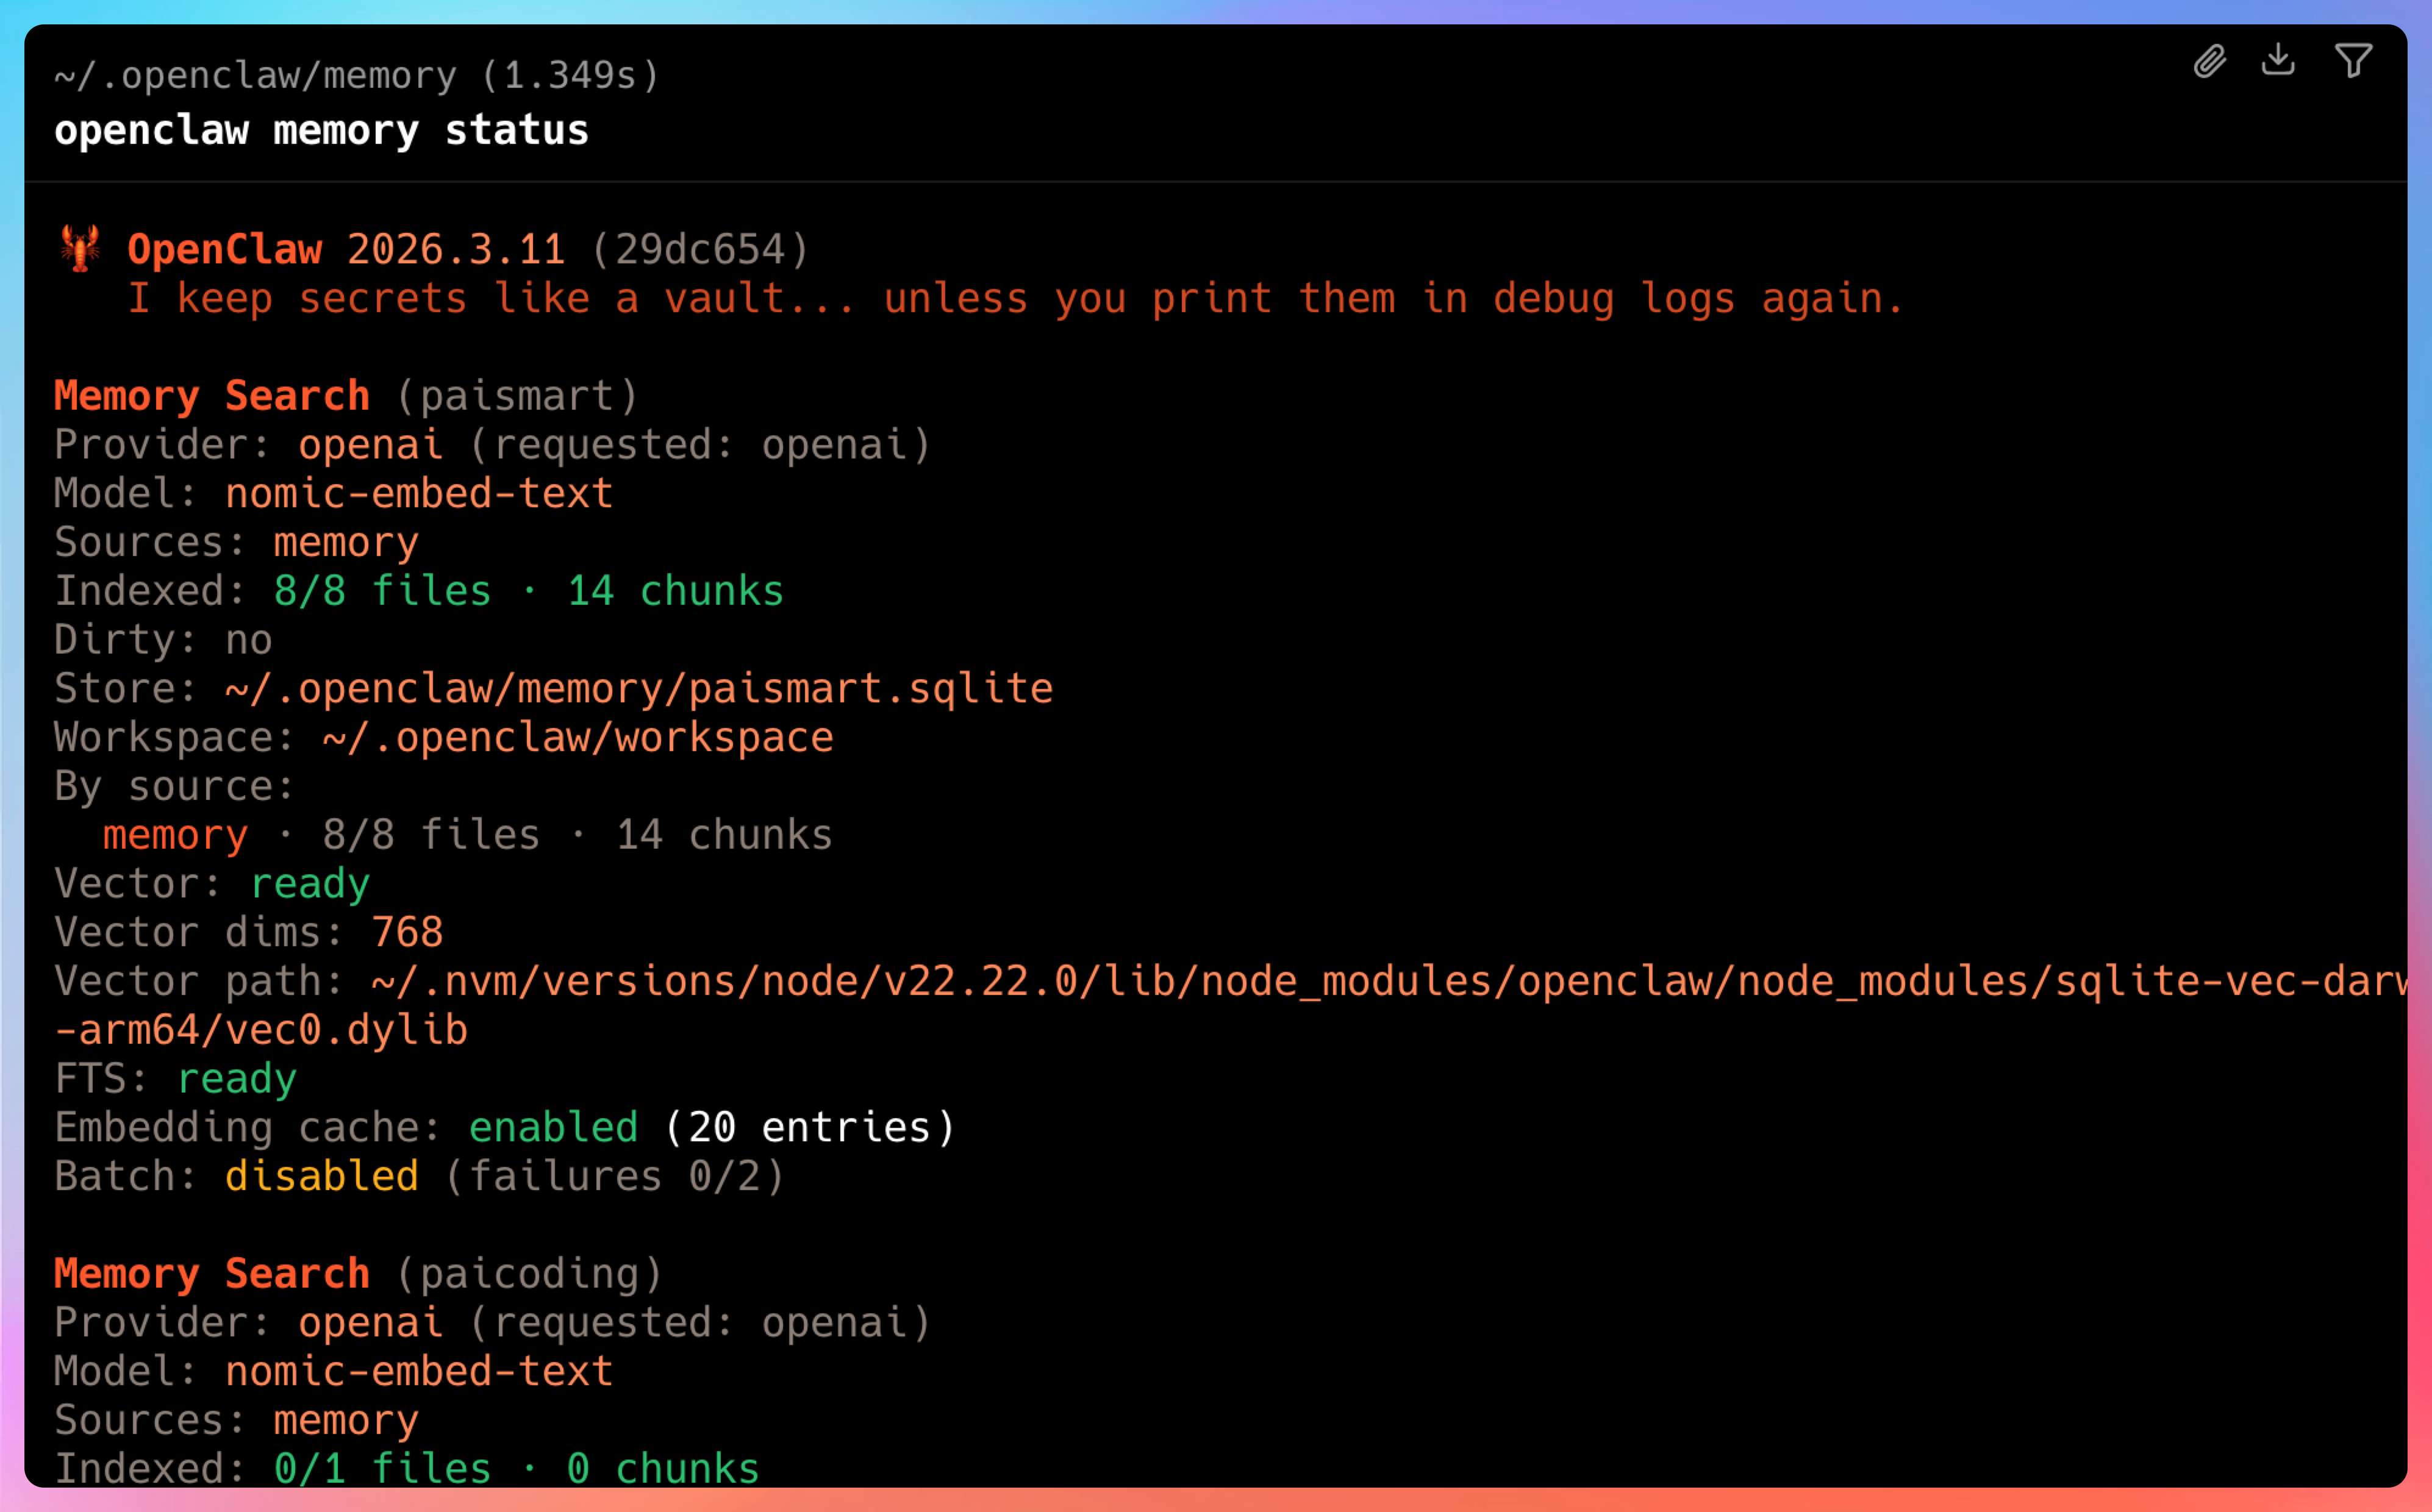
我这台机器当前看到的是:
Provider: openai (requested: openai)
Model: nomic-embed-text
Store: ~/.openclaw/memory/paismart.sqlite
Indexed: 8/8 files · 14 chunks
Vector: ready
FTS: ready
Provider: openai (requested: openai) 表示memory 用的 embedding 提供方是 openai 这一套接口。
Model: nomic-embed-text 说明实际拿来做向量的模型,是 nomic-embed-text。
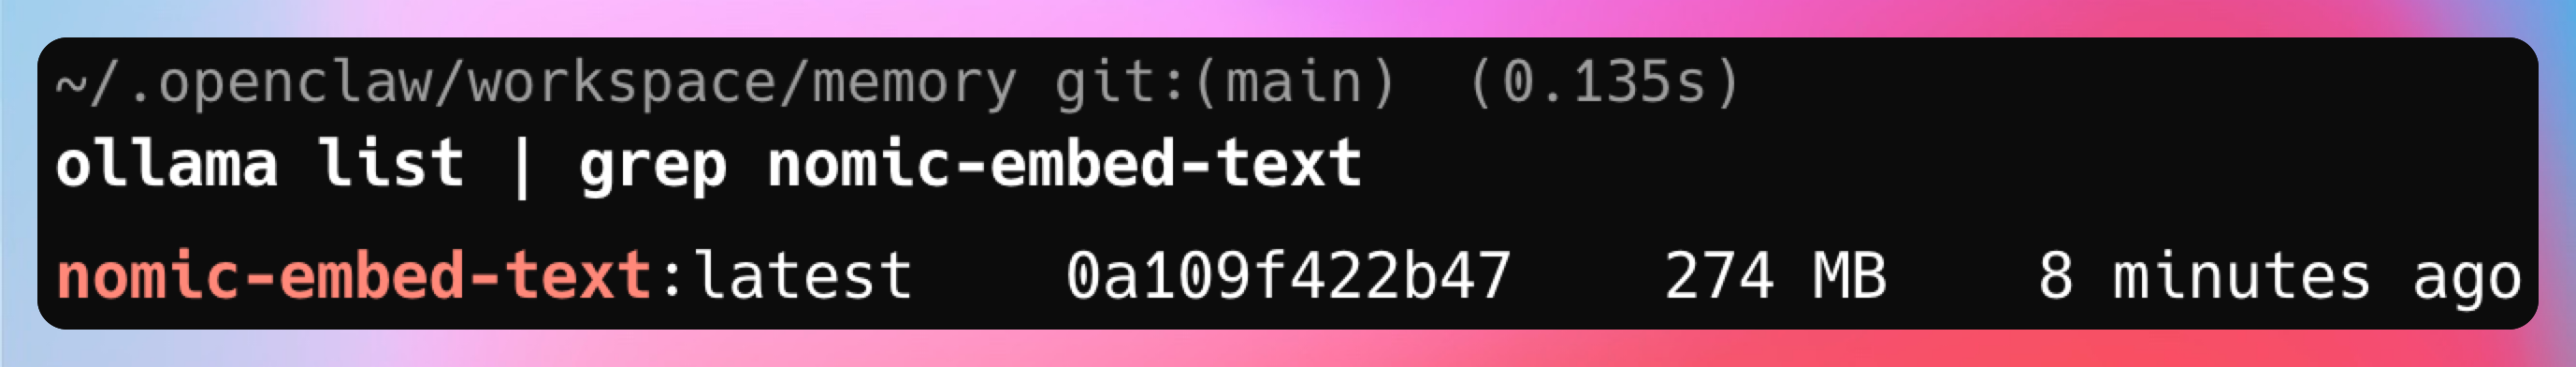
Store: ~/.openclaw/memory/paismart.sqlite 表示 memory 索引实际存在这个 SQLite 文件里。
Indexed: 8/8 files · 14 chunks 意思是一共发现了 8 个 memory 文件,这 8 个都已经建好索引,总共切成了 14 个文本块。
Vector: ready 表示向量检索正常,也就是语义搜索这部分是能工作的。
FTS: ready 表示全文检索也正常。FTS 就是 Full-Text Search,全局文本搜索。
老王对我的信任感倍增,接着问:“Embedding时到底做了什么?”
建索引时到底做了什么?
可以分成四步。
第一步,发现。
OpenClaw 会监控 MEMORY.md 和 memory/*.md 的变化。新增了文件,或者文件内容有更新,就把这个文件标记成 dirty,准备重新建索引。
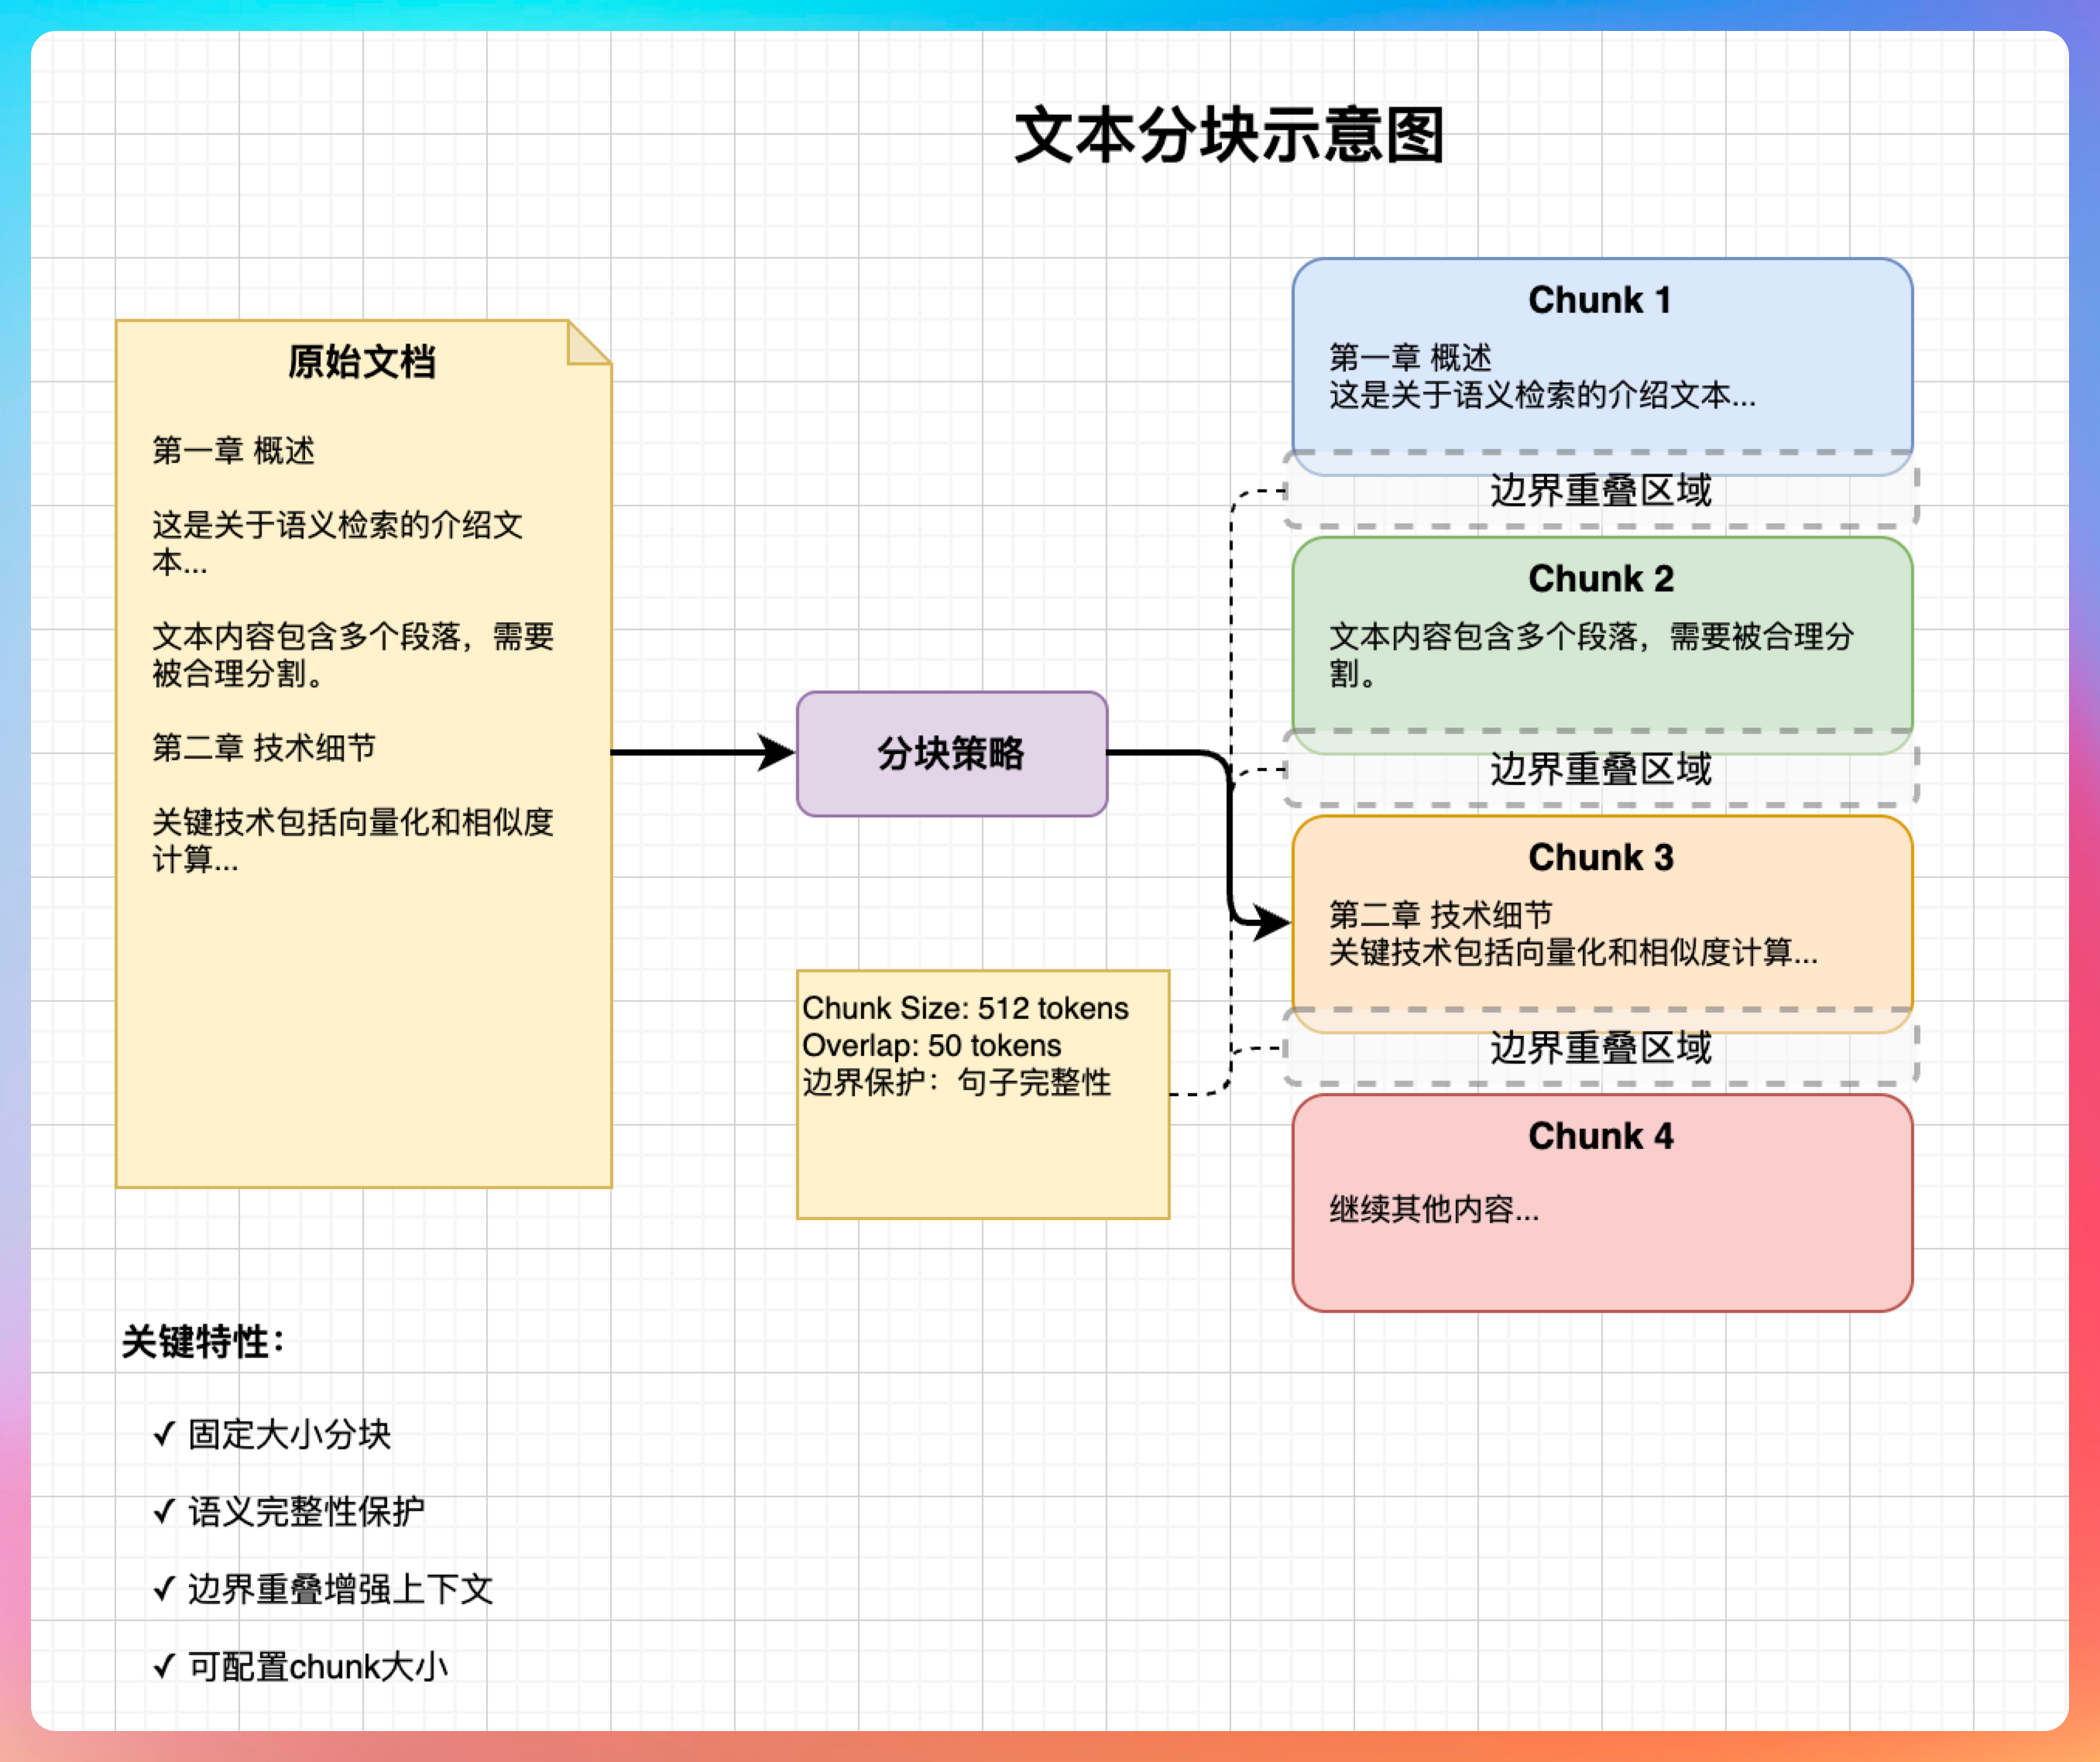
第二步,切块。
把markdown切成多个 chunk,让“一个块只表达一小段相对完整的意思”。
第三步,索引。
每个 chunk 不只会走一遍 embedding,还会同时走全文检索:
- 一路进入 向量索引,负责“意思差不多也能搜出来”
- 一路进入 FTS 全文索引,负责“关键词命中要准确”
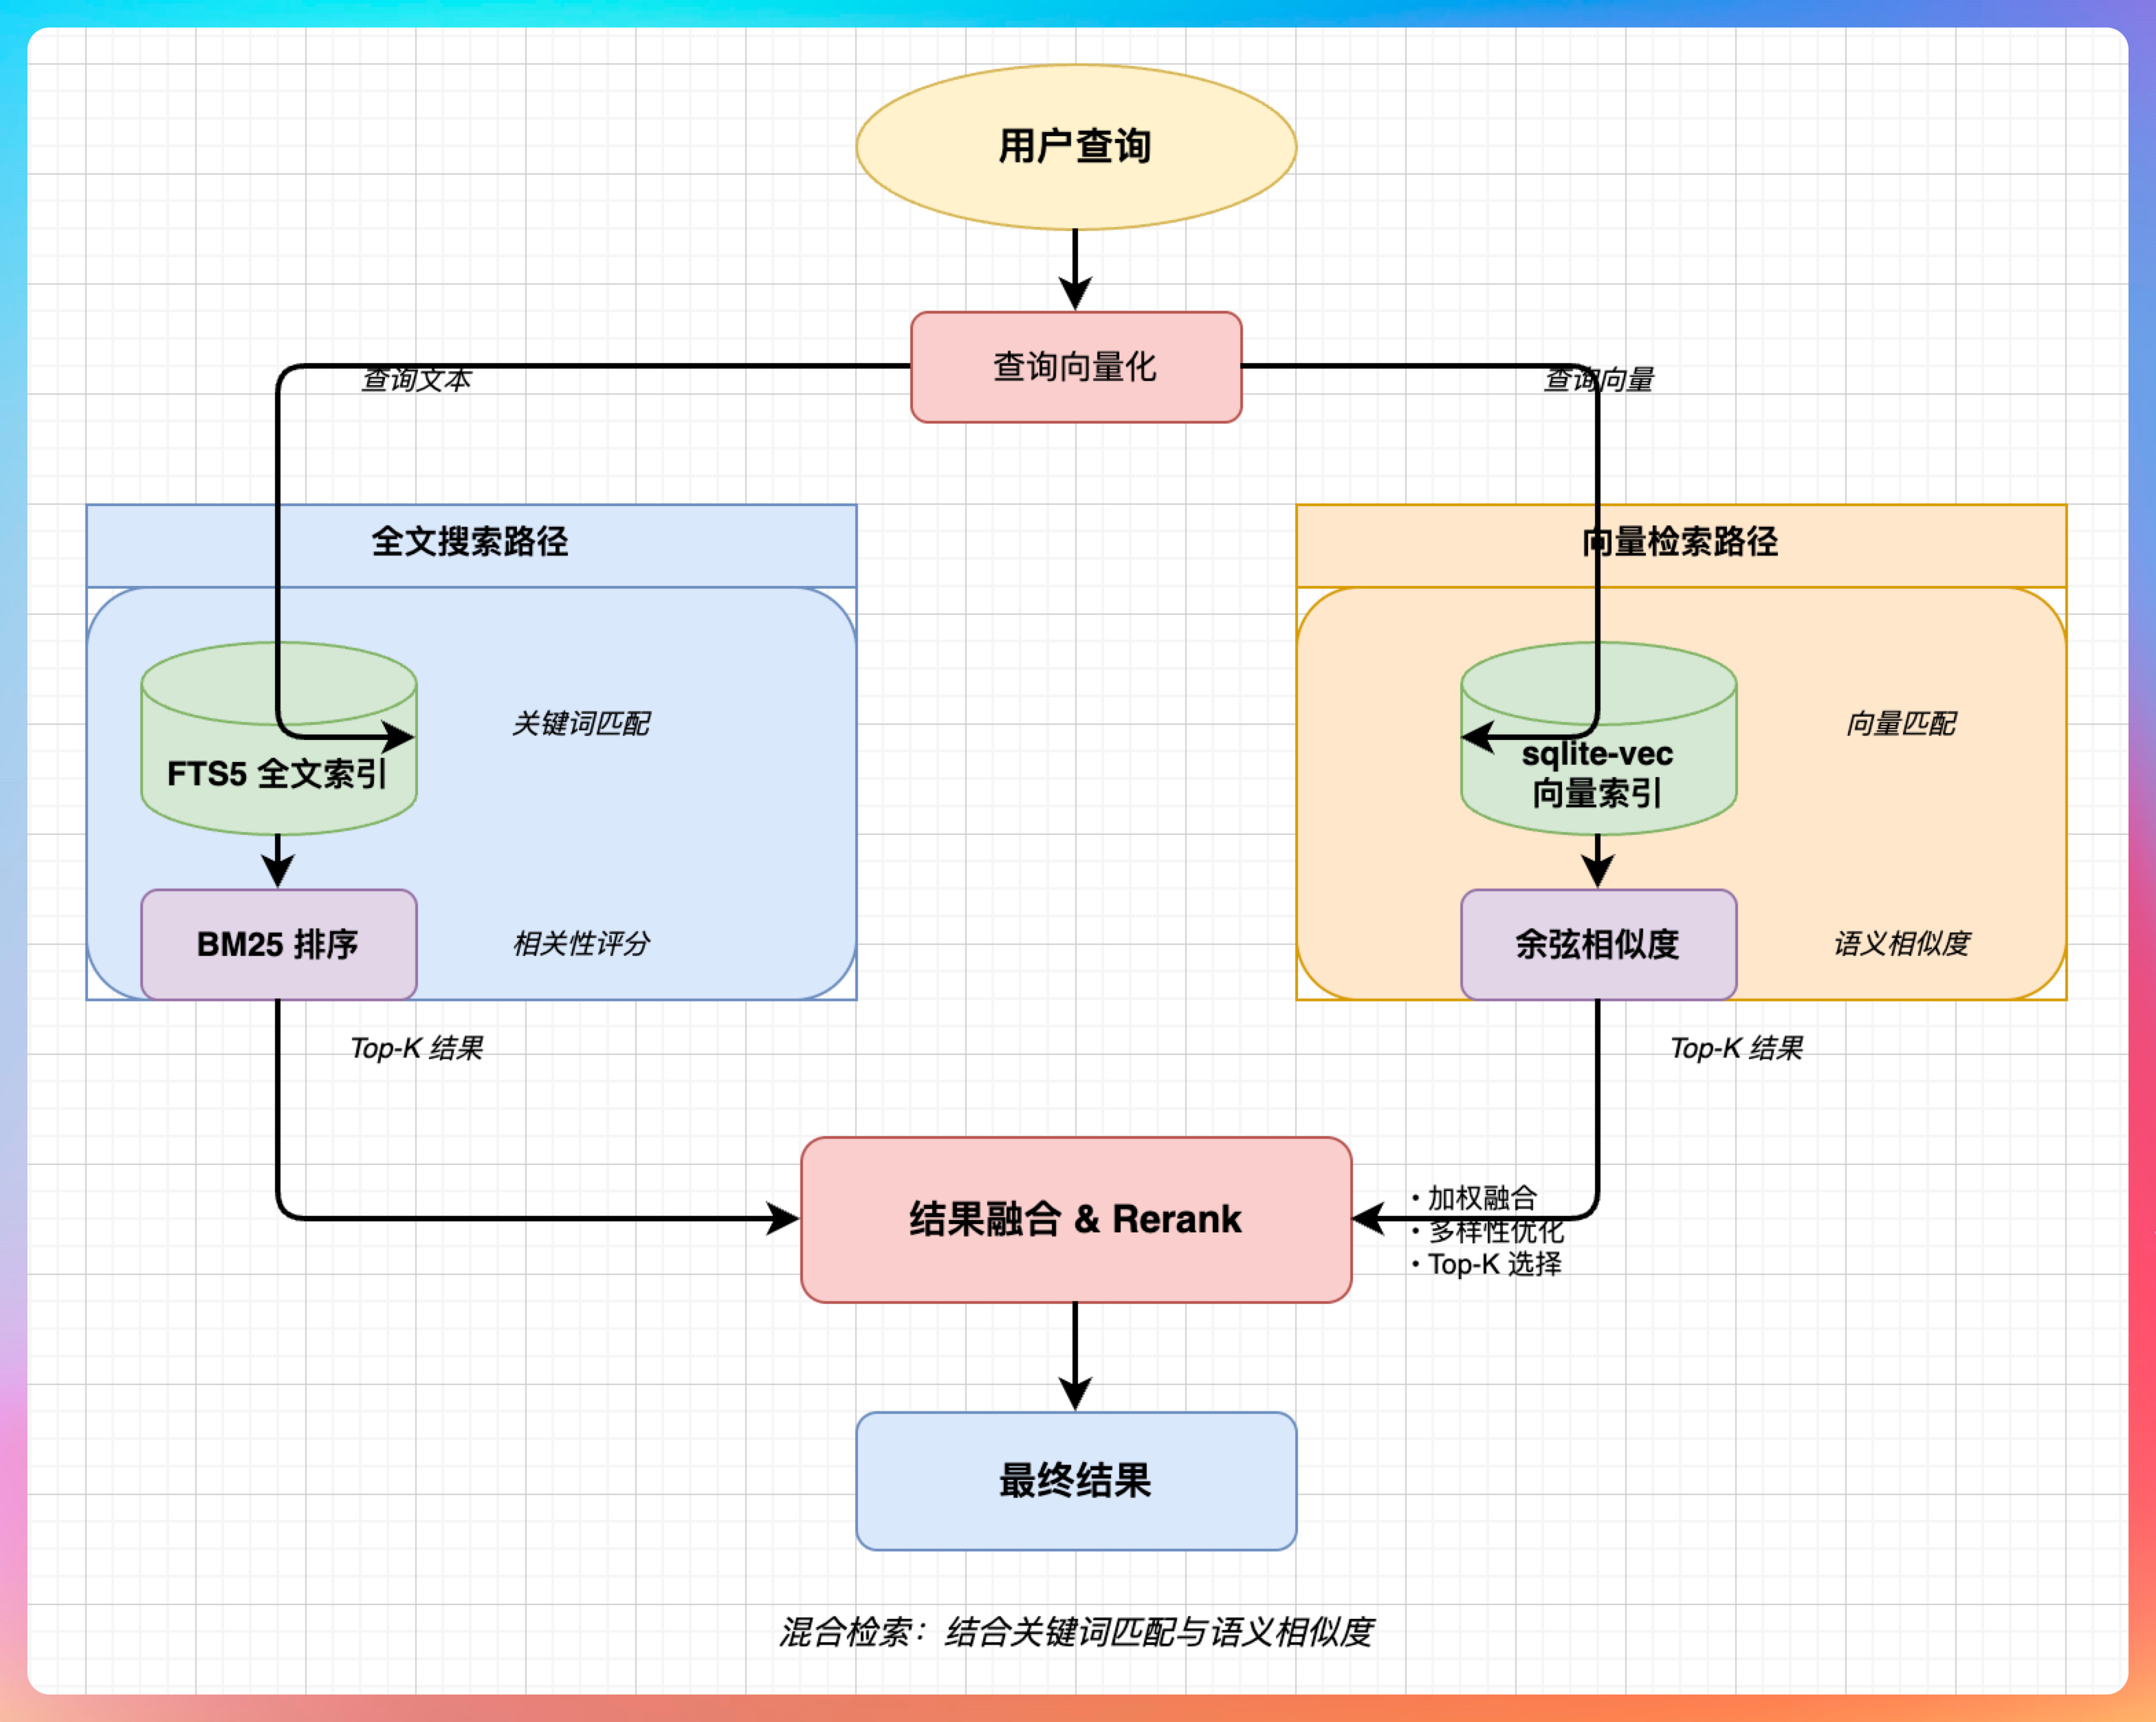
也就是说,OpenClaw 不是只做向量检索,也不是只做关键词检索,而是混合检索。
第四步,落库。
最后这些 chunk、元信息、全文索引、向量索引,都会放到本地的 SQLite 中。
老王点点头:“那检索时到底怎么查?是纯向量,还是关键词?”
我说:“混合检索。”
04、混合检索为什么比纯向量靠谱?
举个最简单的例子。
如果我们搜的是:memory_search("nomic-embed-text")
这类查询的关键,不是“语义接近”,而是“这个字符串必须命中”。
如果只靠向量检索,它可能把“embedding 模型”“本地向量索引”“OpenAI provider”这些语义都捞出来,但偏偏把最关键的关键字匹配丢掉。
如果搜的是:
上次说过的那个文章写作偏好是什么来着?
这时候关键词检索就不够用了,因为用户未必会原样说出“娓娓道来”“少用你、多用大家和我们”这些固定字眼。
所以 OpenClaw 的思路是:
- FTS5 + BM25 负责精确词项命中
- sqlite-vec 负责语义相似召回
- 最后再把两边的结果做融合,返回结果
为什么是 FTS5?
因为 SQLite 的 FTS5,本质上就是一个轻量级全文搜索引擎。
它比 LIKE '%xxx%' 快,还知道“哪些词更重要,哪些结果应该排前面”。
BM25 的价值就在这。
一个词出现 10 次不一定比出现 2 次更重要,而是会结合:
- 词频
- 文档长度
- 这个词在整个语料里稀不稀有
于是像 memory_flush、session-memory、nomic-embed-text 这种比较稀缺的词,权重天然就更高。
为什么还要 sqlite-vec?
因为 FTS5 主要解决的“字面命中”的问题,解决不了语义匹配的问题:
- “上次那个事”
- “之前你记住的偏好”
- “我不是说过不要那种爆款腔吗”
这种问法,字面上未必能正好撞到原文,但语义是接近的。这时候 embedding 的价值就出来了。
它先把 query 向量,再和每个 chunk 的向量做近邻比较,把语义接近的片段拉出来。可以粗暴理解成:
query
  ↓
embedding(query)
  ↓
和 chunks_vec 里的每个向量算距离
  ↓
取 top-k
这套东西要是放到 SaaS 产品里,需要一个单独的向量数据库,比如说派聪明RAG用的就是ElasticSearch。
但 OpenClaw 没这么干。
它用 sqlite-vec 这类 SQLite 扩展,把向量检索能力放进了本地的 SQLite 里。
老王听到这儿笑了:“行,概念算你讲明白了。那 Agent 自己到底怎么用这些 Memory?”
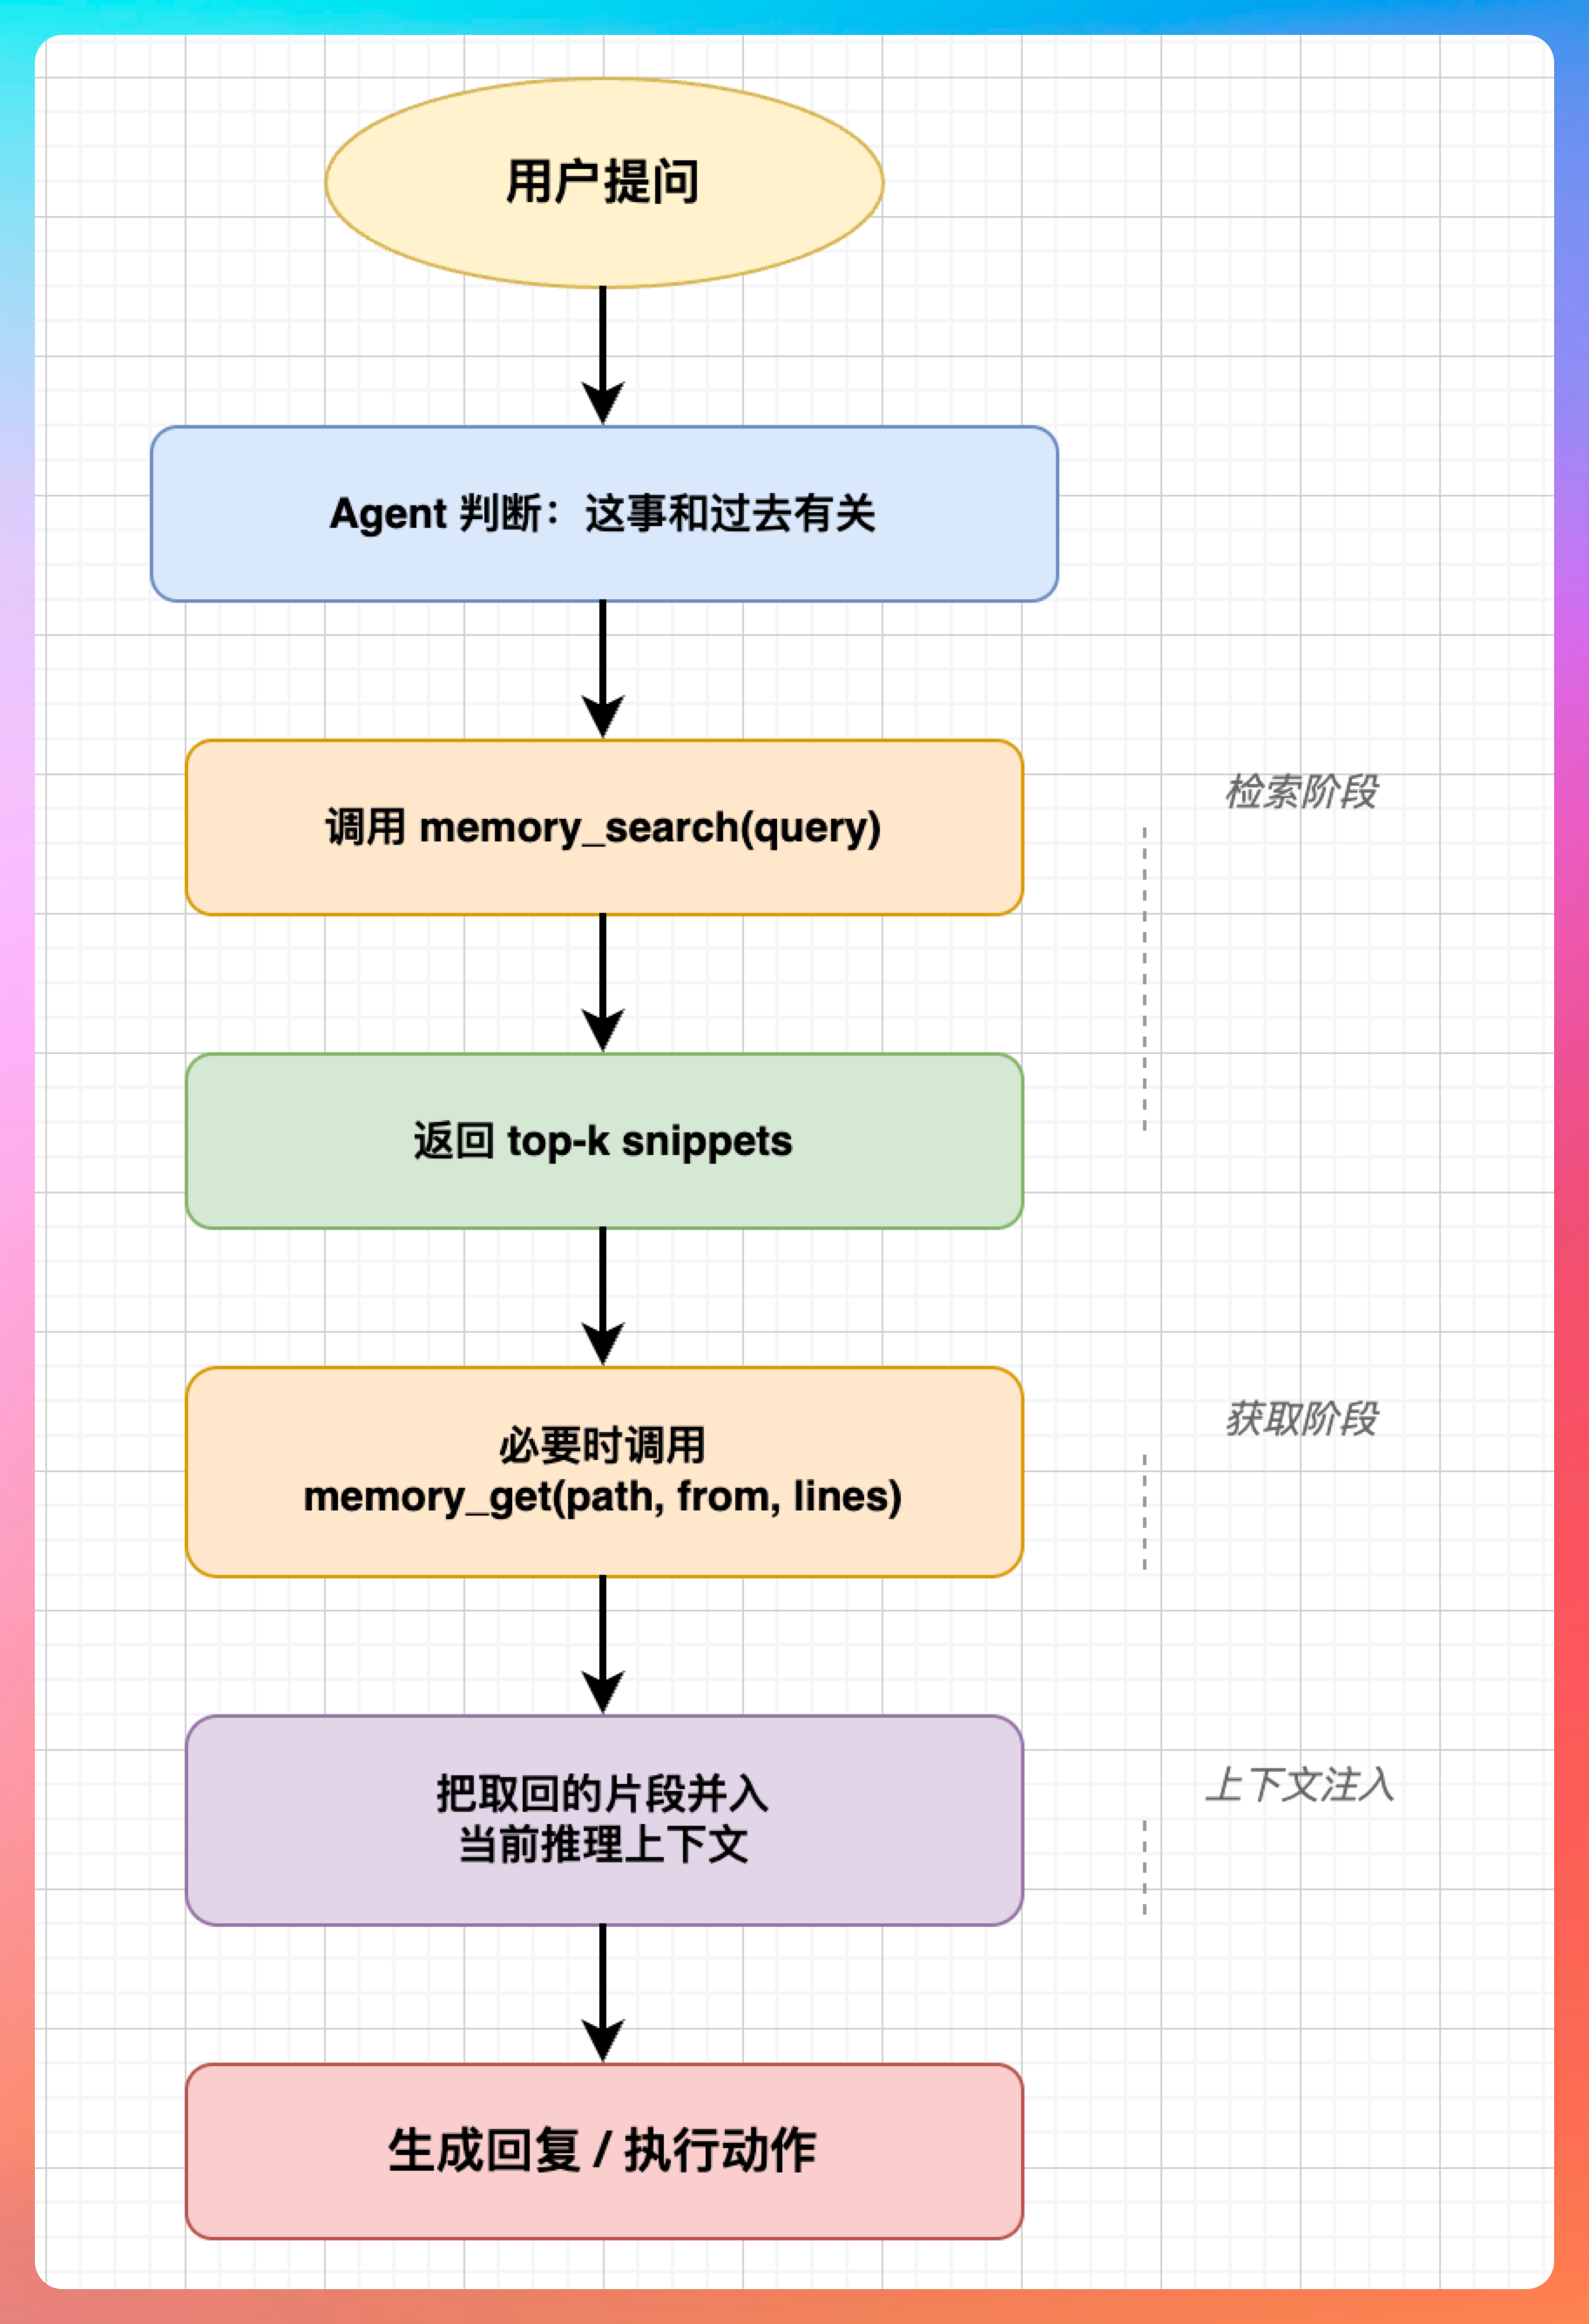
05、检索到记忆之后,Agent 是怎么把它用起来的?
“王哥,这一步才是 Memory 真正发挥价值的地方。”
很多人以为 Memory 系统的终点是“查到了”。其实不是。
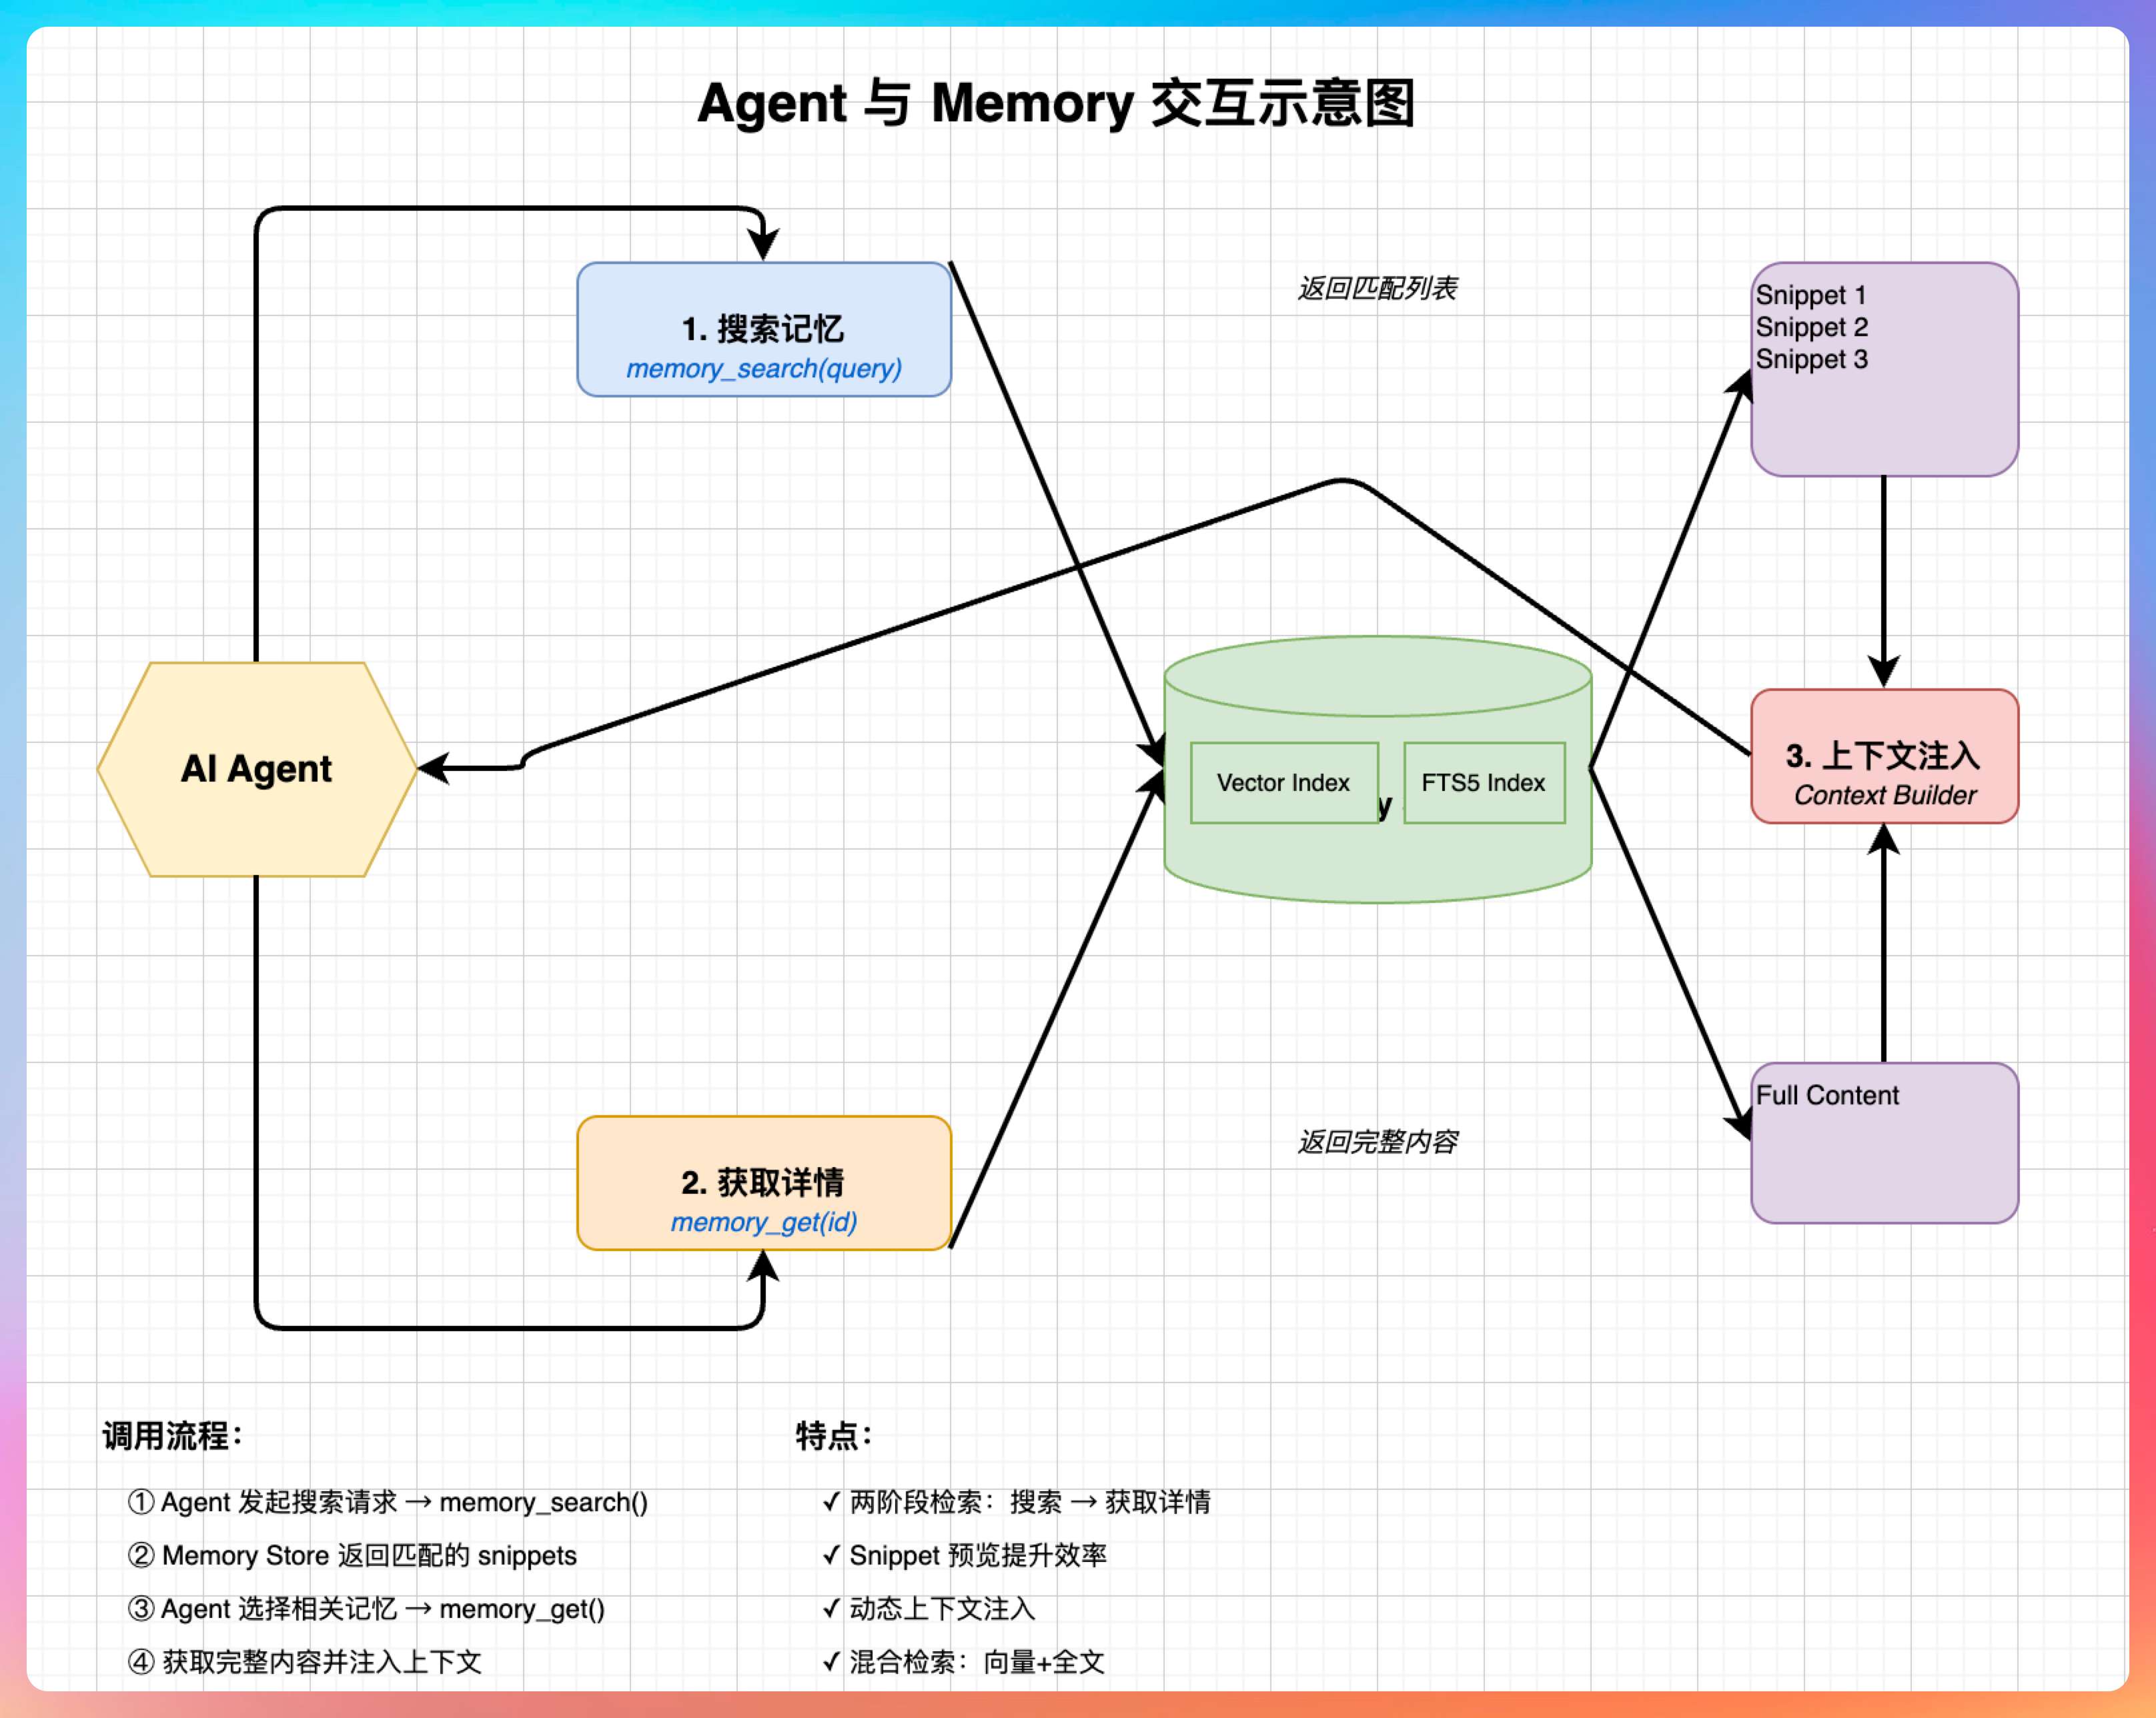
OpenClaw 主要给 Agent 暴露了两个工具:
1)memory_search
当 Agent 发现问题涉及过去的决策、偏好、历史上下文,它不会把整个 memory/ 目录读一遍,而是先发起一次语义搜索。
例如:
memory_search("二哥的文章写作偏好")
返回的不是整篇内容,而是最相关的若干 snippet + 文件路径 + 行号范围。
这样做有两个好处:
- 控制 token,不要把整个历史一口气塞进上下文
- 先粗召回,找到“值得展开读”的位置
2)memory_get
如果 memory_search 返回说,关键信息在:
MEMORY.md#L1-L16memory/2026-03-19.md#L20-L48
那 Agent 下一步就可以用 memory_get 去读具体的行段。
注意,这里面有个特别容易被忽略的点:
Memory 文件本身不是每回合全量注入。
memory/*.md 这种 daily 文件默认并不会塞进上下文窗口,而是通过 memory_search 和 memory_get 按需读取。
这就解释了为什么 OpenClaw 的 Memory 能够“越记越多”,但又不会把上下文撑爆的原因。
Memory flush 为什么是这个体系里的关键一环?
OpenClaw 在会话接近 compaction 之前,会触发一次 silent memory flush。
也就是说,当 session 接近自动压缩时,系统会发起一个静默回合,提醒模型把值得长期保留的内容写进 memory/YYYY-MM-DD.md。
老王听完感慨:“你这理解得够深的。那我再问你一个实际应用的问题,你用 OpenClaw 的 Memory 干过什么真实的场景?”
06、Memory 的最佳实践
“王哥,我给你讲一个真实的场景。”
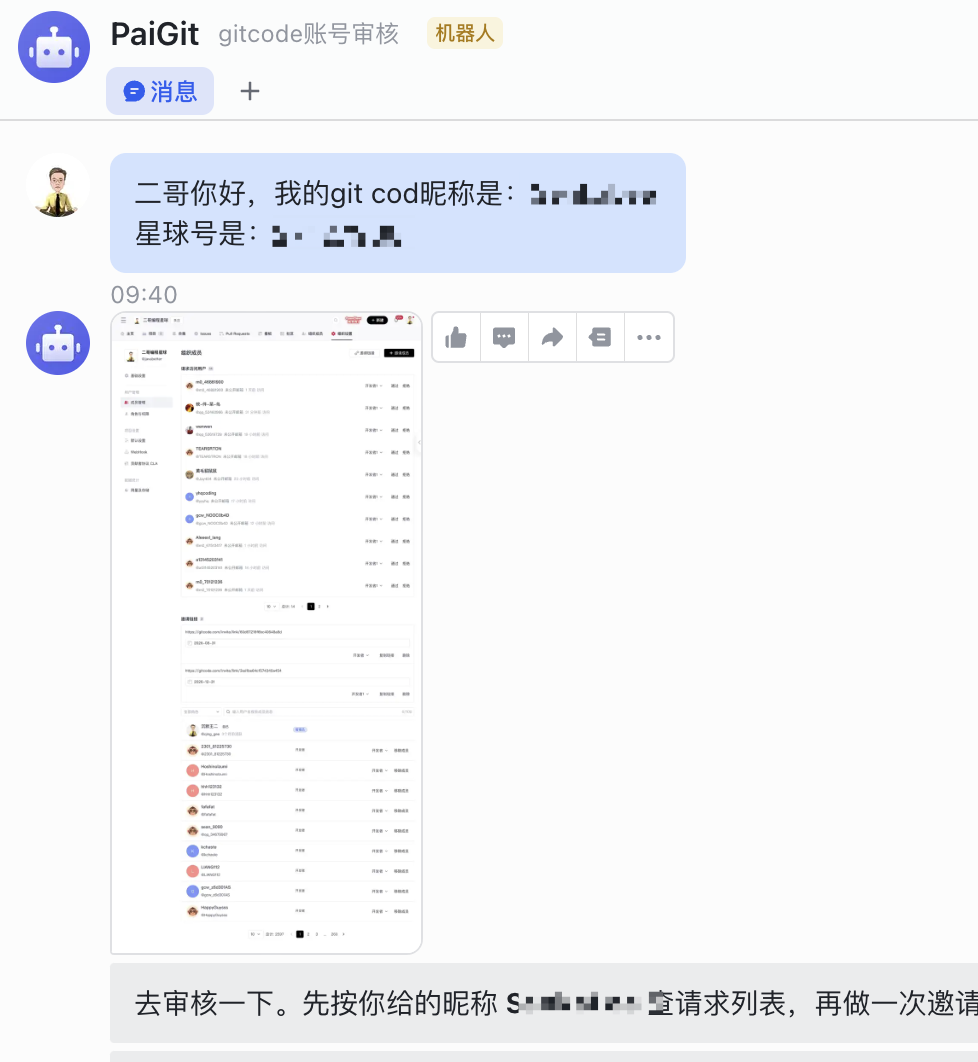
我有一个 Agent 是专门帮我审核 gitcode 账号的。如果没有Memory,每次审核的时候,我都要告诉它一些重复的信息,比如:
- 审核完成后发消息到哪个飞书群
- 添加到哪个 gitcode 项目组
- 审核结果用什么格式回复
这些信息每次都要重复说,很烦。把这些写进 Memory就没事了:
# 用户偏好

## gitcode 审核

- 审核完成后发消息到“技术派-运营群”
- 添加到项目组:技术派-会员组
- 回复格式:@用户 审核通过,已添加到技术派-会员组

## 其他偏好

- 我是 Java 后端开发,回答问题请用 Java 技术栈
- 回复时请简洁,不要废话
这样每次审核,Agent 就会自动检索这些偏好,按照我的要求执行。
老王听完眼睛一亮:“这个场景实用。”
我说:“还不止。我还让 Agent 记住了我的工作习惯。比如我喜欢在早上处理审核任务,Agent 会在每天早上主动提醒我有多少待审核的申请。”
来,直接让龙虾帮我们现场演示一个。
直接这条命令 openclaw memory search "nomic-embed-text"
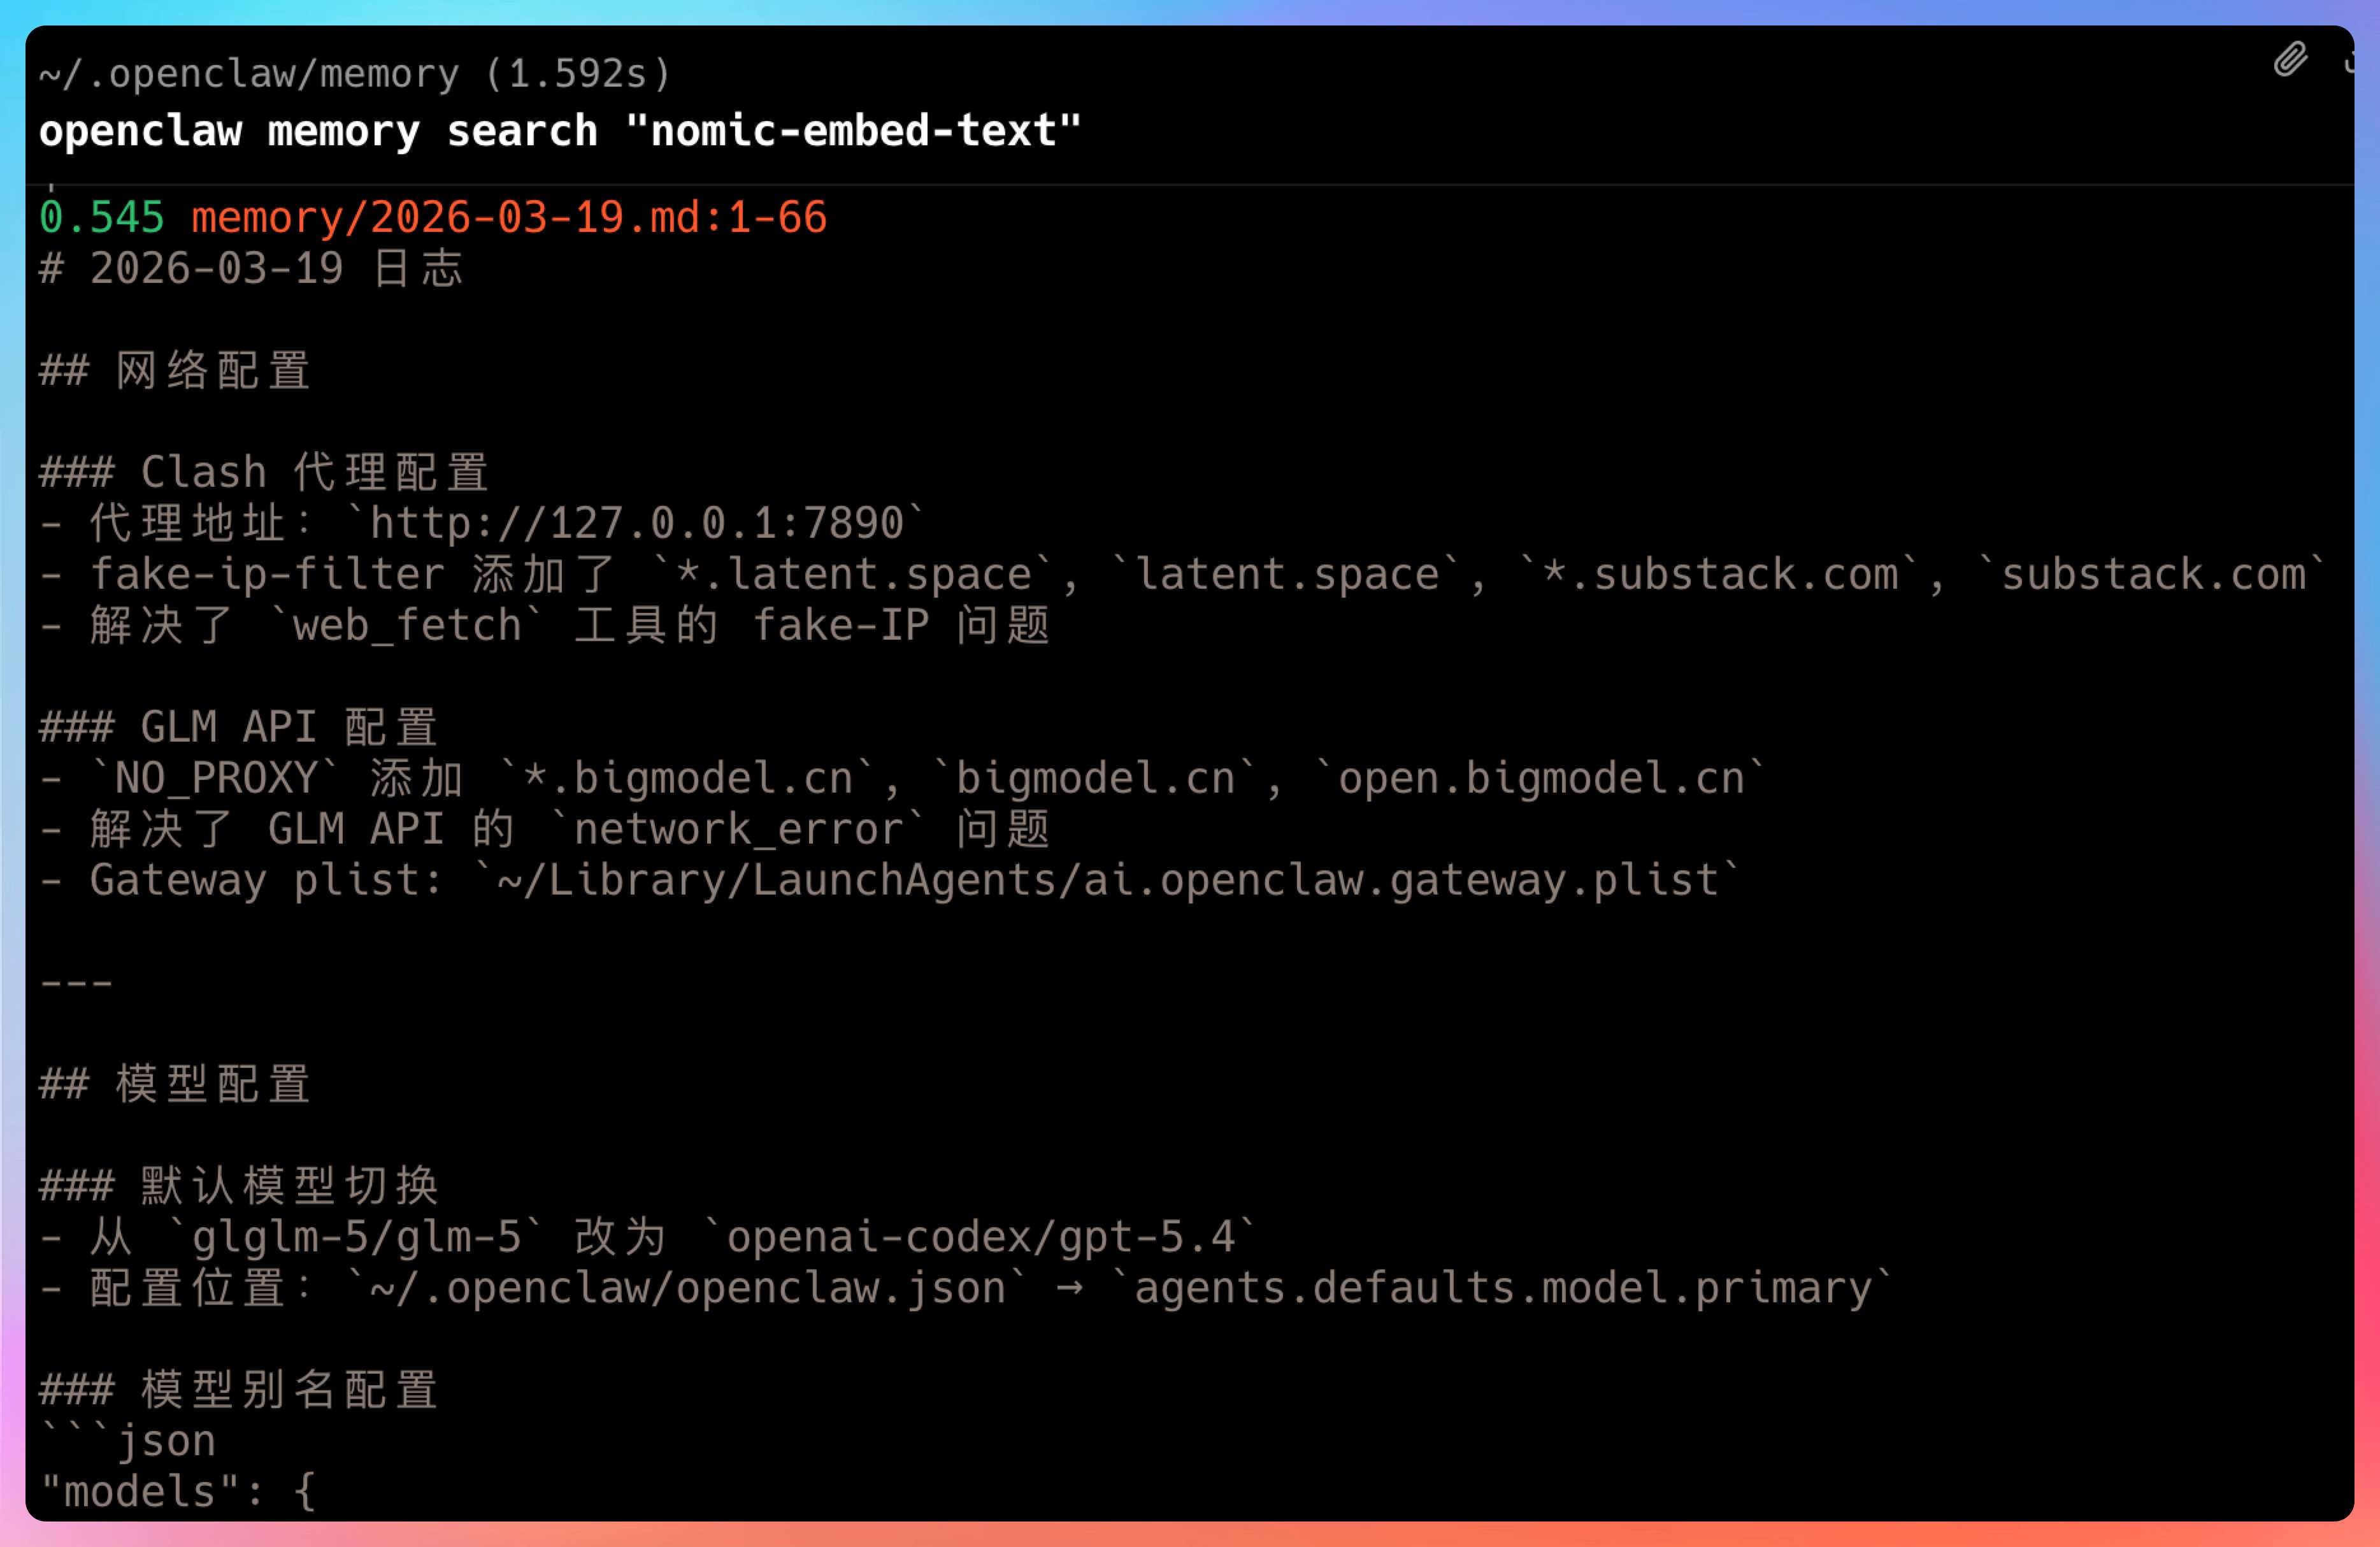
返回里直接命中了这两类内容:memory/2026-03-19.md、MEMORY.md
而且都正好包含:nomic-embed-text、embedding 模型、memory 搜索配置
这说明关键词搜索是起效的。
第二次,我们执行 openclaw memory search "上次说过不要那种爆款腔的写法"
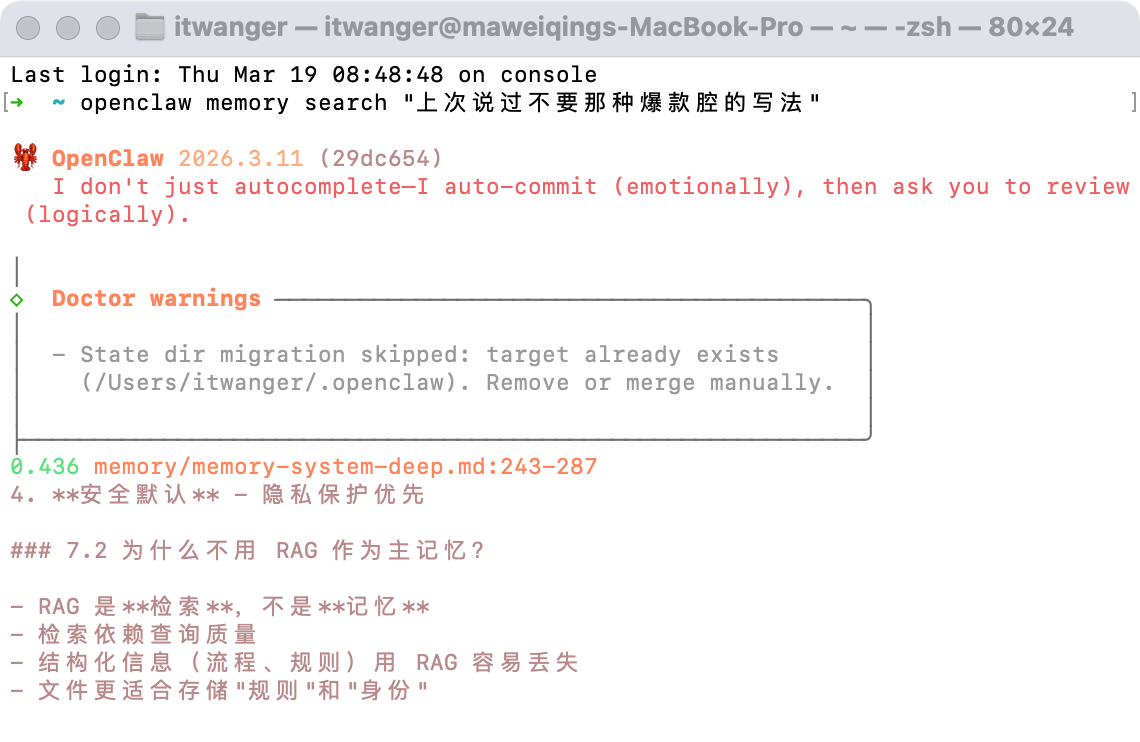
注意,这句话里没有直接写“不要硬做爆款腔”、“娓娓道来”、“二哥味”
但返回找到了这些和“写作风格、表达偏好、memory 原理”接近的内容,比如:memory/memory-system-deep.md、memory/memory-system.md
这就证明向量检索也是可用的。
ending
不瞒大家说,OpenClaw 的 Memory 机制是我觉得最精彩的设计之一。
它解决了 AI Agent 的一个核心痛点:如何让 Agent 拥有长期记忆,而不是每次对话都从零开始。
【记忆是智能的基础。没有记忆,就没有真正的智能。】
OpenClaw 通过短期记忆和长期记忆,以及混合检索(向量+关键词),实现了一个轻量级但功能强大的记忆系统。
更重要的是,不需要部署复杂的向量数据库,只需要一个 SQLite 文件就够了。
这才是工程设计的精髓:用最简单的方案解决最复杂的问题。
我们下期见!