


大家好,我是二哥呀。
Codex 更新到最新版,你会发现 5 小时的 Token 限量已经取消了。
也就意味着,以后你可以让 Codex 一次性处理更长的上下文,或者让它在一个任务里连续工作更久。
不必因为 5小时的限额停下来。
并且你真用超了,Codex 可能还会送你一次重置机会。
真天地良心啊。
那经过两天时间的实测,我觉得 GPT-5.6 的能力确实有提升,但也存在一些问题。
不吹不黑,我们直接发车,滴滴滴。
01、生视频
王二讲Agent 最近一直在分享视频领域的Agent知识,但视频的质量偏文字表达,缺少动画效果。
所以我就想,能不能让 GPT-5.6 直接帮我把视频分镜,然后生成动画。
音频这块你不用帮我搞了,我现在只需要视频画面,我们就保持HTML+动态svg来处理,你最好一个视频不用生成太长时间,一个视频片段就15秒左右,然后我自己最后再来使用剪映合并。15秒的好处就是,我可以自己去调整,如果有视频片段不合适的话。

我们就拿what-is-context-window.md这篇稿子来做测试,你需要先分镜,把稿子分成合适的分镜,我们接下来只处理其中一个分镜。

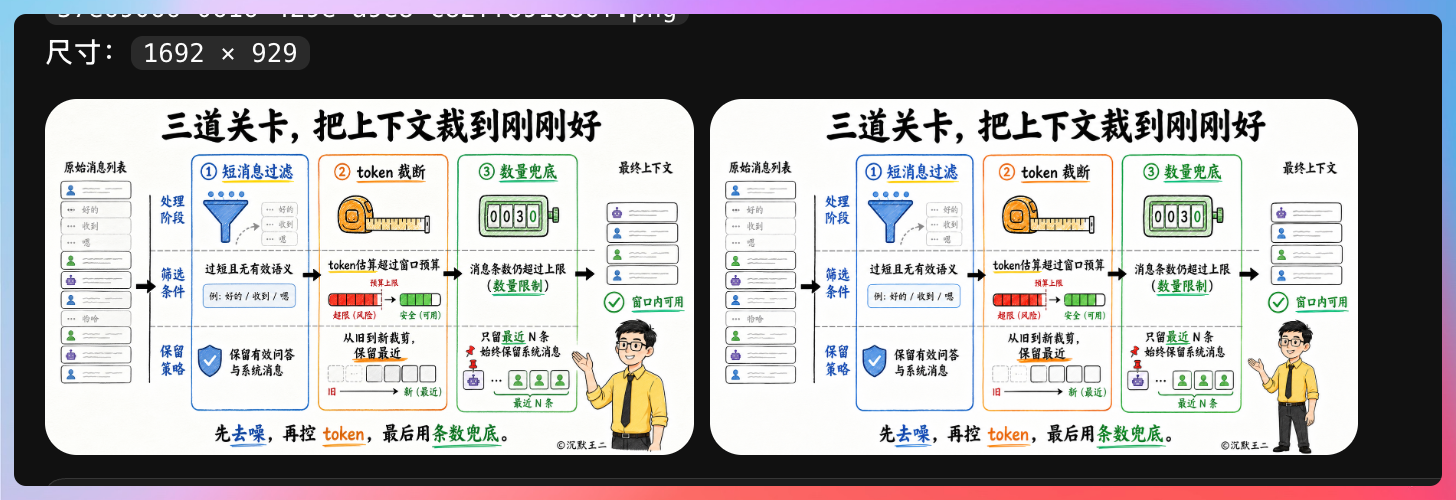
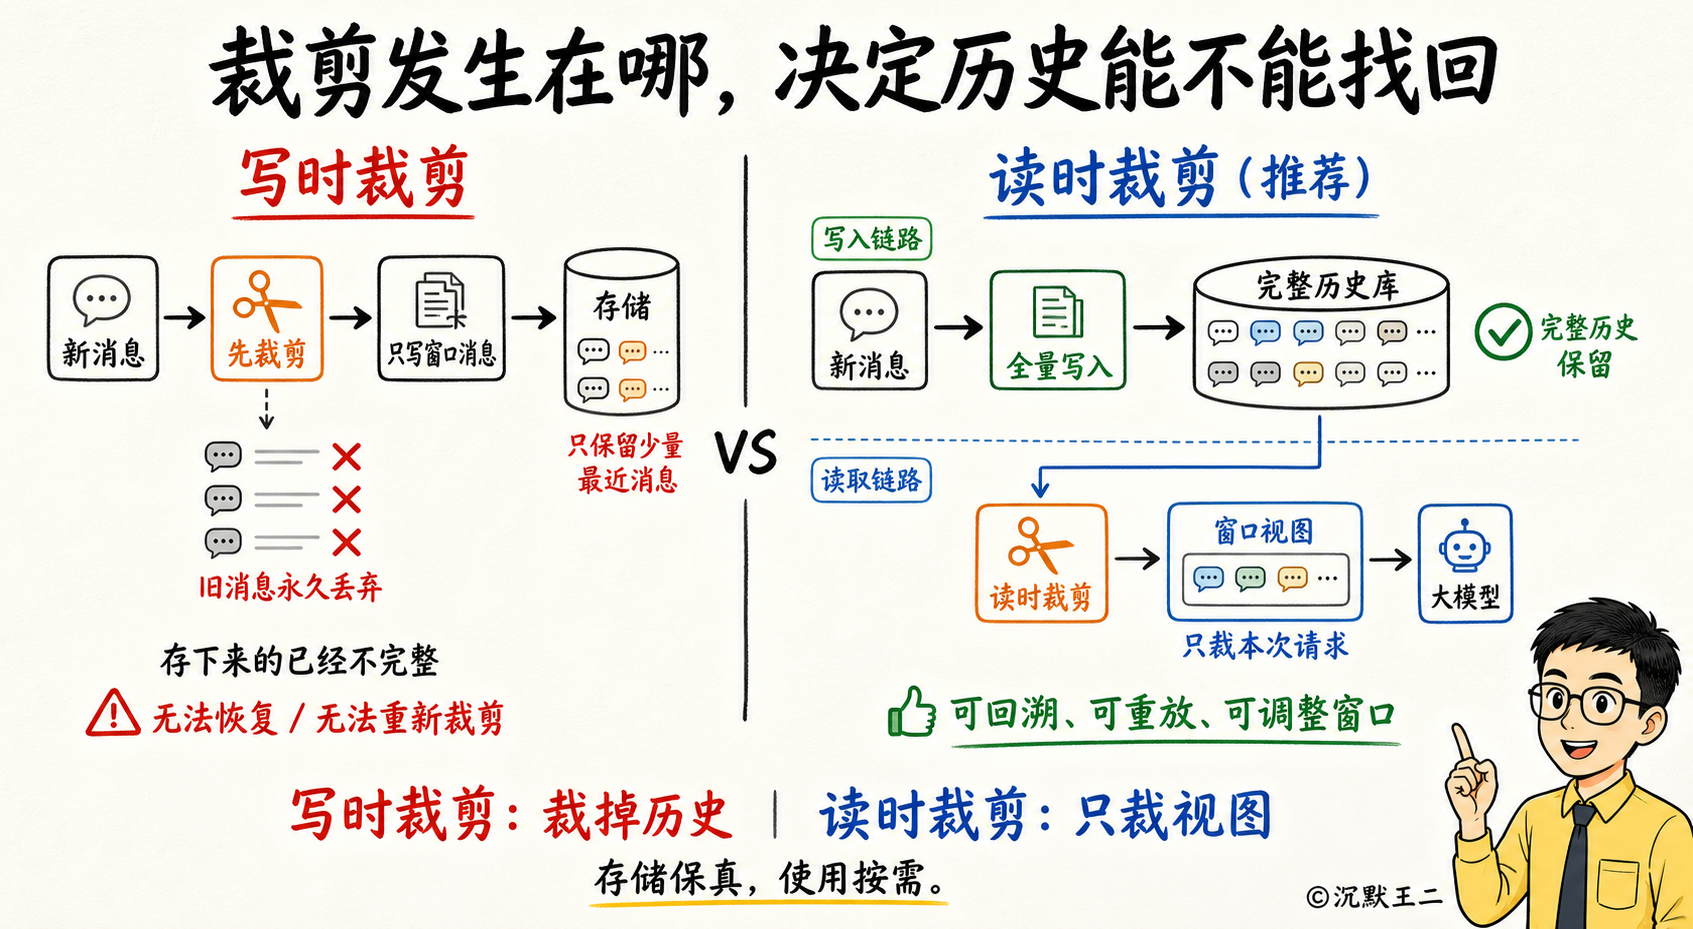
分镜完成后,我们再来处理每个分镜的视频,不需要做音频。视频的生成我想和itwanger-image生图结合起来,利用分镜的文稿关键字,提取信息后生成视频,视频的风格见图1

我们的目标是让画面动起来,明白我的意思吗,比如说文稿讲到了写时裁剪,我们的视频聚焦于写时裁剪,让新消息、先裁剪、只写窗口消息、存储这些动起来,层层递进,然后是下一个。
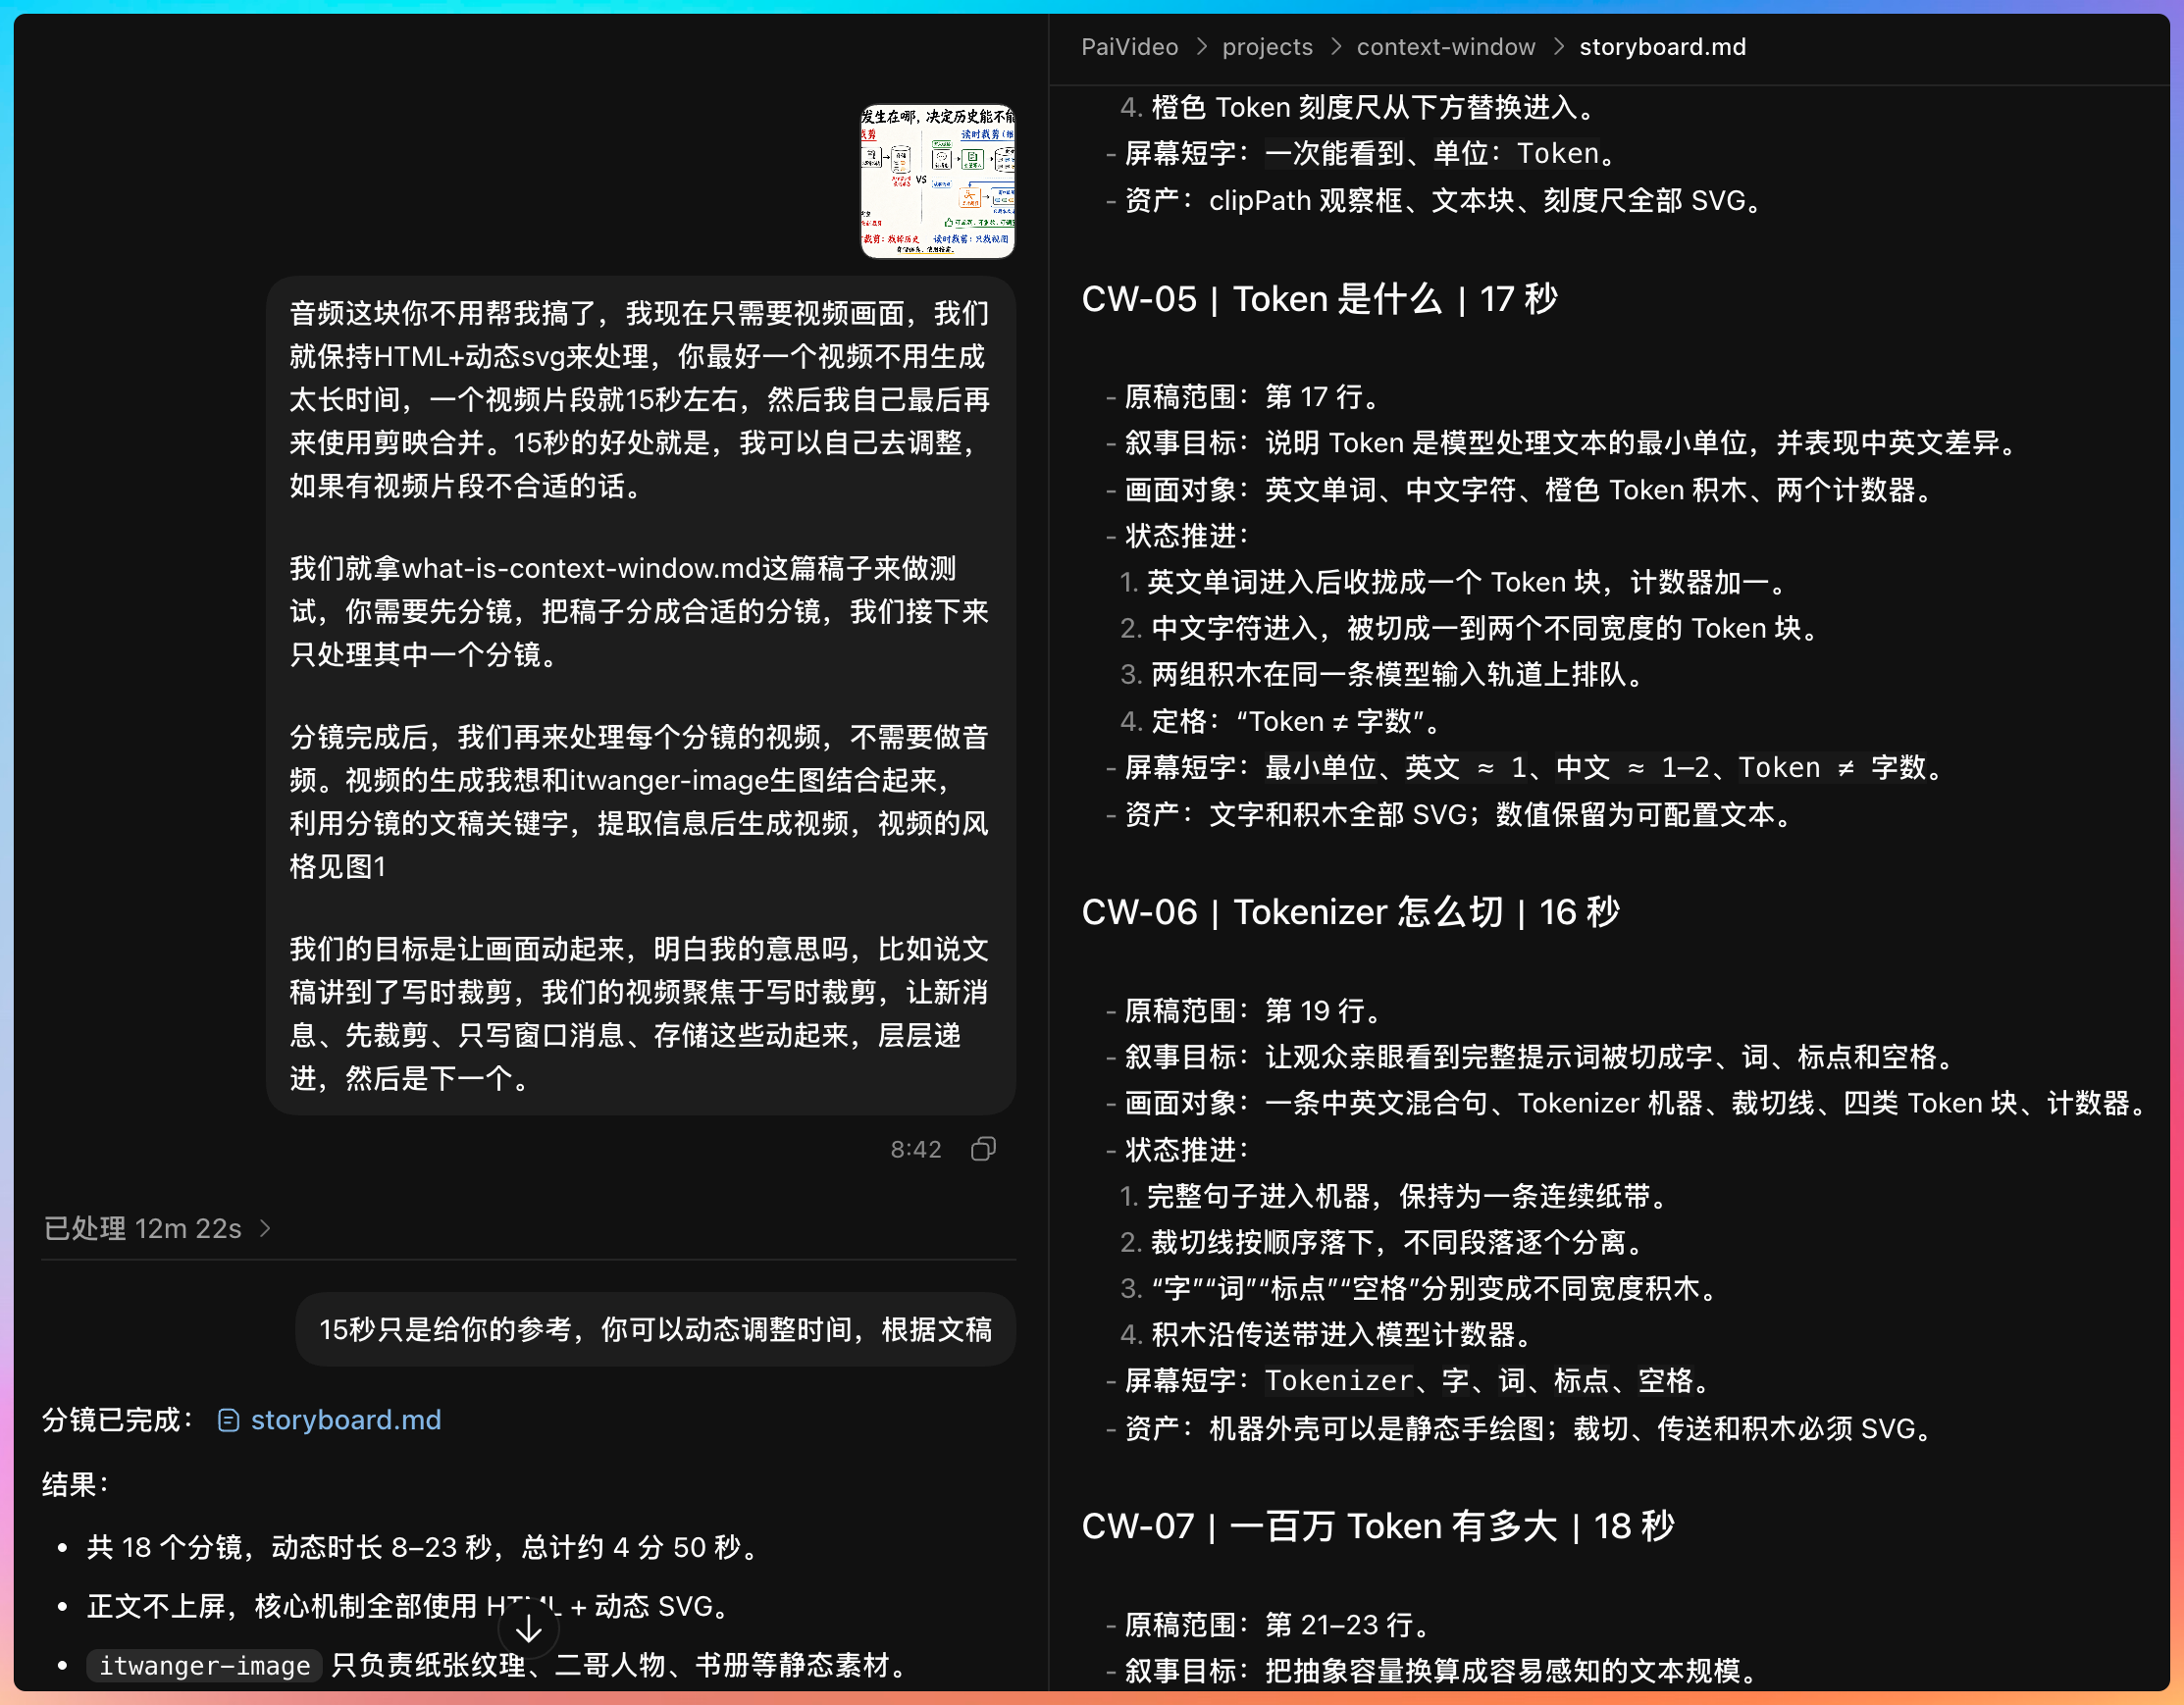
出来动画效果我觉得还不错。
【视频1】
【视频2】
下一步,我要解决的就是音频和画面的同步问题,如果能解决这个问题,我觉得王二讲Agent的视频质量就能提高很大一截。
02、生图片
我所有公众号文章的配图,最近都是用 Codex + GPT-5.5 配合 itwanger-image 这个 Skill 完成的。
昨天开始切换到 GPT-5.6。
一个很明显的感受,5.6 在色彩丰富度上有肉眼可见的提升,画面更通透、层次更细腻。
但一致性比 5.5 差。
拿我给求职派生成的配图来演示——右下角的小人,竟然长了三只手。
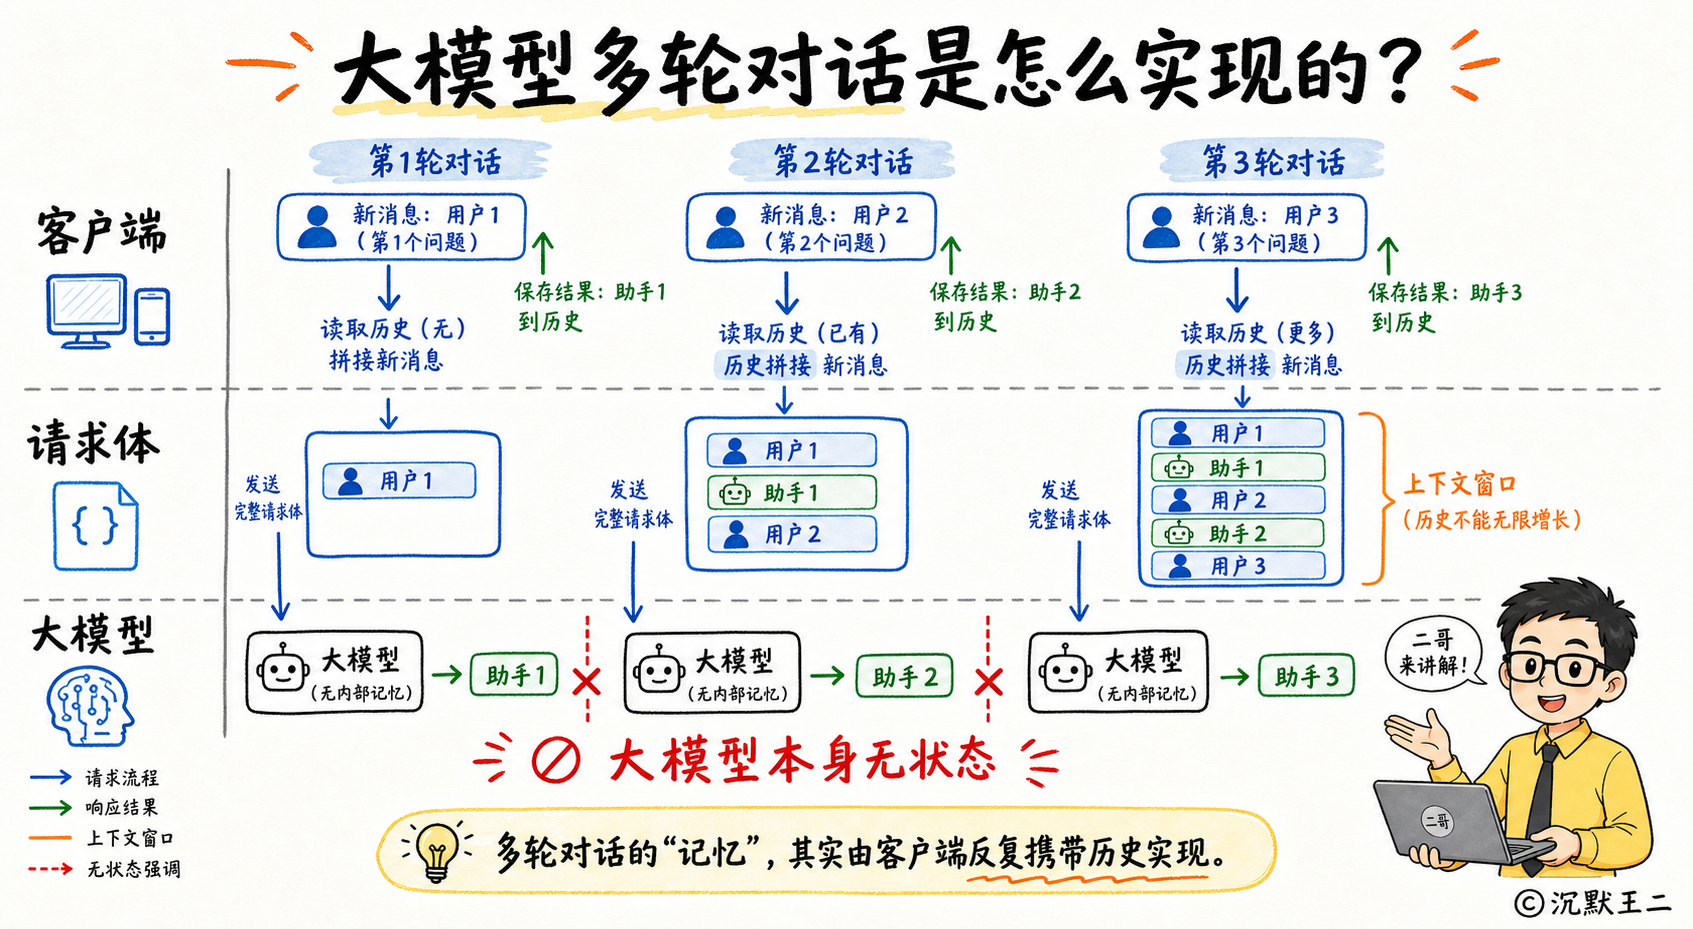
大爷的。
GPT-5.5 里我从来没遇到过这种情况。5.6 第一次就中招了。
好在很快就能修复这个问题,Skill 里加了几条限制规则。
- 强制人物只有两条手臂、两只手
- 禁止多手、多臂、重复手指和肢体粘连
- 多手问题列入交付前硬伤检查,发现后必须重绘
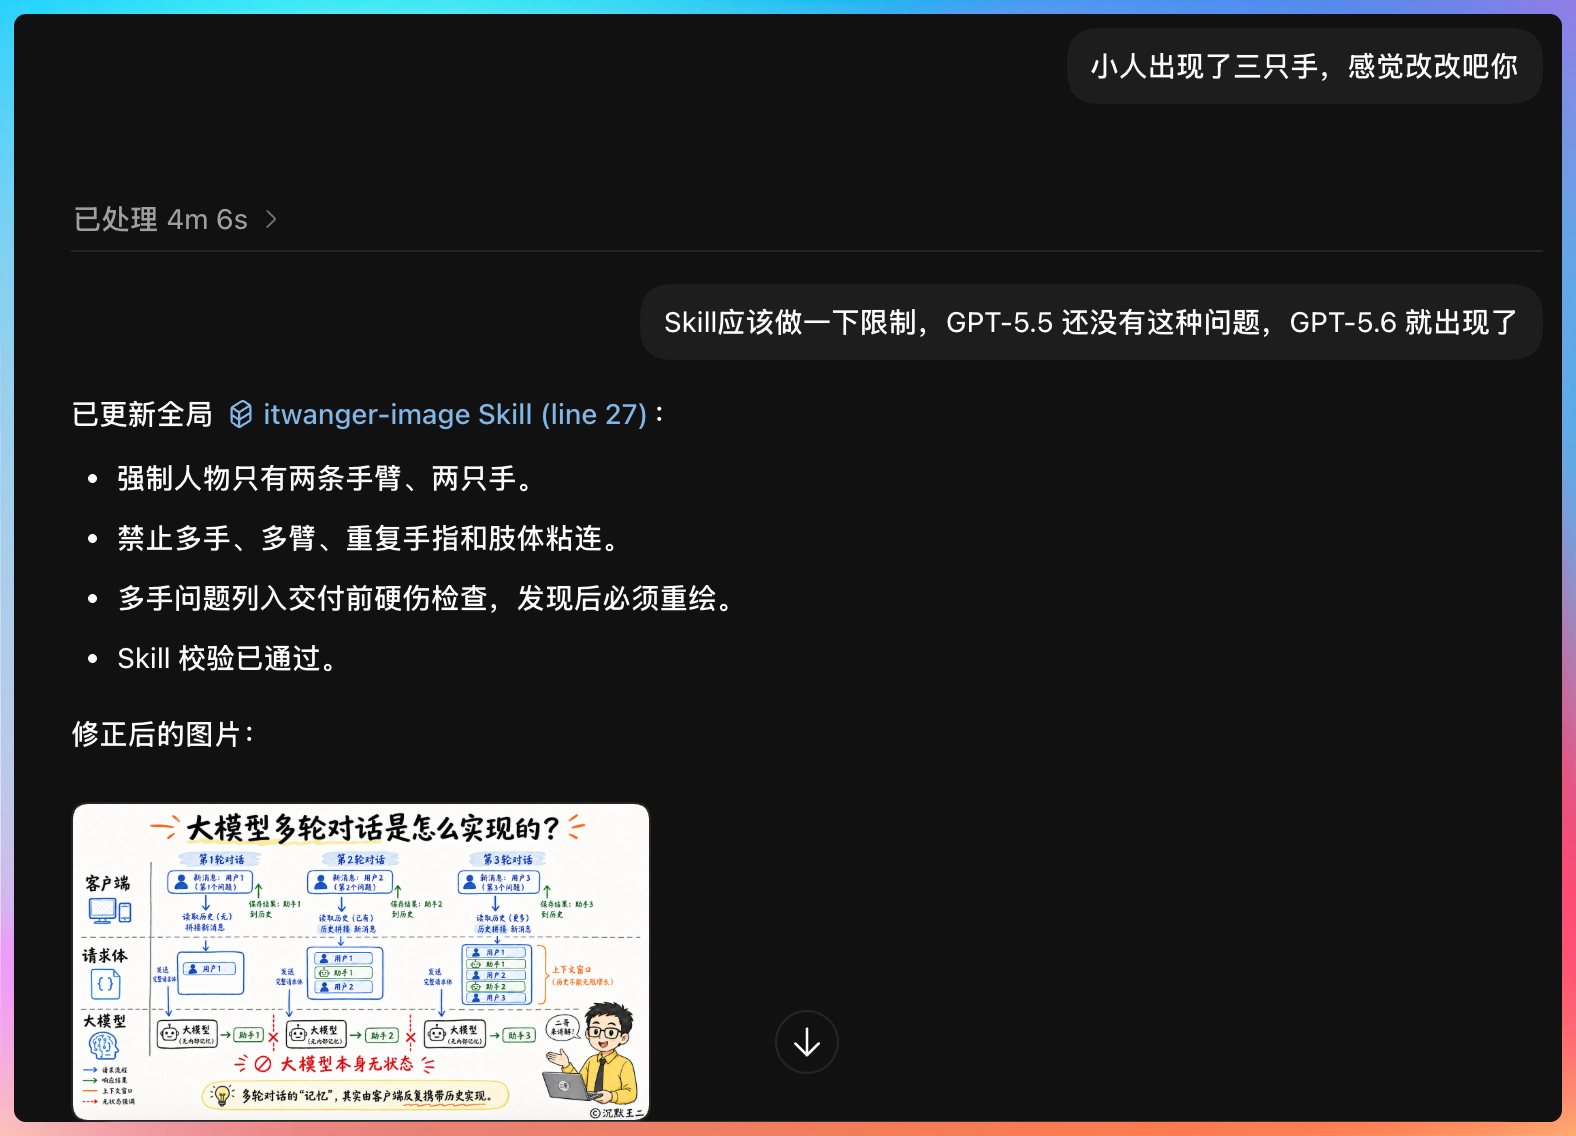
不幸的是,下一轮生图又出问题了。
这回不是多了手,而是模型为了“确保两只手完整可见”,硬把两条胳膊都塞进了画面里。左侧原图重绘到右侧,多出来两条不自然的手臂。
小人看起来很别扭。
我又改了规则,不用确保两只手都完整可见,只要画面中可见的肢体是正常的就行。
下一次生图正常了。
小结一下。
GPT-5.6 的图像生成在色彩表现力上有进步,但人体一致性出现了明显退步。
03、编码
刚好有读者对 PaiFlow 提了一个 bug,语音合成工作流里 TTS 调用超时。
我直接把这个任务交给 GPT-5.6,看能不能一次性搞定。
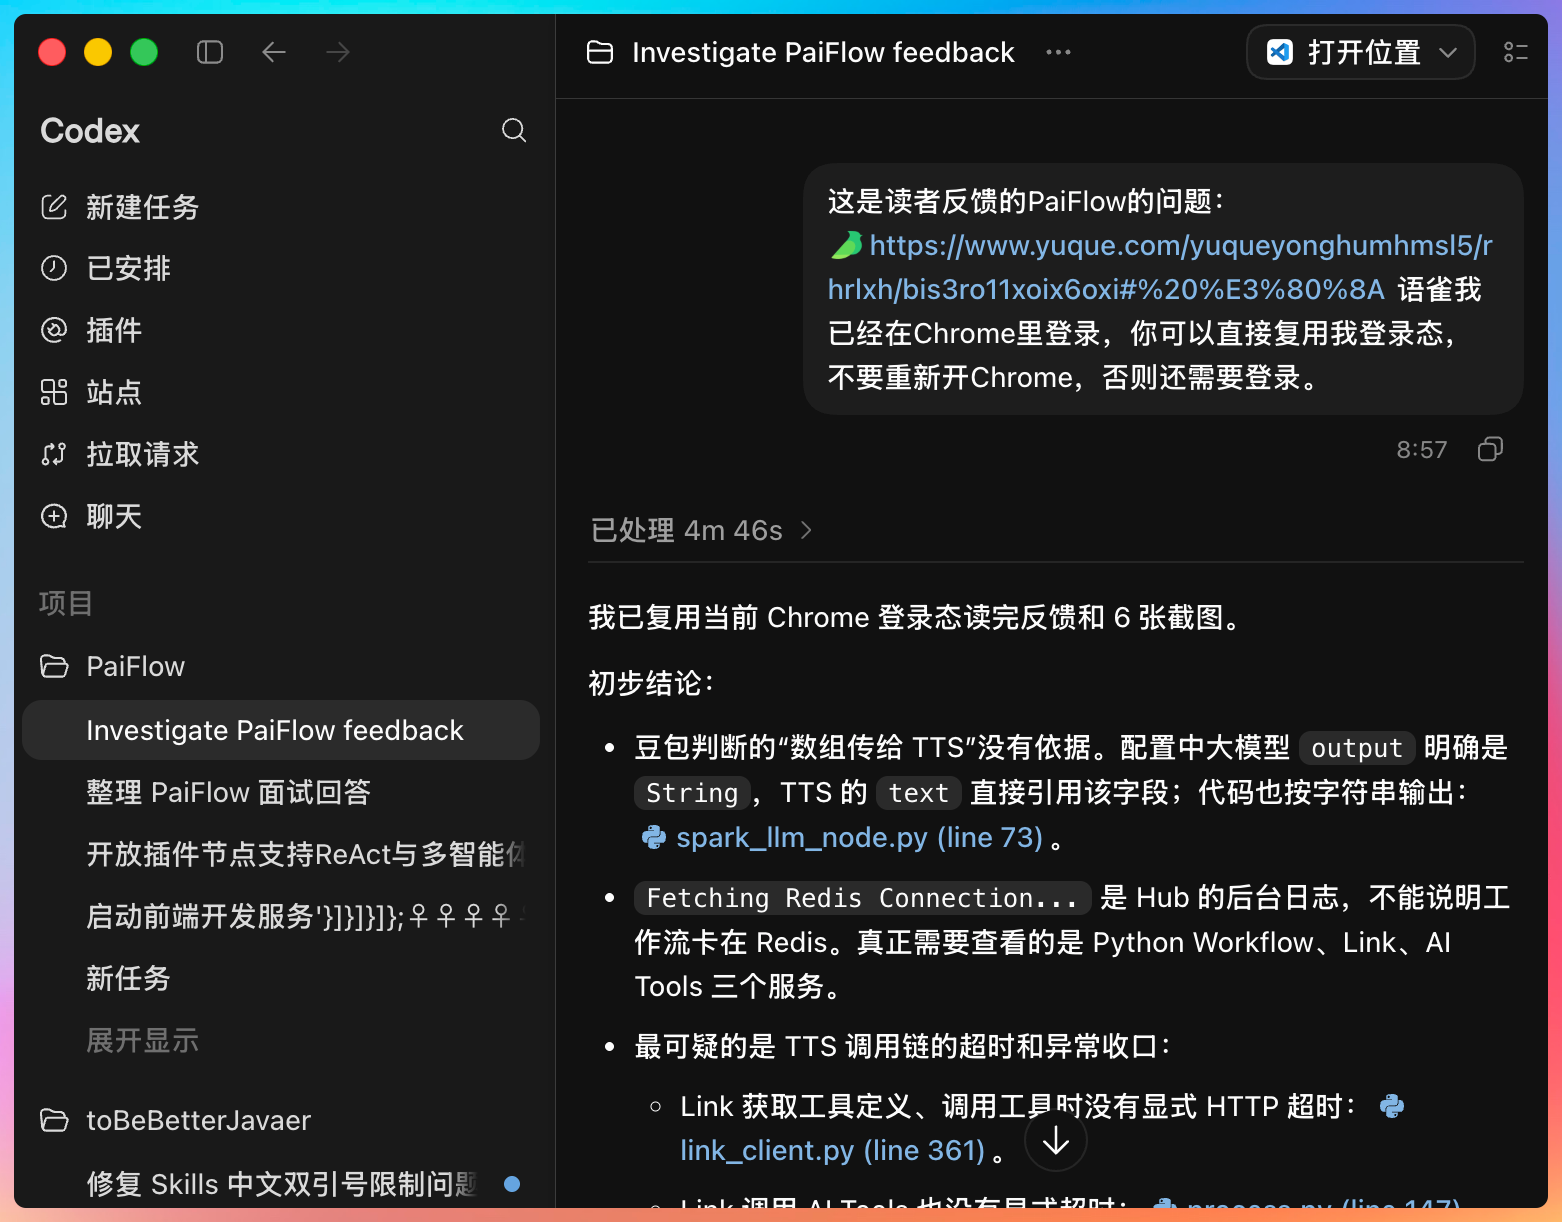
顺带提一句,新版 ChatGPT 已经把左上角的入口从“ChatGPT Codex”改成了“Codex”,命名终于正常了。
GPT-5.6 分析后认为这个问题发生在 TTS 调用的超时处理上。
我让 Codex 启动本地服务,用 Python 的工作流引擎实测。
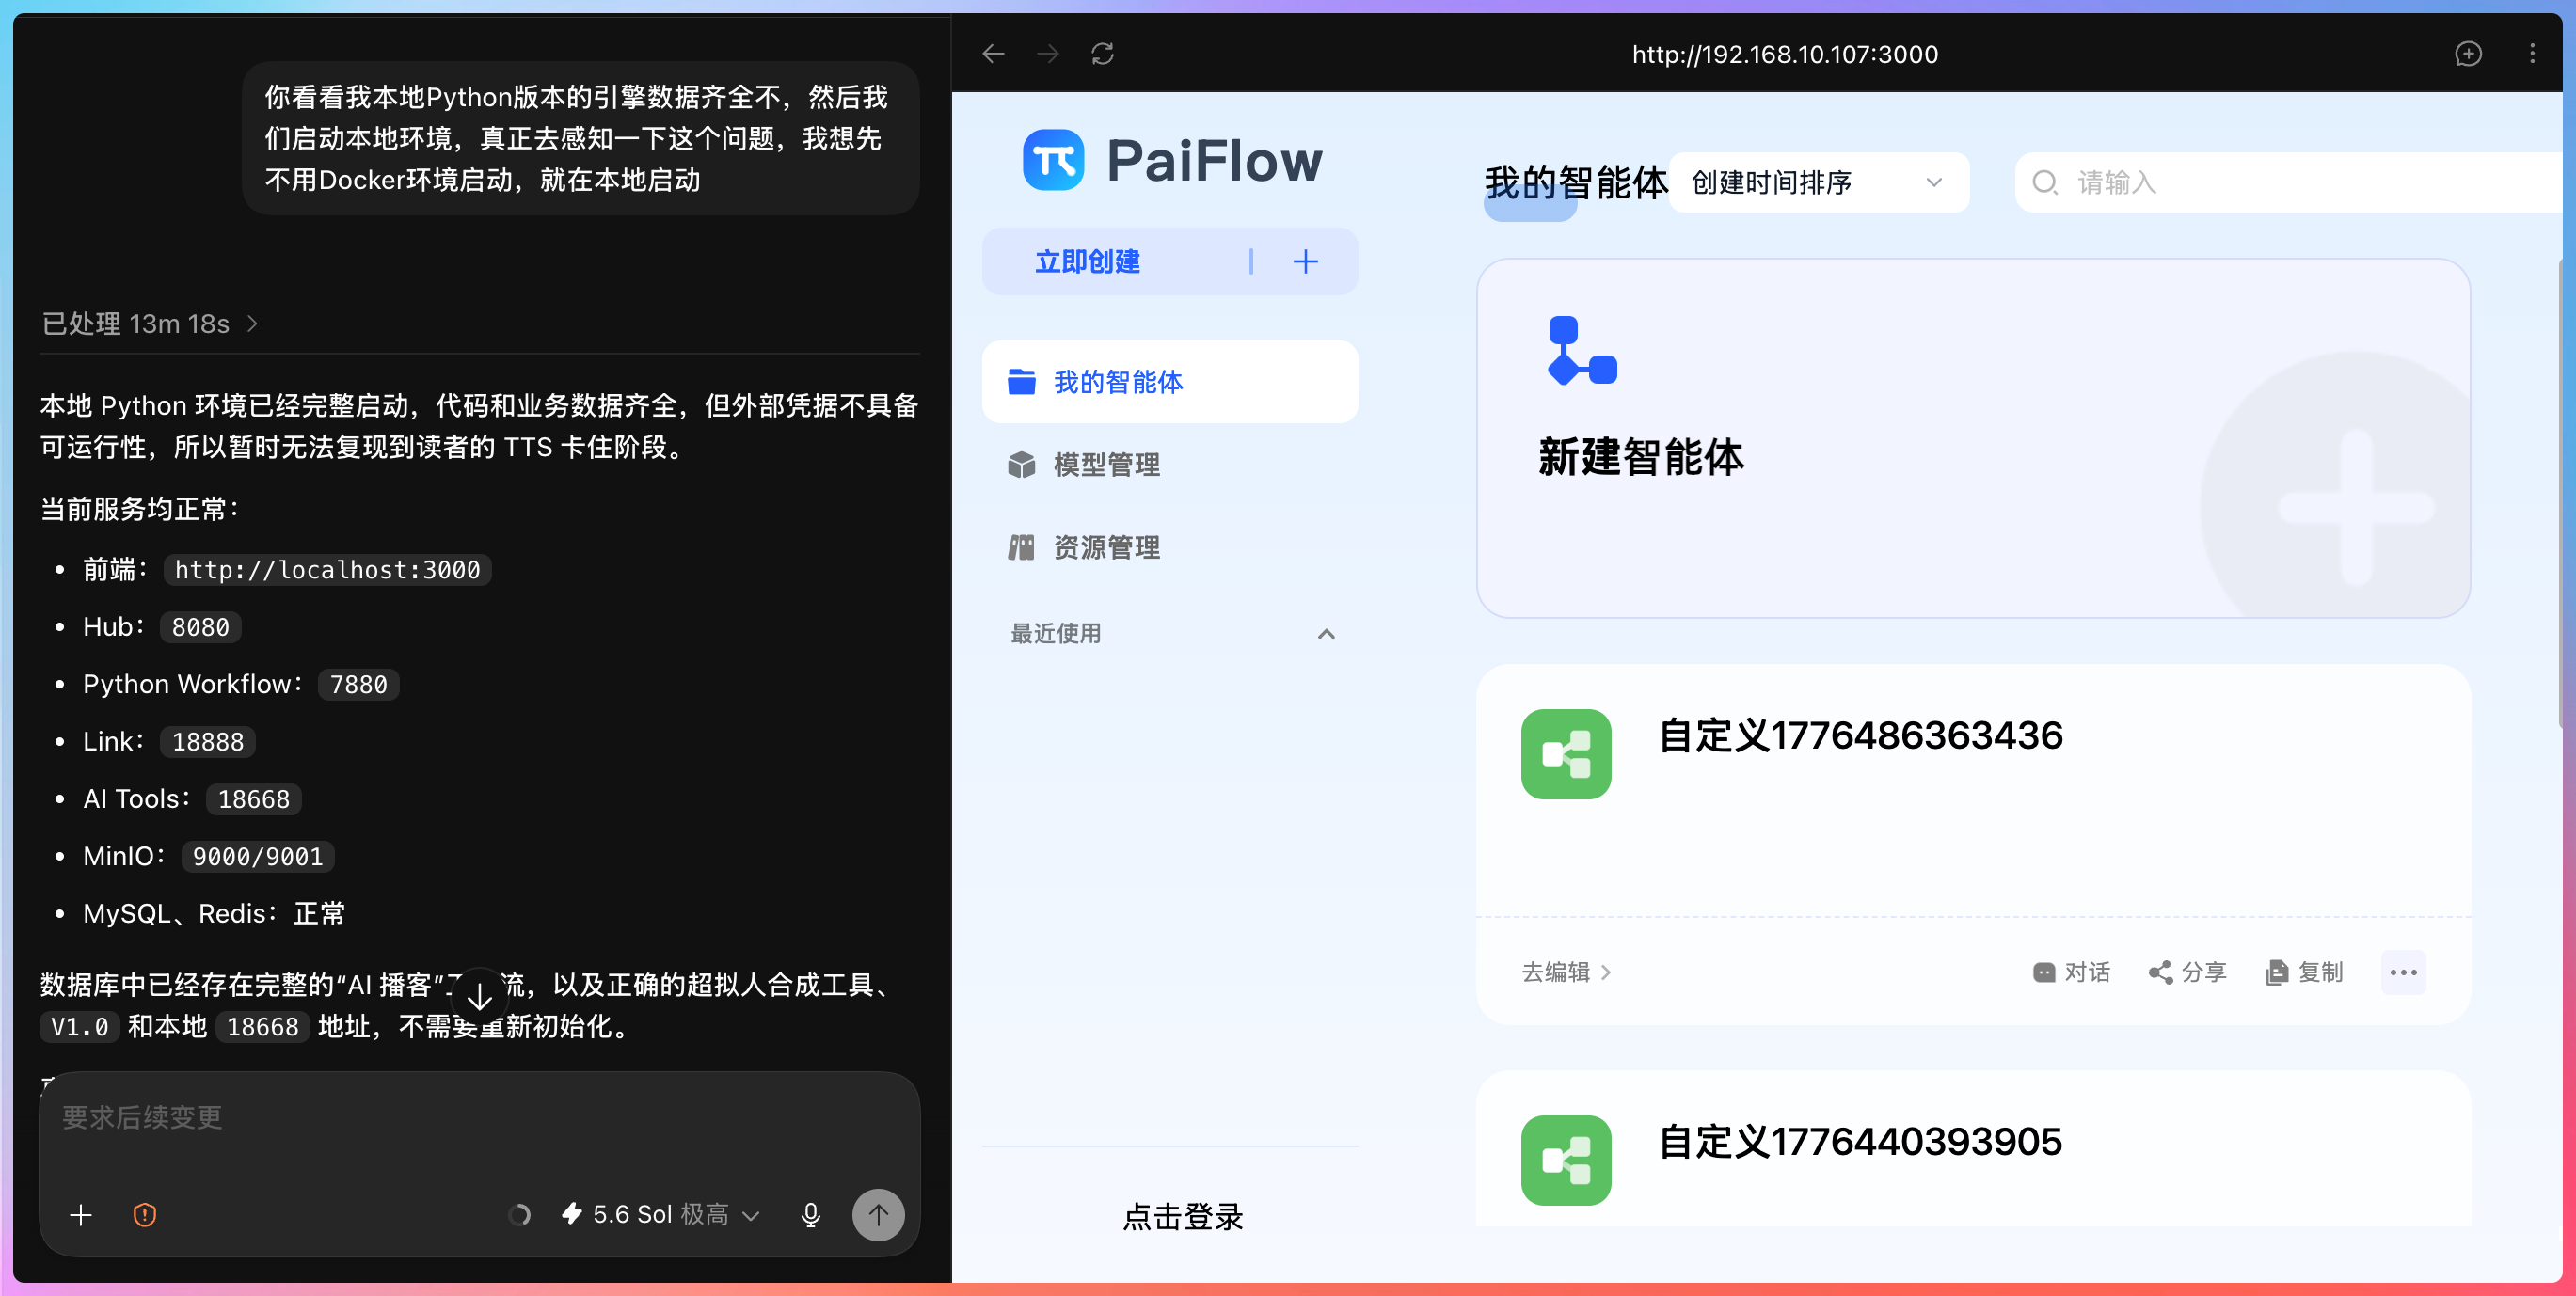
新版 Codex 有一个值得关注的功能更新,可以直接导入 Chrome 的密钥和登录态。
以后不用再通过 use Chrome 切换到外部浏览器去调试了,在 Codex 一个应用里就能完成,拿到更多上下文信息,减少授权和输入用户名密码的操作。
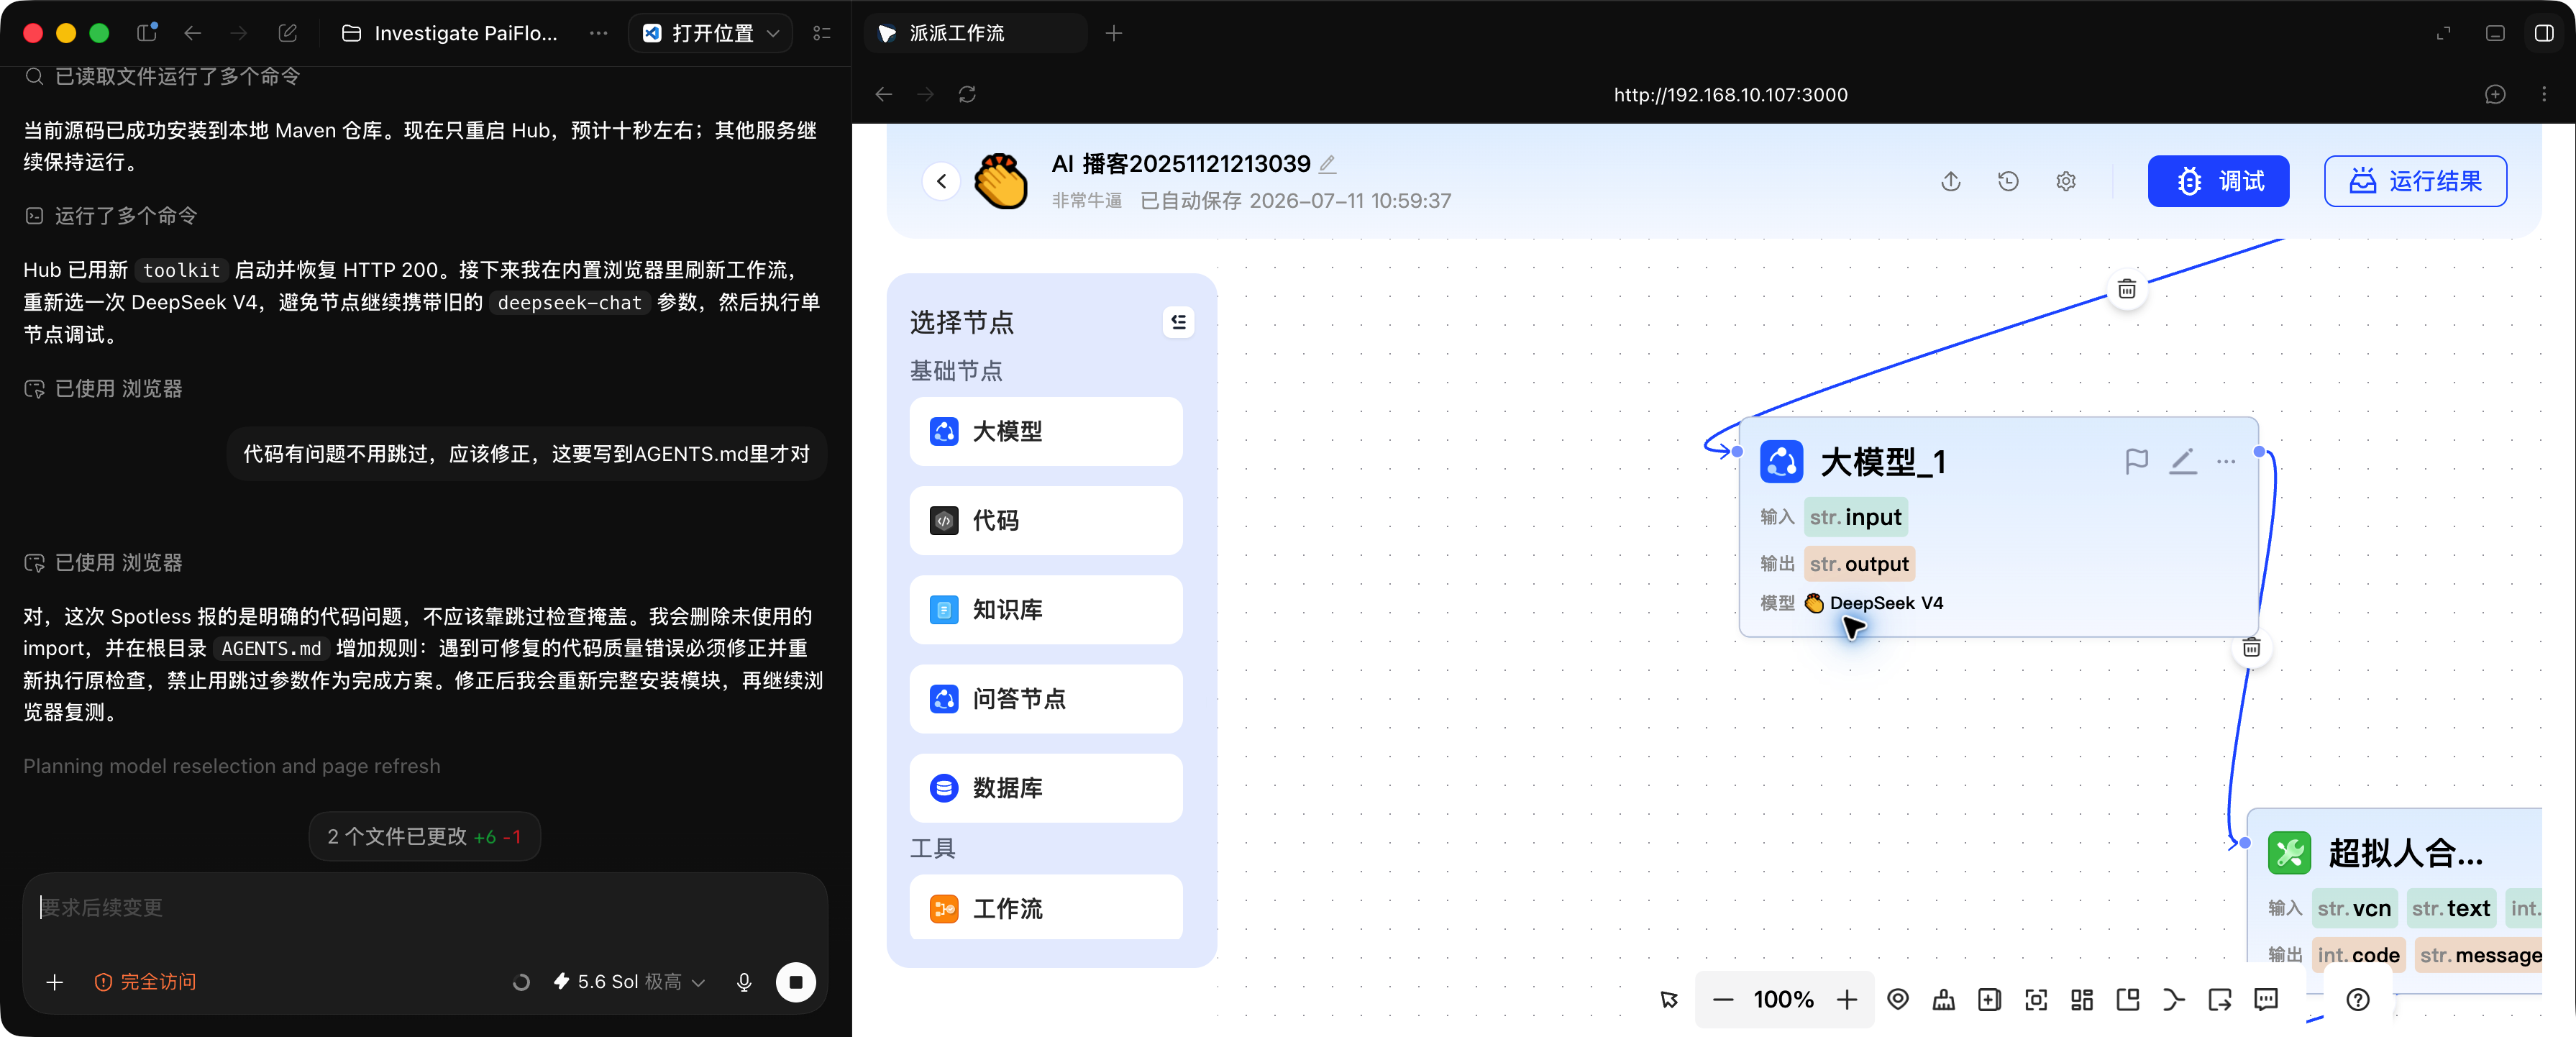
对开发来说这确实更友好。
但是,整个编码过程的速度让我很难受。
一个 23 分钟的任务,只完成了 2/5 步。我用的还是极高模式加快速模式。
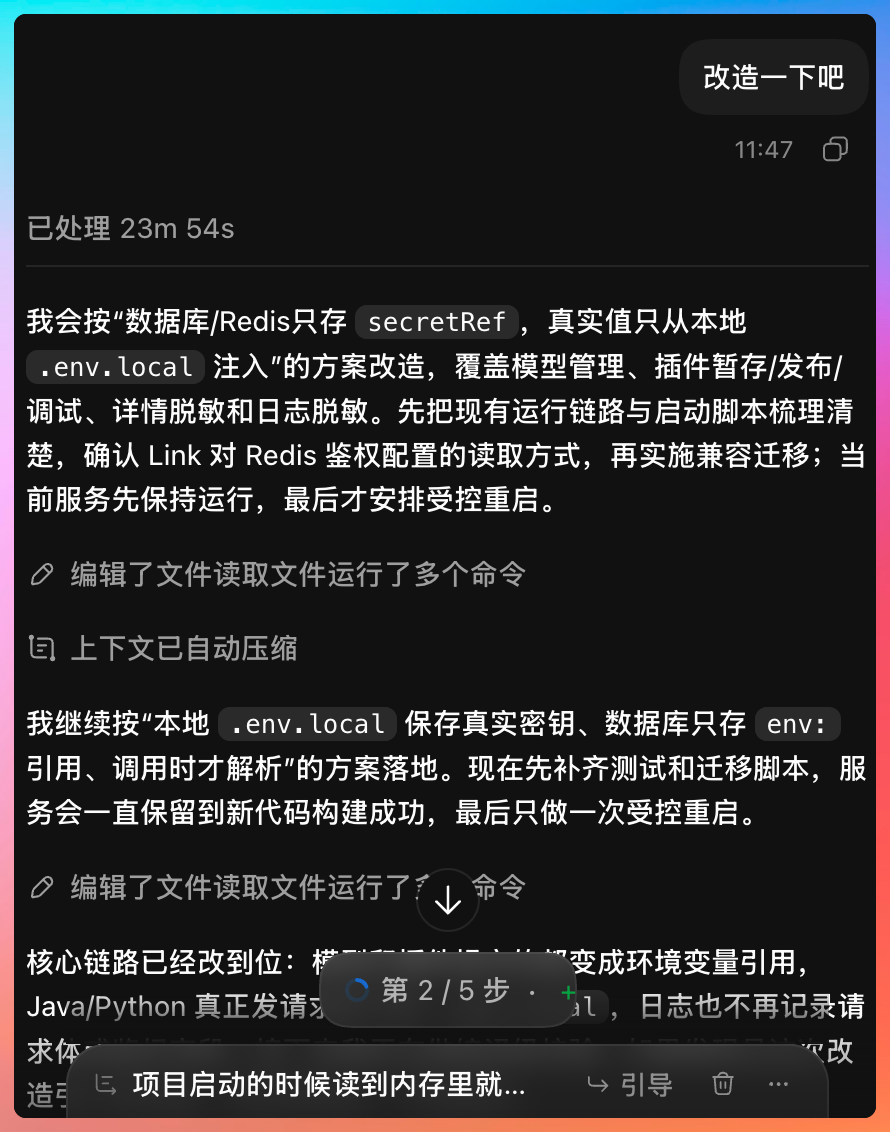
上下文也不够用,没有 1M 的窗口一个任务没完成就开始压缩了。
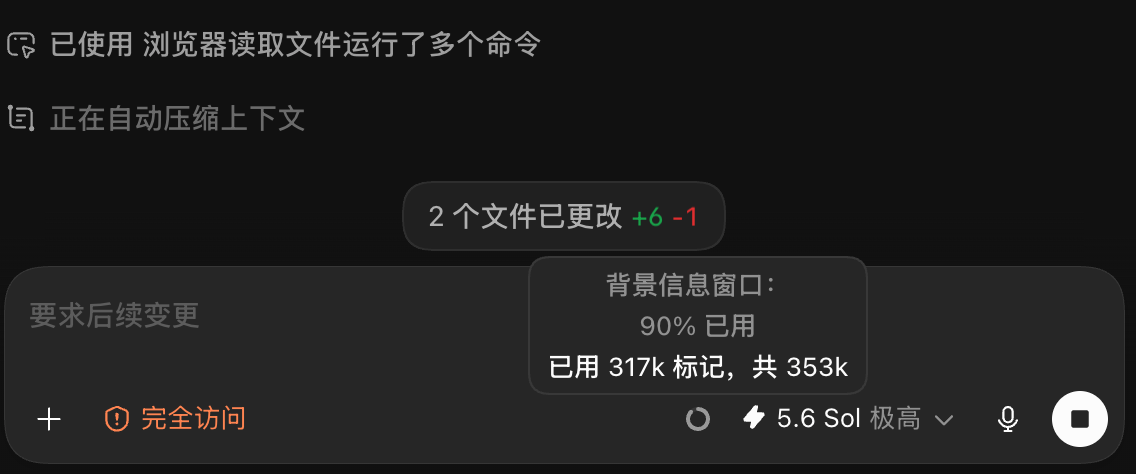
慢,实在是慢。
连续试了几个任务,改一个东西动不动就是半小时,不管这个任务难不难。有些 AI 博主说 GPT-5.6 屌炸天,我用下来暂时还没这种感觉。
就这个 TTS 超时的 bug,前后改了几个小时。
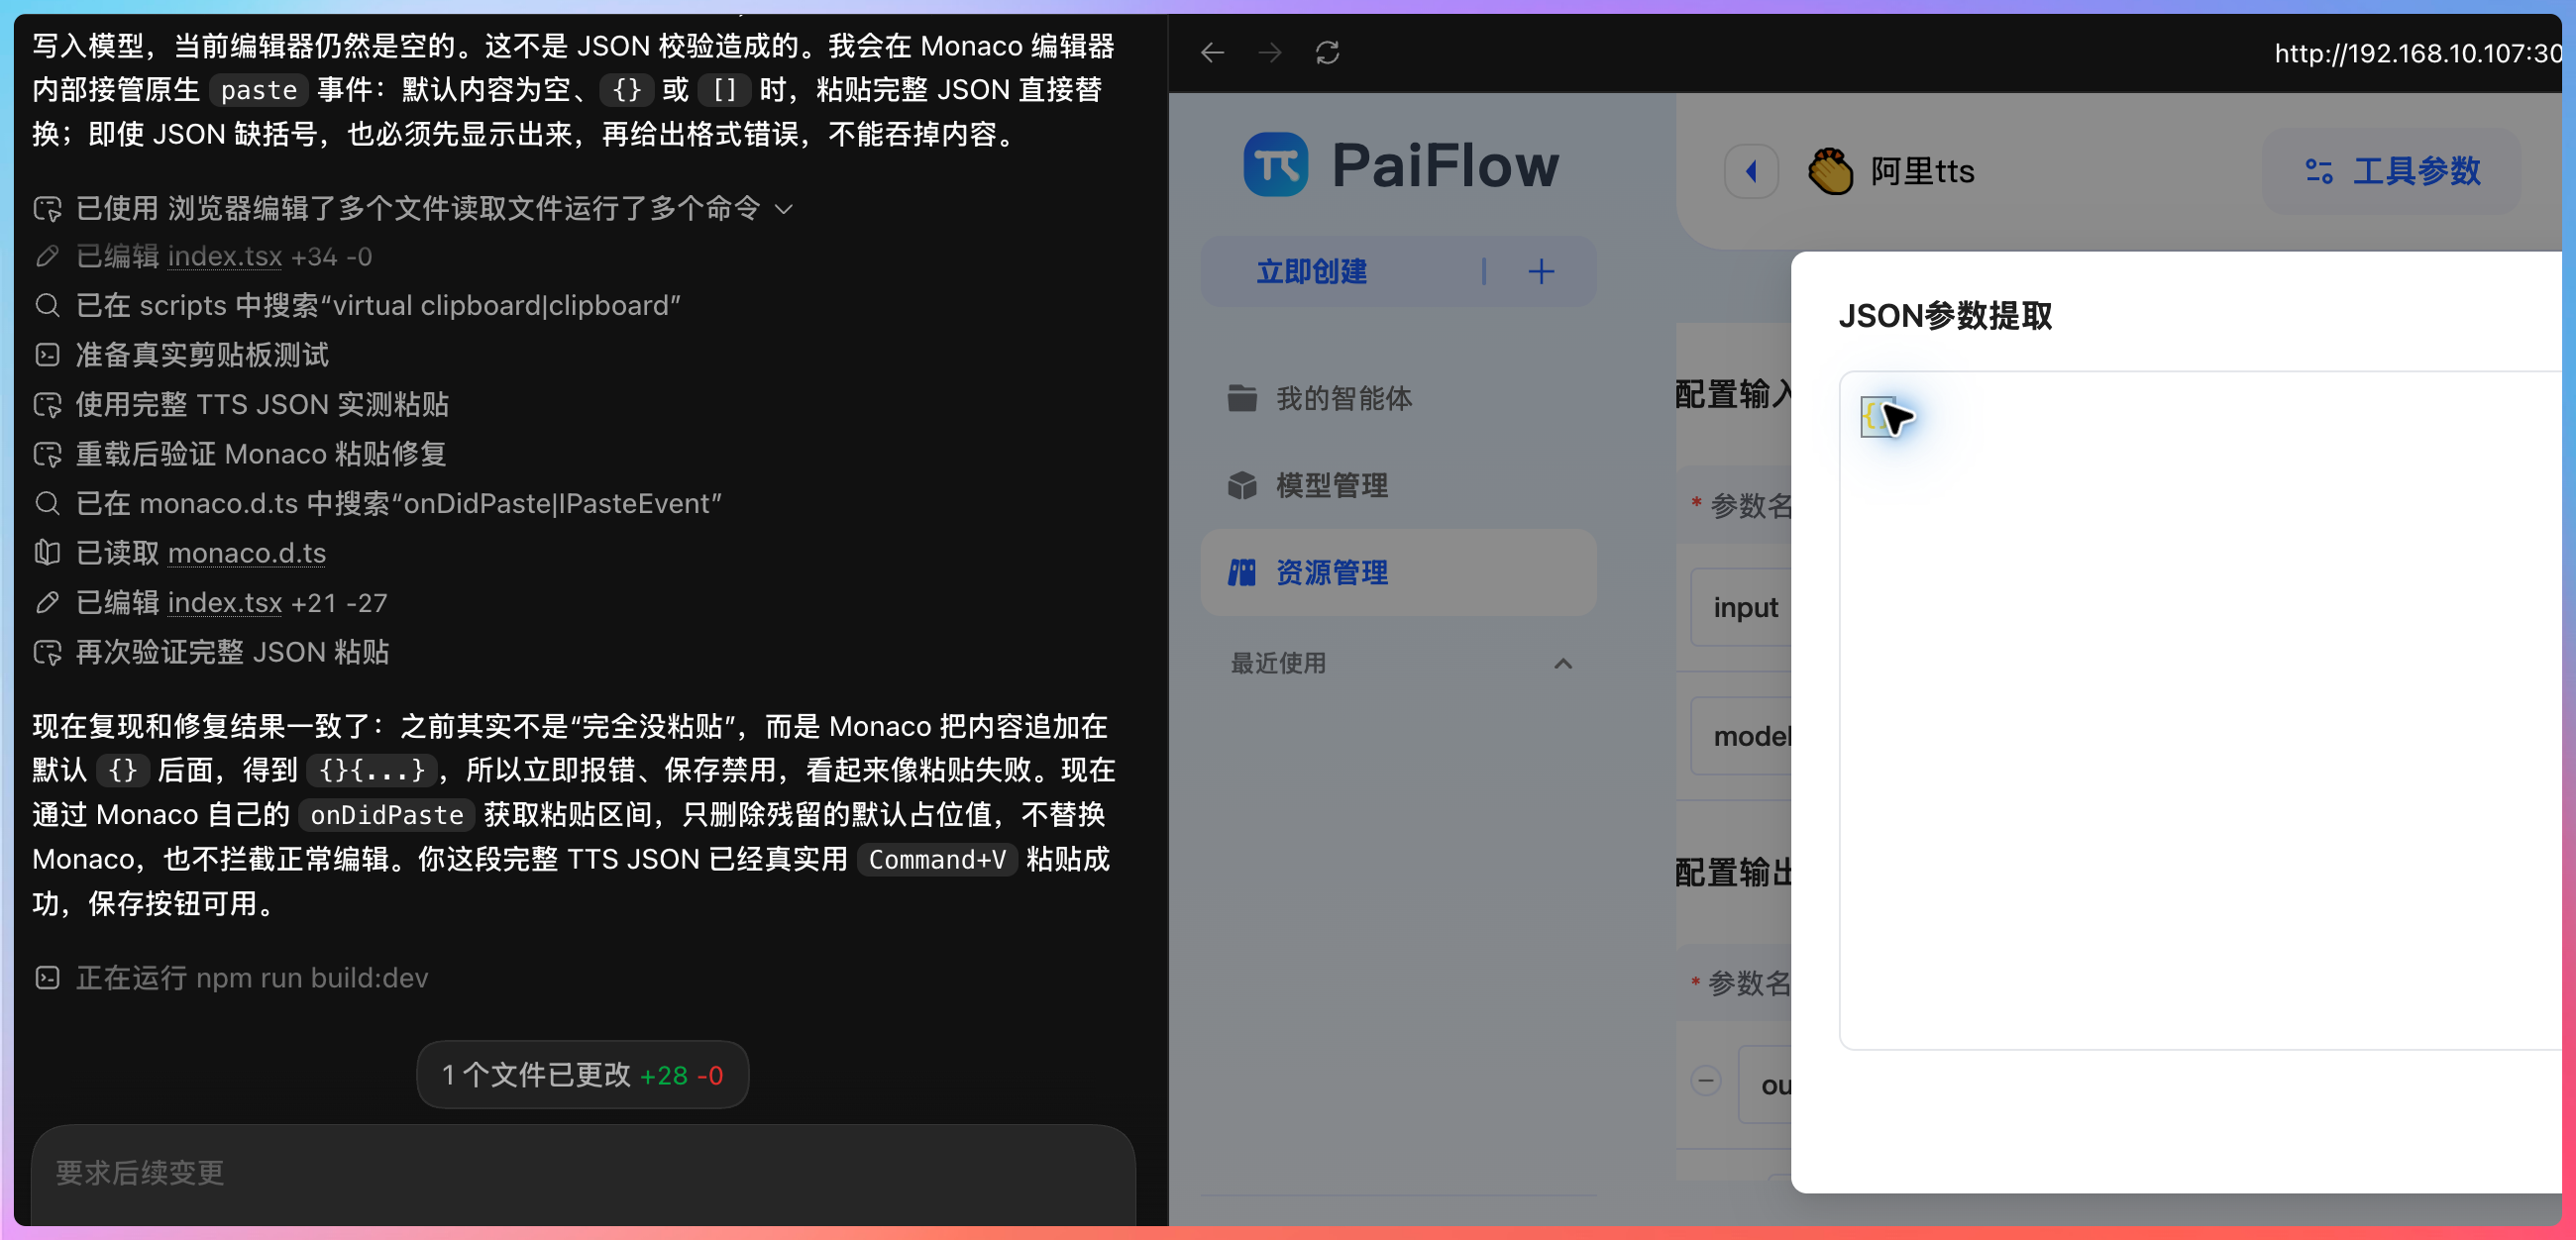
最后问题确实解决了。
AI 播客的整条工作流自己跑通了。
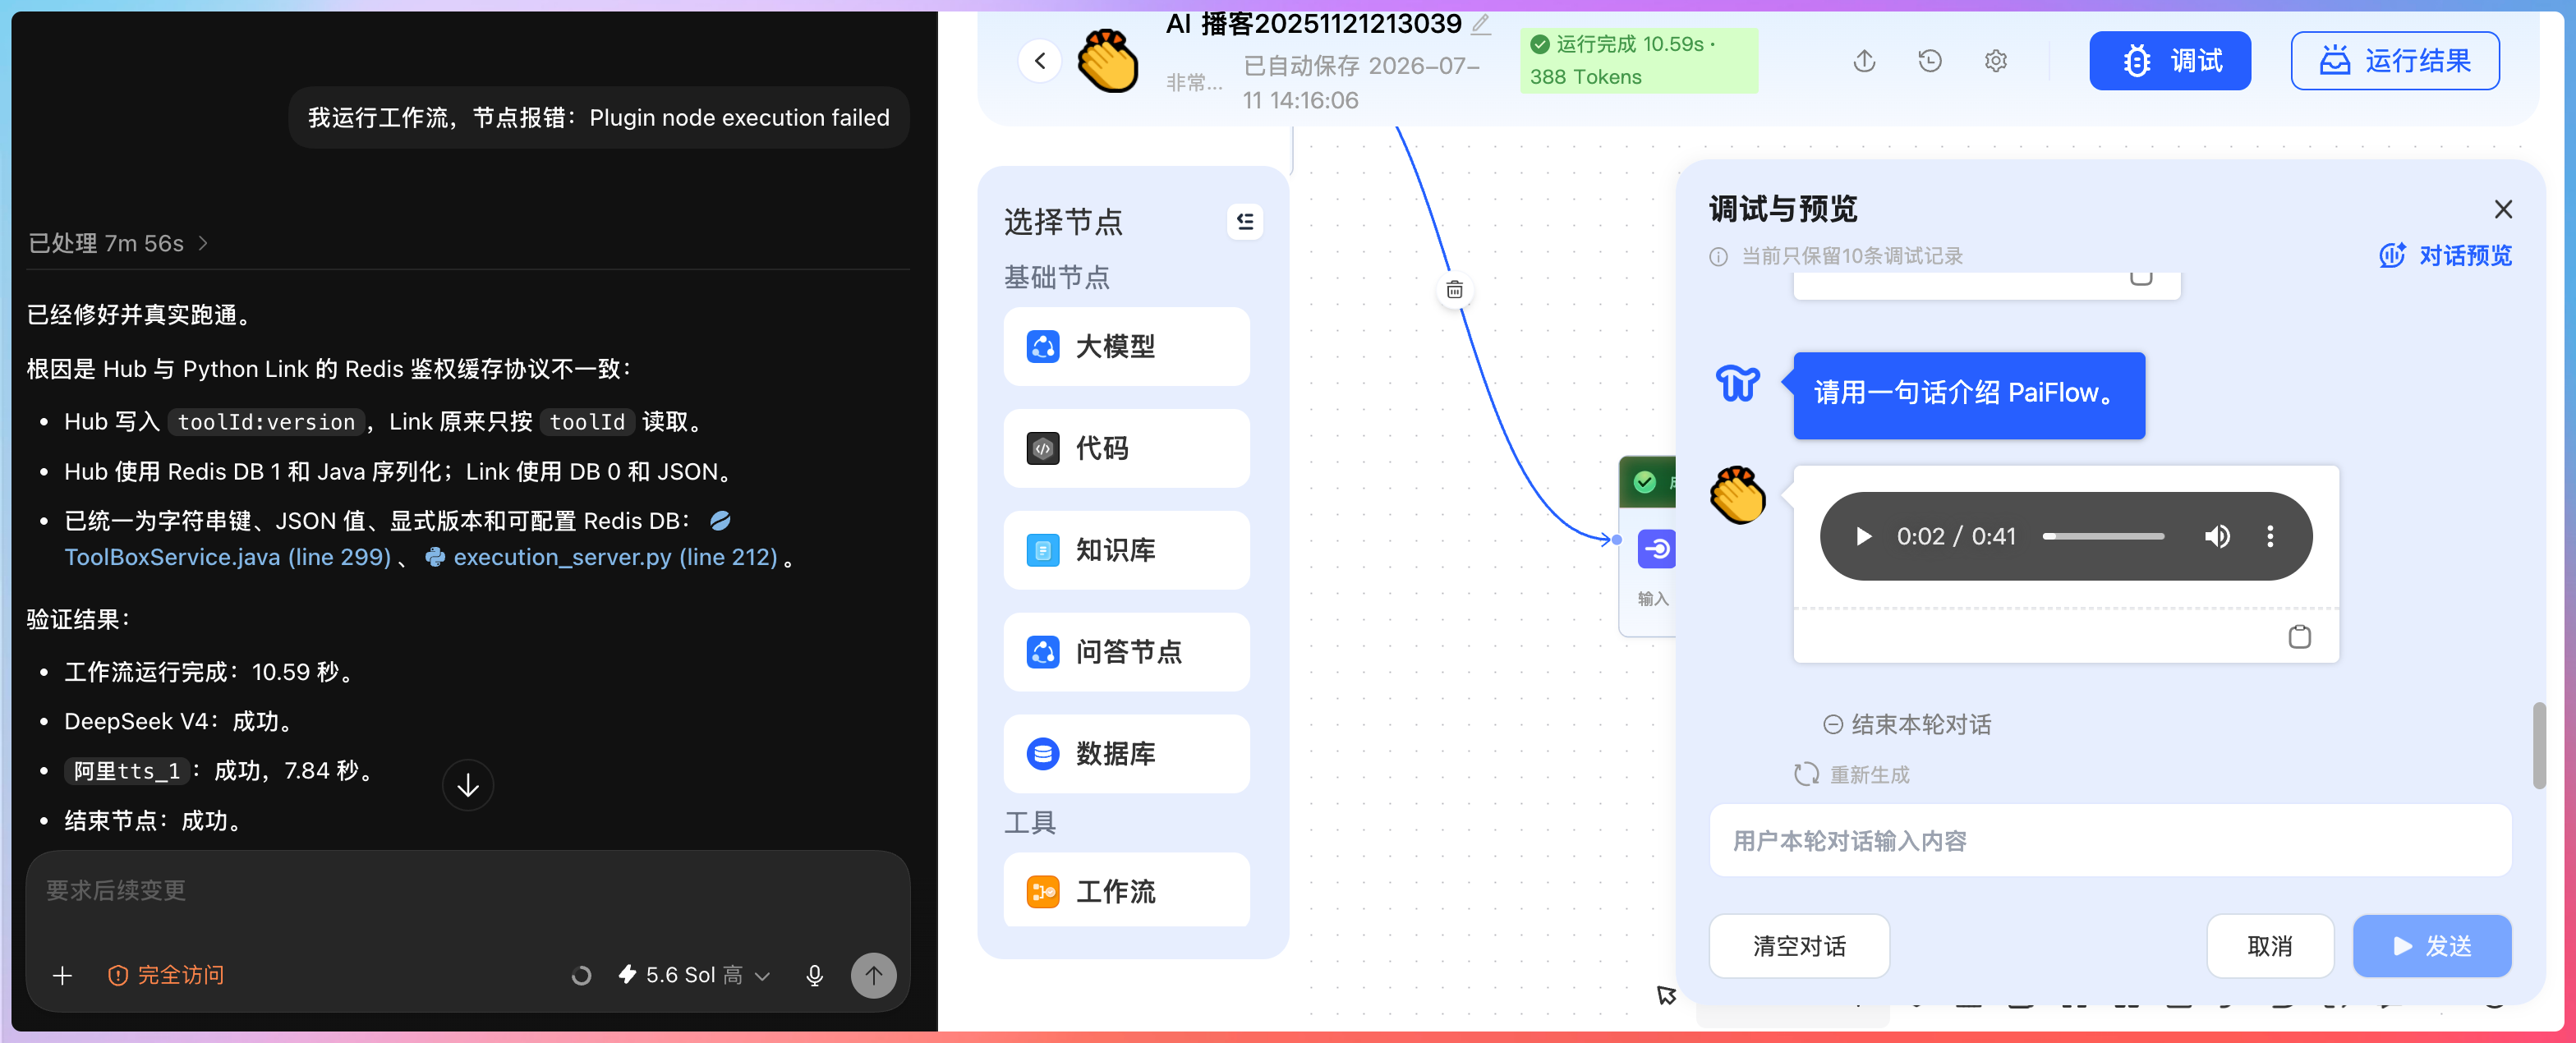
从修改的文件数量上看,这次确实是牵一发动全身,几十个文件都有改动。
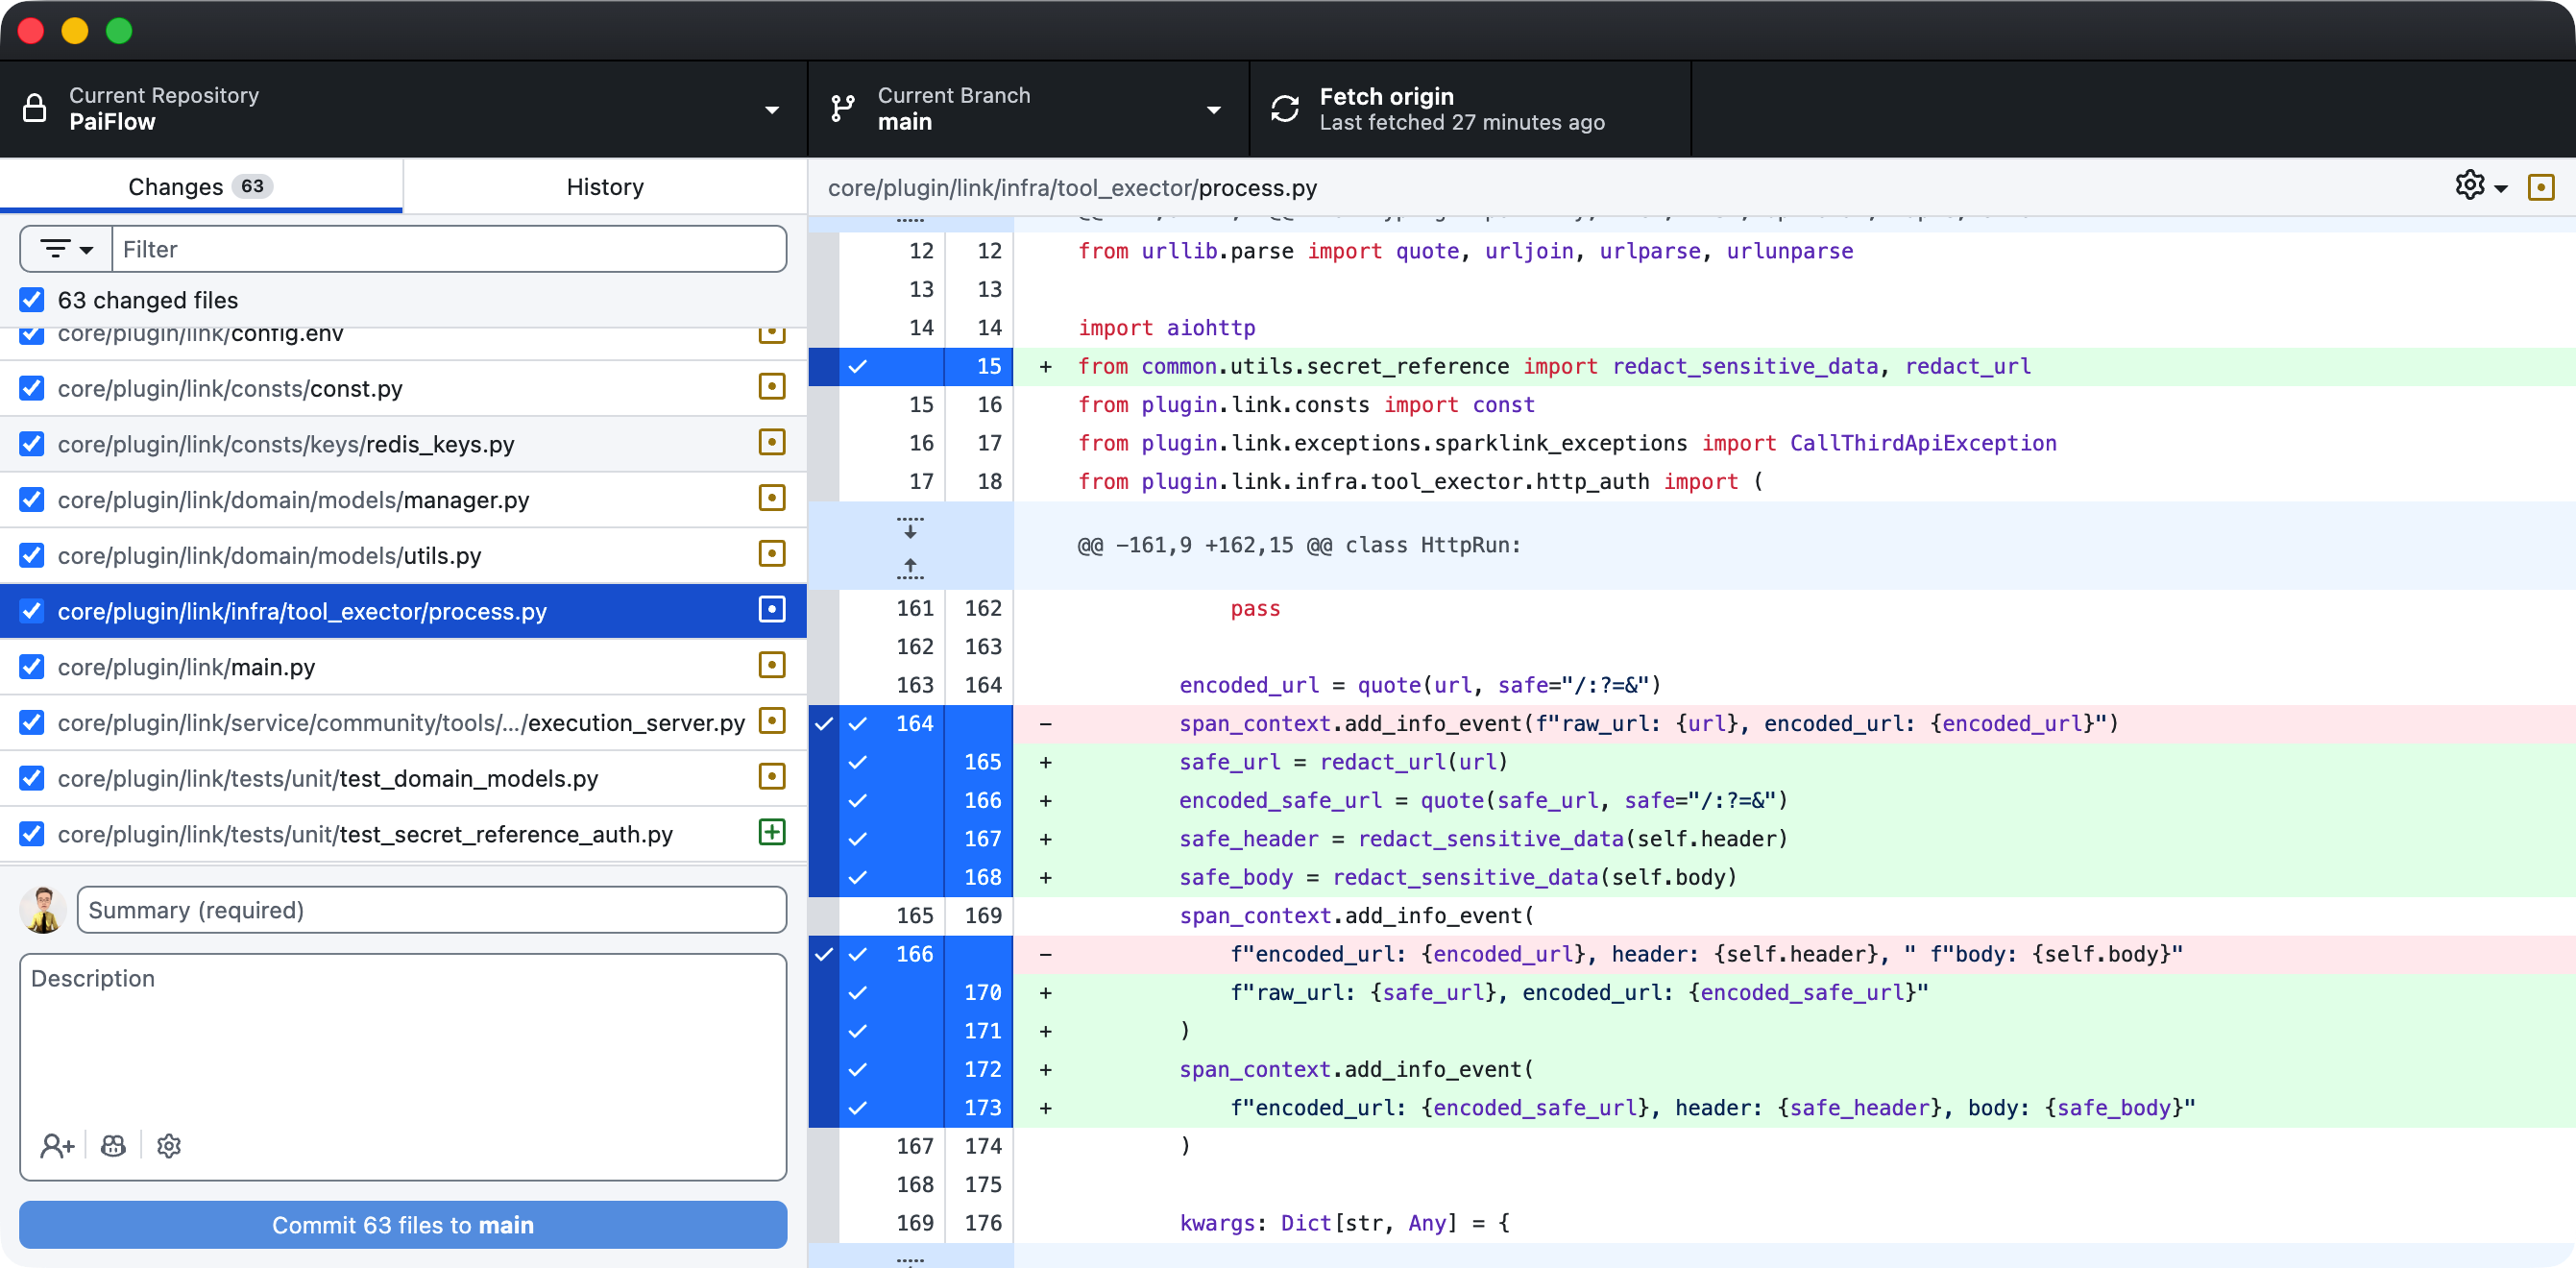
公平地说,GPT-5.6 的编码能力本身没问题,最终结果是对的,改动范围大说明它能处理复杂的跨文件依赖。
但整体执行效率感觉没有 5.5 快,当然也很可能是我的错觉。
04、文本能力
之前不管是 GPT-5.5 还是更早的版本,GPT 系列的文本生成能力一直是短板。
文字功底平平,中文表达一股翻译腔,写长文也容易重复和注水。
但这没办法,国产模型在中文表达上也不行。
有一点可以肯定,这次 GPT-5.6 在文本上有进步。
我把 GPT-5.6 接入了本地的知识库,又喂了几个项目的源码,搞了一个滑动窗口的定时任务,让它基于上下文回答读者提问。
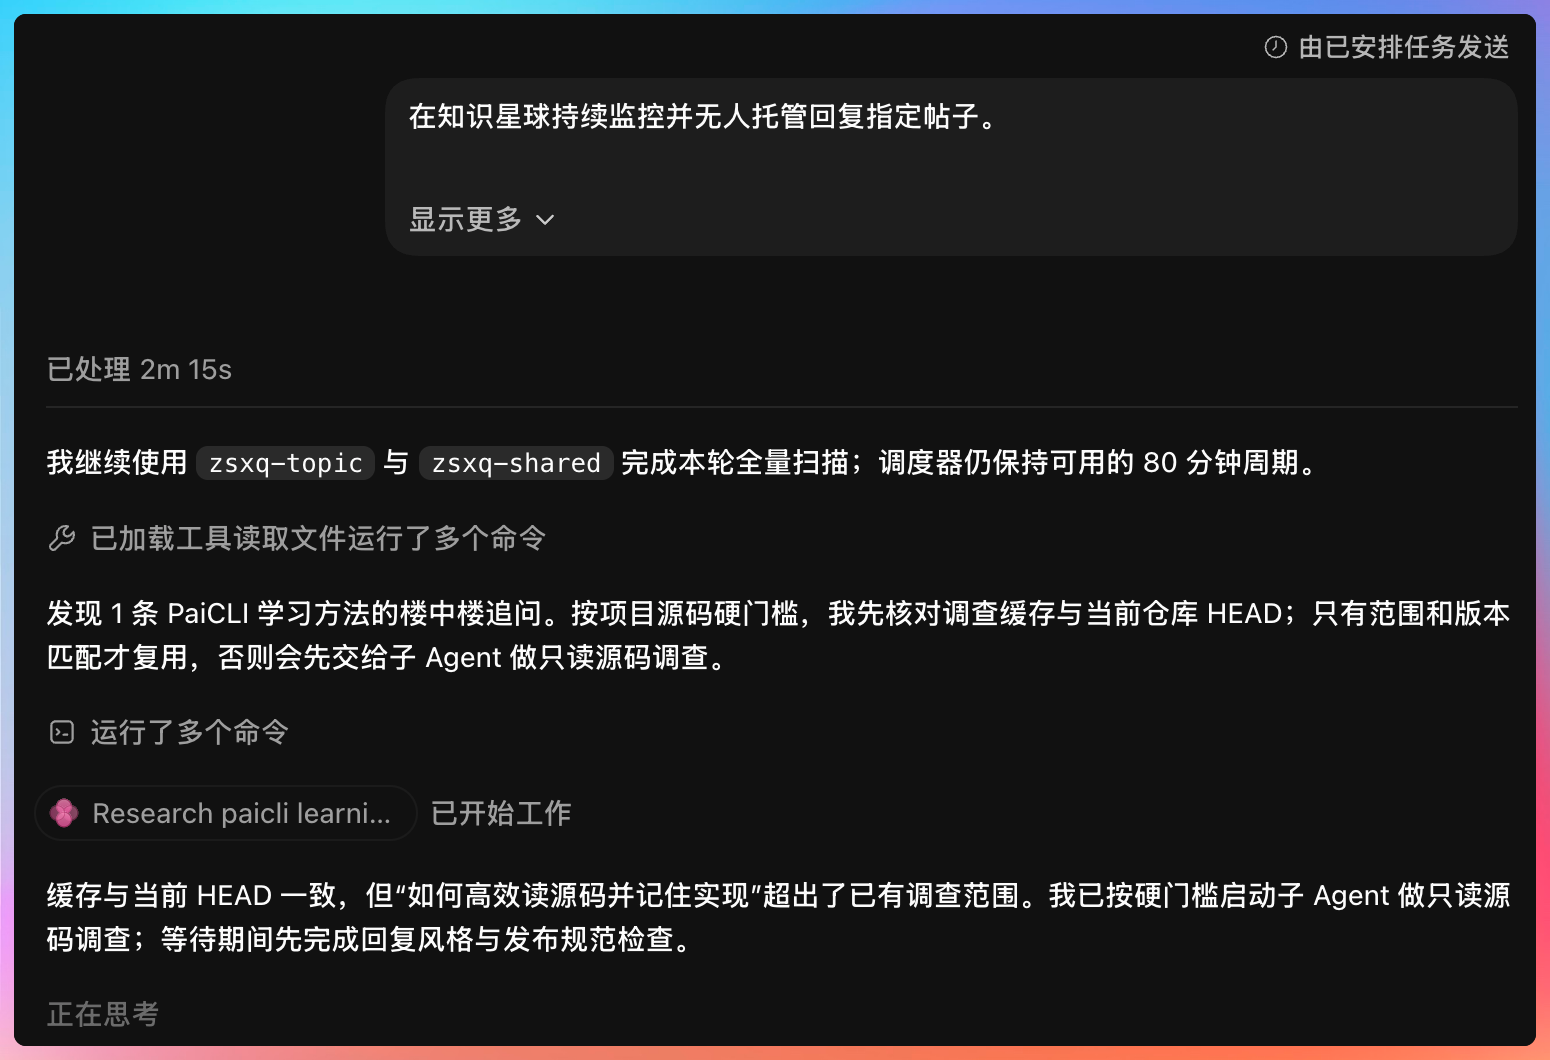
给大家看一个实际的例子。
有位读者问了这样一个问题。
我现在对于 Agent 开发后续准备有点迷茫,现在实习开发了一个知识库 Agent 但是只知道具体的流程,很多实现细节都不太清楚,参考了 LM Wiki 的项目结合企业自己的知识架构做的,如何在秋招中根据这段经历有所帮助?
GPT-5.6 的回复质量不错,我贴出来大家感受一下。
回复示例
先给结论,这段实习对秋招有帮助,而且比”自己照着教程做了一个 RAG 项目”更有说服力。现在缺的不是再背一套 Agent 概念,而是把”我知道流程”变成”我能解释每个关键设计,并讲出真实问题和验证结果”。
第一步,把项目吃透到能画出一张图
从用户问题开始,按顺序画出整条链路,问题处理、知识检索、文档切片、Embedding、召回、重排、上下文组装、大模型生成、引用返回。每个环节写清楚四件事。
- 公司用了什么方案
- 为什么这样选
- 你参与了哪部分
- 出过什么问题
LM Wiki 只是参考来源,不需要回避。面试时可以直接说,我们参考了它的整体思路,但结合企业知识结构在某些环节做了调整。重点讲清楚哪些直接复用、哪些重新设计、为什么改。
第二步,Agent 八股先准备三组
第一组是 RAG,切片策略、Embedding、向量检索与关键词检索、混合检索、重排、TopK、上下文窗口、幻觉与引用。
第二组是 Agent,Tool Calling、ReAct、Memory、工作流和自主 Agent 的区别。如果项目本质主要是 RAG 问答,就坦诚说它是“带知识检索能力的 Agent 应用”,不要硬包装成能自主规划和执行复杂任务的 Agent。
第三组是工程问题,权限隔离、超时重试、并发、日志、调用成本、数据更新、效果评估。企业项目最容易和个人 Demo 拉开差距的,往往就是这些部分。
第三步,亮点和难点从实际问题里选
- 如果文档结构复杂,讲切片后语义被截断,后来如何按标题或段落处理
- 如果专业术语检索不准,讲为什么只用向量召回不够,是否增加了关键词召回或重排
- 如果企业知识有部门边界,讲权限过滤如何进入检索条件
- 如果无法判断效果好坏,补一套真实测试集,整理 30~50 个业务问题,记录命中率、引用是否正确、回答是否可用
第四步,简历按这个结构写
“针对企业内部【资料类型】分散、人工检索效率低的问题,参与建设知识库 Agent;负责【你真实负责的模块】,结合企业知识结构完成【具体改造】;针对【真实难点】采用【真实方案】,并通过【实际问题数量或真实指标】验证效果。”
所有方括号都要换成真实内容,只写自己做过、能顺着代码讲下去的部分。
这个回复的结构清晰,给到了可执行的步骤。
05、站点生成
站点是 Codex 新增的一个功能。
我把进阶之路和技术派两个站点的内容交给了 GPT-5.6,让它基于这些素材生成一个展示站点。
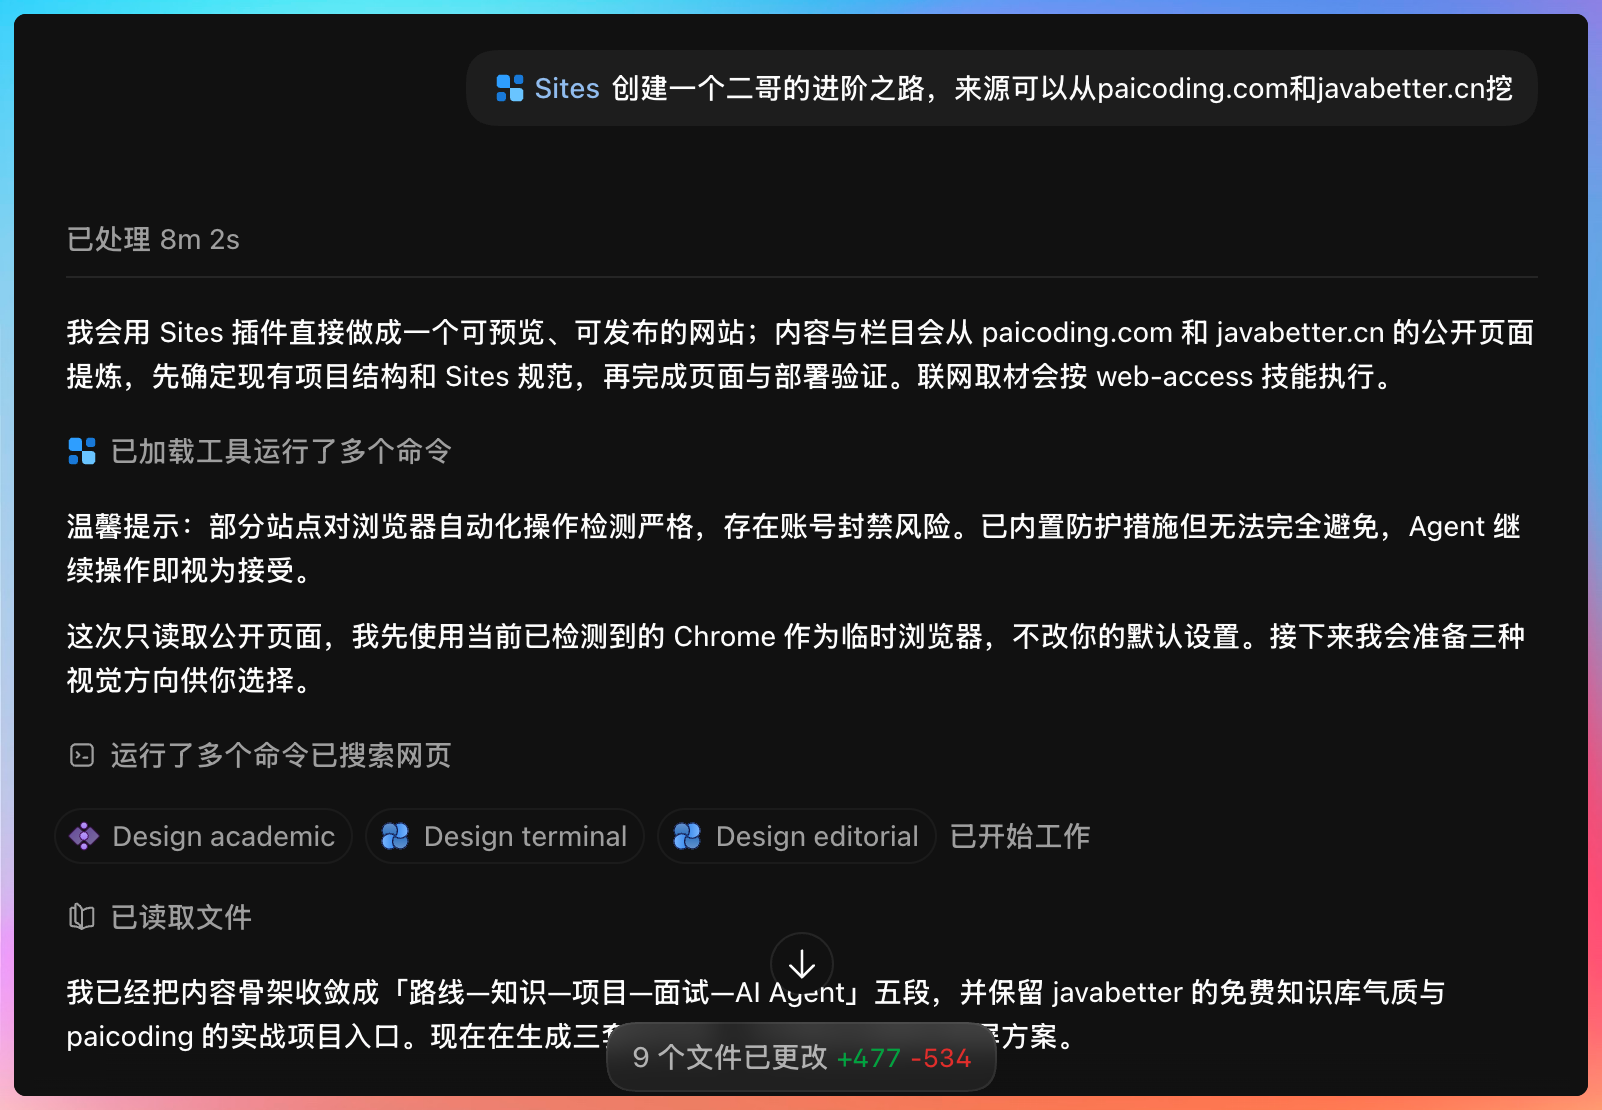
出来的效果超出了我的预期。
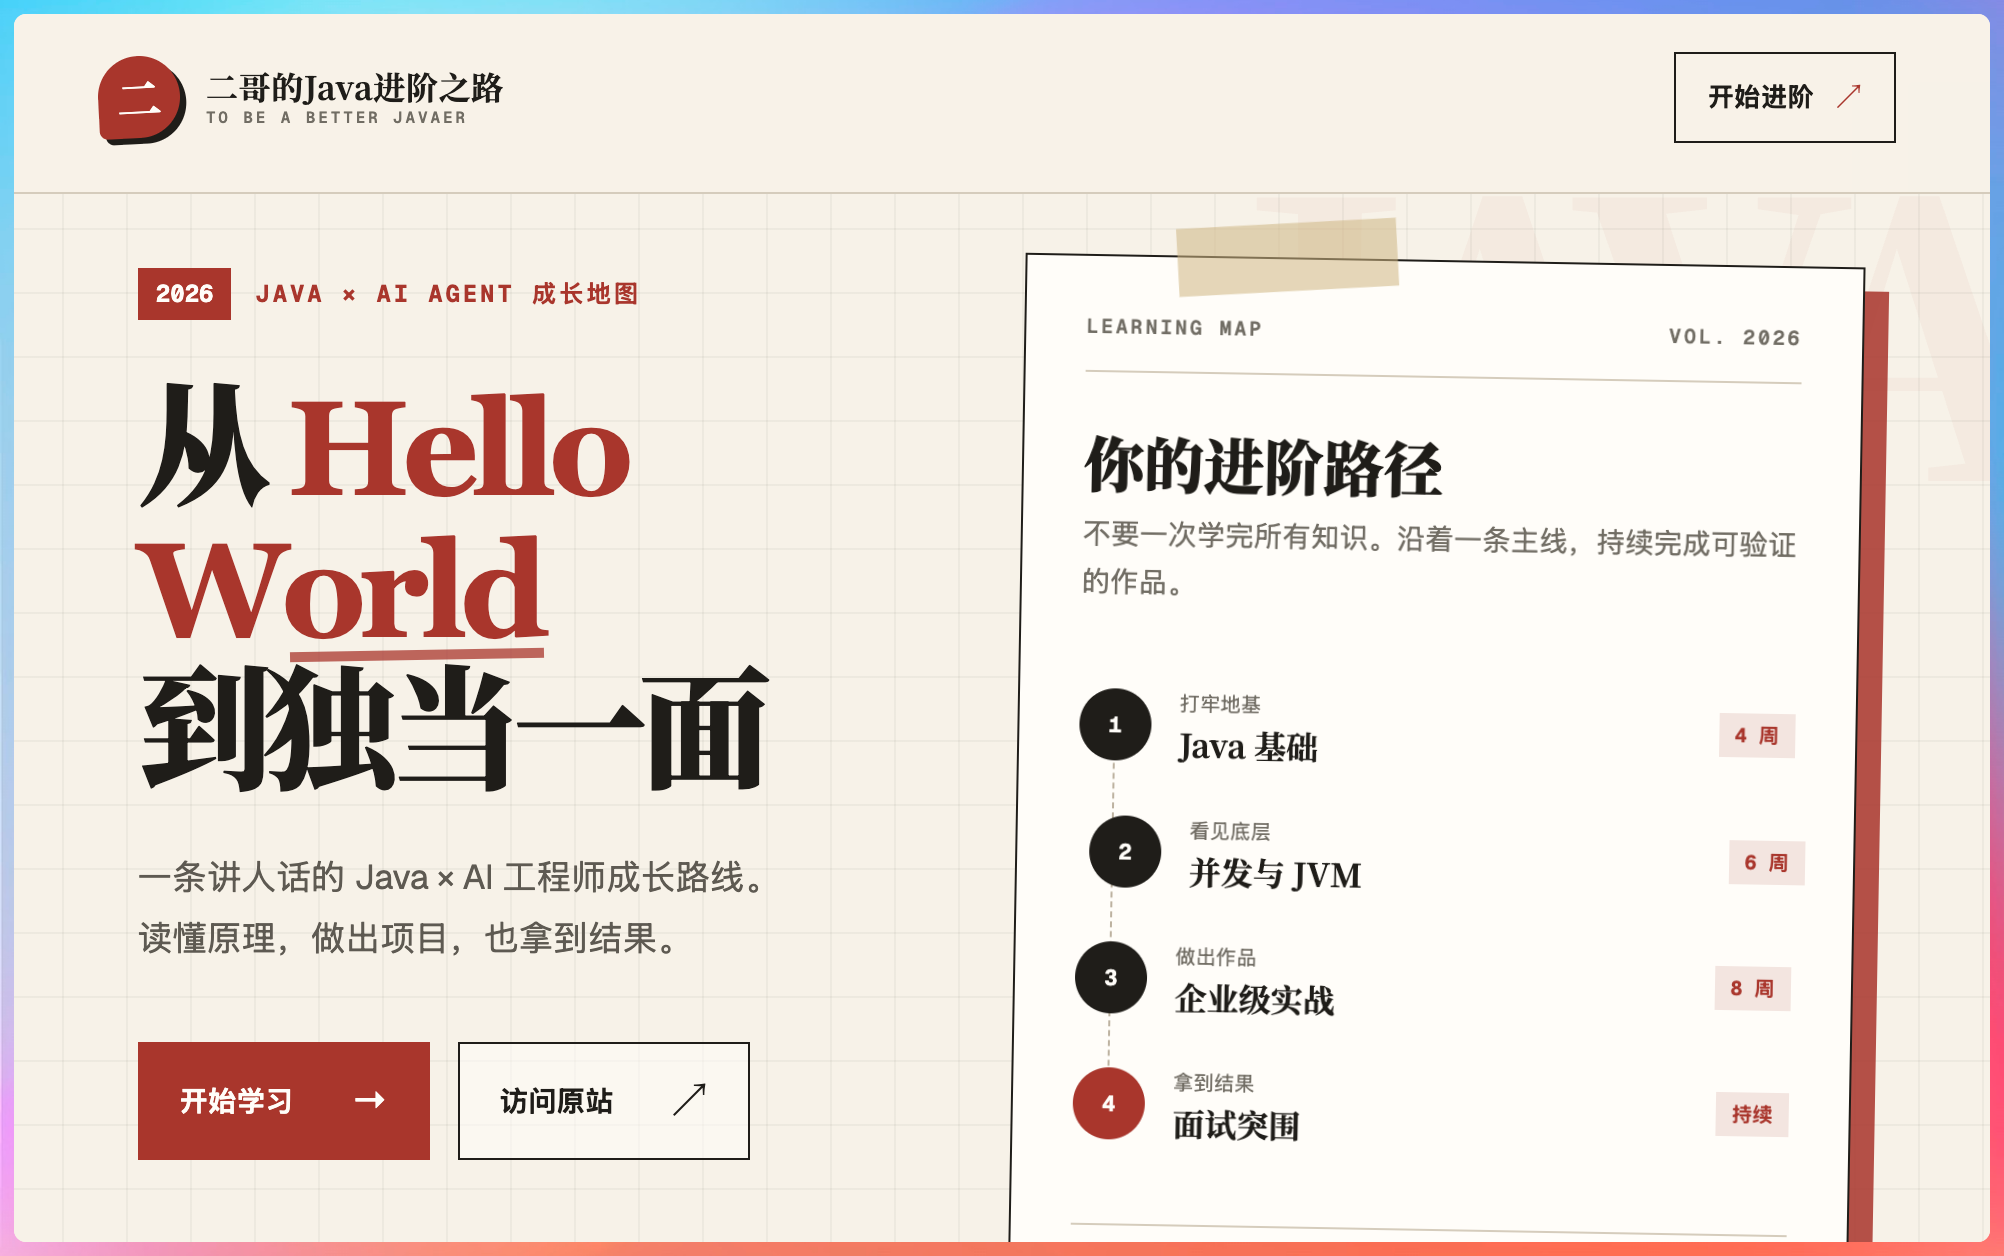
https://erge-java-roadmap-2026.focijaco527.chatgpt.site
我已经发布了,大家可以点进去感受一下。
整体设计挺有档次。
首页有清晰的导航栏、分类入口卡片、学习路线图的可视化展示,底部还有项目介绍和联系方式。
ending
两天测下来,GPT-5.6 给我的感觉就四个字,有进步,但还需要更进一步,😄。
(不是四个字你也别介意)
这个个比喻可能不太恰当但很能说明问题——GPT-5.6 像一个期末考试总分上去了,但数学从 90 掉到了 89 的学生。
生图出现三只手是很不应该的一件事。毕竟GPT-5.5 在没有加限制的情况下,可是一次都没出现。
【工具这东西,不怕有短板,怕的是短板恰好出现在你每天要用的场景上。】
有一说一,取消 5 小时限制这事,OpenAI做的是真nice。
希望Claude也能跟进,国内的大模型也能跟进,😄
别限制了啊。
我们下期见。