27届秋招真开了,每天改30多份简历的日子又来了,痛苦也快乐着。😄
有球友问AI时代,Agent八股和Java后端传统八股应该怎么准备?
我特意花了一个小时,给大家整理了一下清单,来吧,兄弟姐妹们,划重点来喽。
对于Java八股,就是我以前提到的Java后端四大件,也就是面渣逆袭上给出的高频题目。
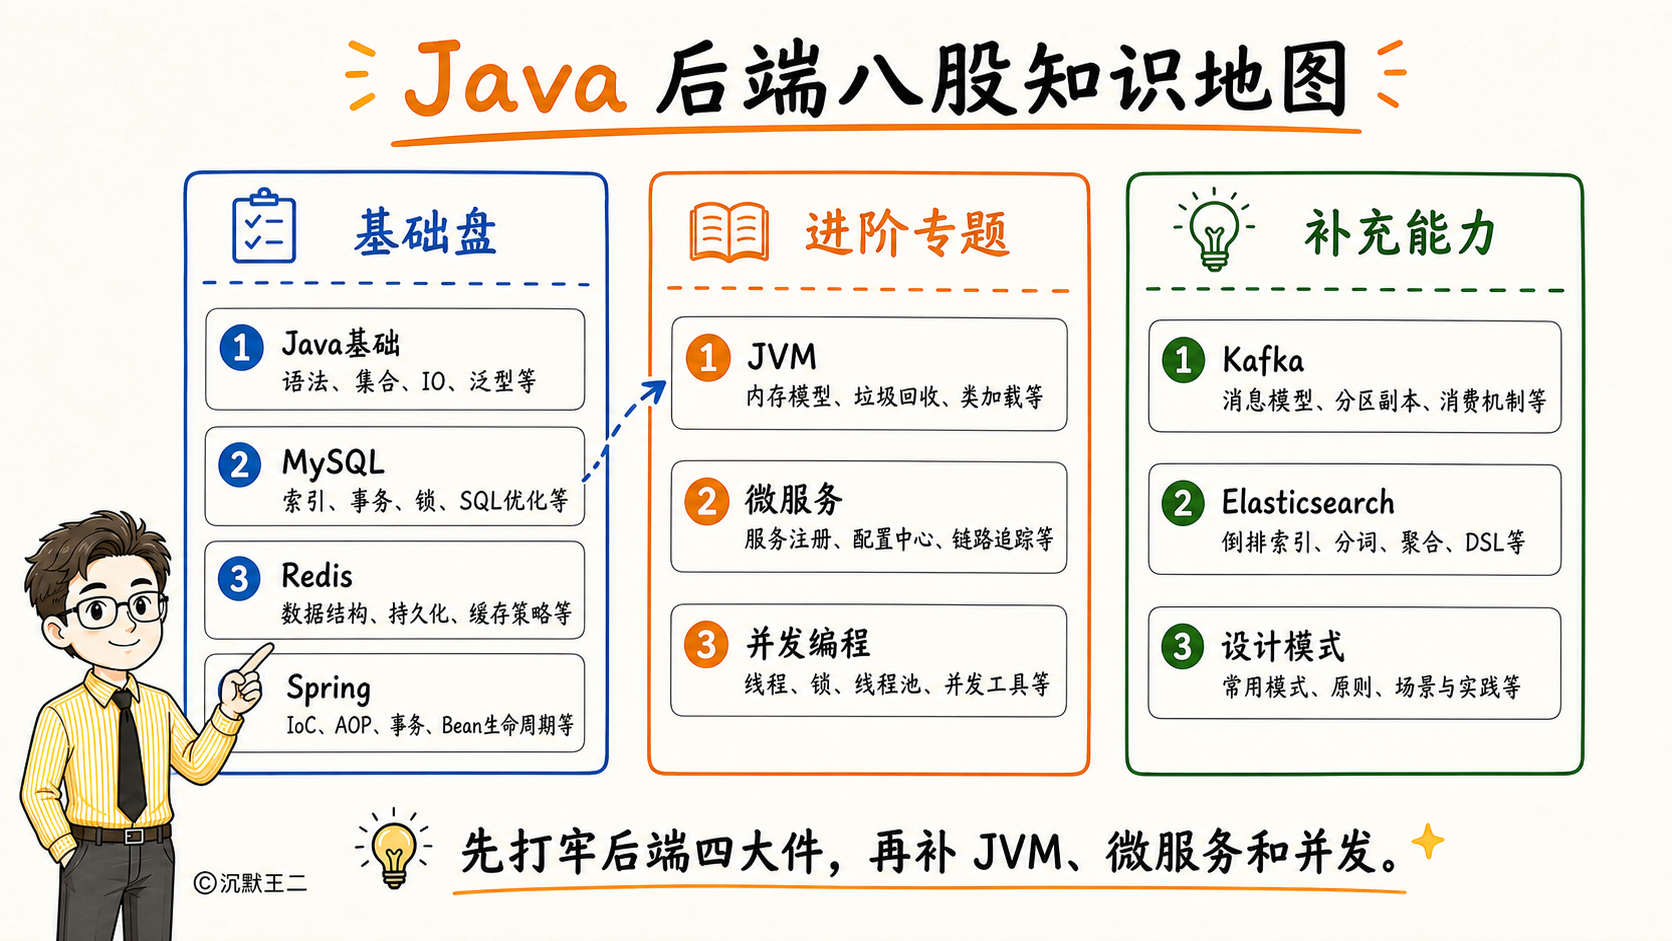
传统后端篇
Java基础
- HashMap的底层实现(数组加链表加红黑树,什么时候从链表转红黑树,为什么是8)。
- ConcurrentHashMap怎么保证线程安全(JDK7分段锁和JDK8的CAS加synchronized的区别)。
- 线程池的核心参数(核心线程数、最大线程数、队列类型、拒绝策略),你要能讲清楚一个任务提交之后线程池是怎么处理的。
- synchronized和ReentrantLock的区别以及各自的使用场景。
- volatile解决了什么问题(可见性和有序性但不保证原子性)。
MySQL。
- B+树索引的原理(为什么用B+树不用B树不用Hash——B+树叶子节点有序适合范围查询、所有数据在叶子节点查询稳定)。
- 事务的四个隔离级别以及每个级别能解决什么问题(读未提交、读已提交、可重复读、串行化),MySQL默认用可重复读通过MVCC实现。
- 怎么优化慢查询——explain看执行计划,重点关注type是不是全表扫描、key有没有命中索引、rows扫描了多少行。
Redis。
- 五大数据结构及使用场景——String做缓存和计数器、Hash做对象存储、List做消息队列、Set做去重和交集运算、ZSet做排行榜。
- 缓存穿透(查不存在的数据打到数据库——布隆过滤器或缓存空值)、缓存击穿(热点key过期瞬间大量请求打到数据库——互斥锁或永不过期)、缓存雪崩(大量key同时过期——过期时间加随机值打散)。
- 分布式锁怎么实现(SET key value NX EX加lua脚本保证释放锁的原子性,或者Redisson的看门狗机制)。
Spring全家桶。
- IOC的核心思想(控制反转,对象的创建和管理交给Spring容器而不是你自己new,好处是解耦)。
- AOP的核心思想(面向切面,把日志、事务、权限校验这些横切关注点从业务代码中抽出来统一管理)。
- 自动配置的基本原理(@SpringBootApplication里的@EnableAutoConfiguration加载META-INF/spring.factories里配置的自动配置类,根据条件注解决定要不要生效)。
然后是JVM、微服务、并发编程。
JVM。
- JVM内存模型——堆(对象实例)、栈(局部变量和方法调用)、方法区(类信息和常量池)、程序计数器。
- 垃圾回收的基本原理——可达性分析判断对象是否存活、分代收集(年轻代用复制算法、老年代用标记整理)。
- 常见的垃圾收集器——G1的基本思想(把堆分成多个Region,优先回收垃圾最多的Region)。
- 什么时候会发生Full GC(老年代空间不足、方法区空间不足、System.gc())。
微服务。
- 注册中心的作用(服务注册和发现,Nacos的推拉模式)。
- 网关的作用(路由转发、限流、鉴权,Gateway的过滤器链)。
- 熔断限流的策略(Sentinel的滑动窗口限流、令牌桶限流、熔断降级的三个状态)。
- 分布式事务怎么保证数据一致性(Seata的AT模式,两阶段提交)。
并发编程。
- AQS的基本原理(抽象队列同步器,ReentrantLock底层用的就是AQS)。
- ThreadLocal的原理和内存泄漏问题(每个线程维护一个ThreadLocalMap,key是弱引用,用完要手动remove否则value泄漏)。
- CompletableFuture的使用(异步编排多个任务,thenApply、thenCompose、allOf)。
剩下的就是消息队列、Linux、设计模式这些。
- Kafka的基本原理——分区和副本机制、消费者组的负载均衡、消息的顺序性保证。
- Elasticsearch的倒排索引原理。
- 设计模式——工厂模式、策略模式、观察者模式各自解决什么问题,能举出在你项目中的应用场景。
再说AI Agent
其实就是我在PaiCLI、派聪明RAG、PaiAgent、PaiFlow、JobClaw中给出的面试题。
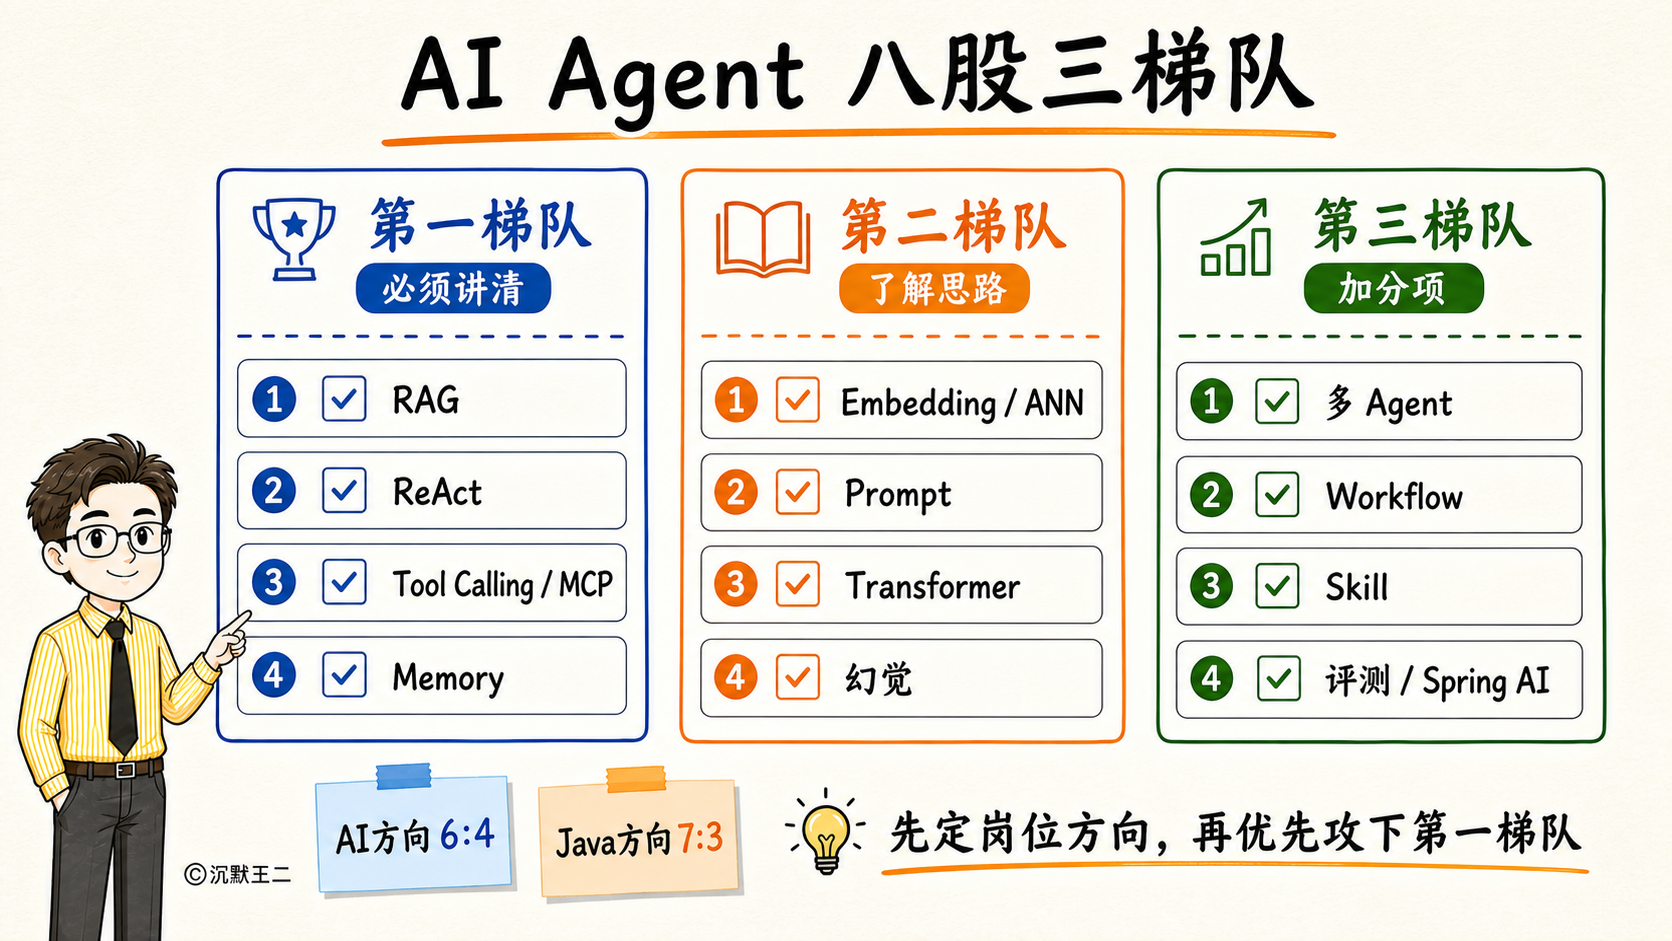
第一梯队:投AI方向必须能流利讲清楚的。
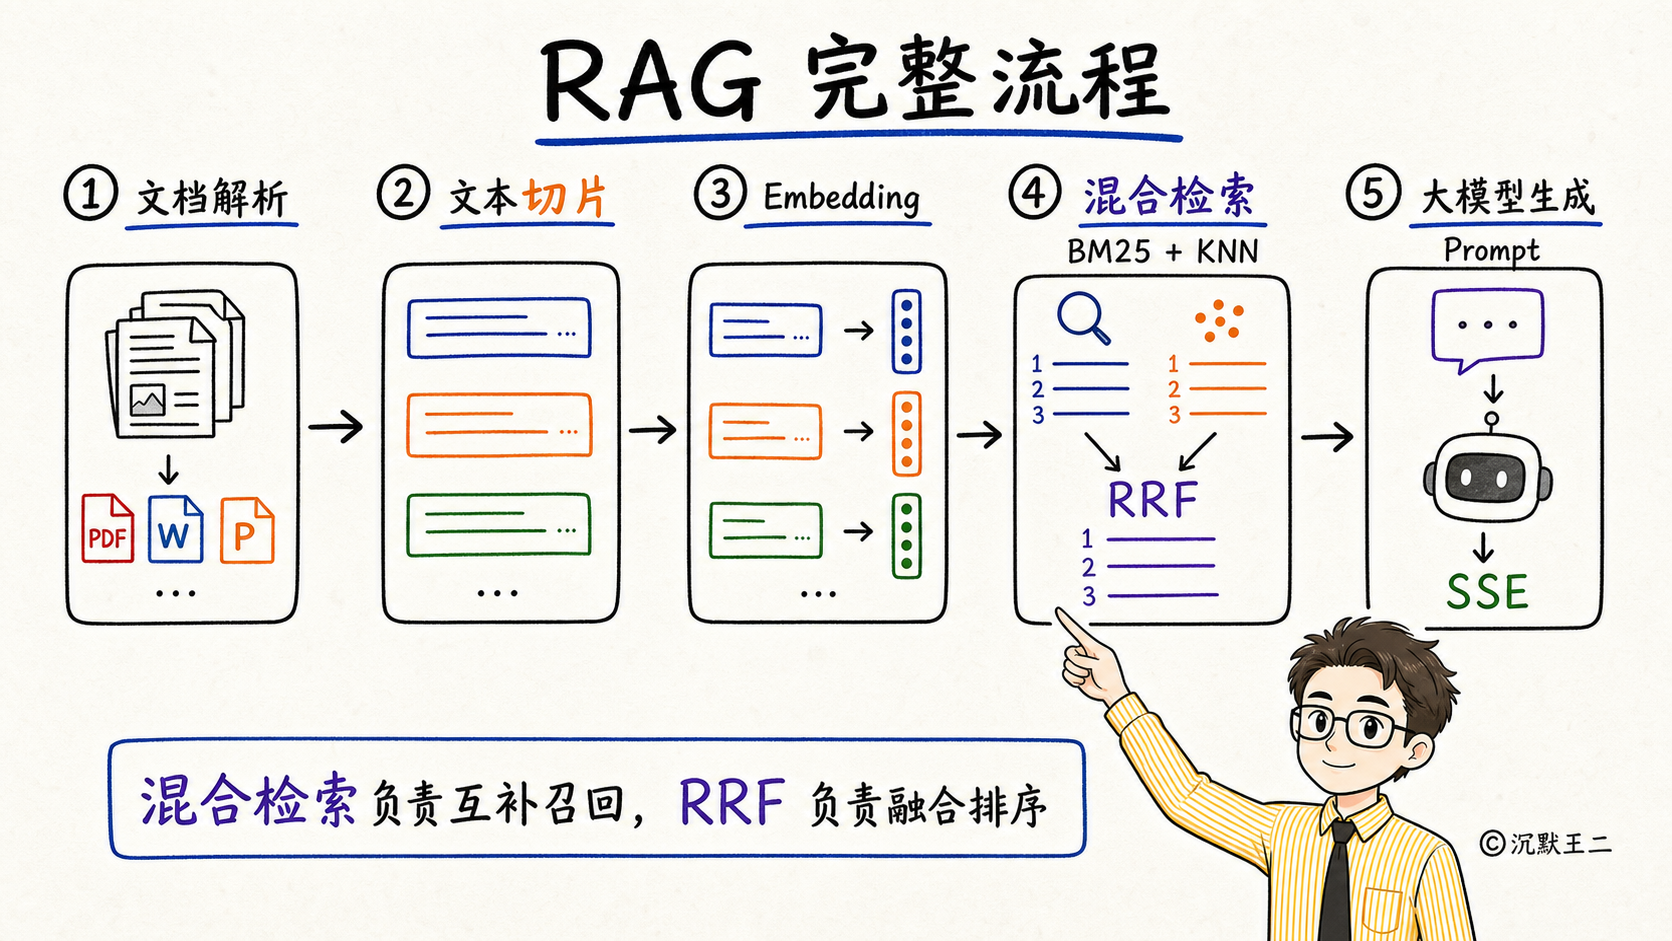
RAG的完整流程。
- 文档解析——Apache Tika怎么处理不同格式的文档。
- 文本切片——固定长度切片、按段落切片、按语义切片各自的优缺点,Overlap为什么要设置成20%到30%(保证上下文连贯性防止语义被截断)。
- Embedding向量化——文本怎么变成固定维度的向量、为什么语义相似的文本向量距离近。
- 混合检索——为什么不用纯向量检索(会漏掉精确匹配的结果比如产品编号、专有名词),BM25关键词检索加KNN向量检索互补,RRF融合排序把两路结果合并(RRF对不同量纲的分数有归一化效果更公平)。
- 大模型生成——检索到的文档片段怎么组装成Prompt喂给大模型、流式输出SSE怎么实现。
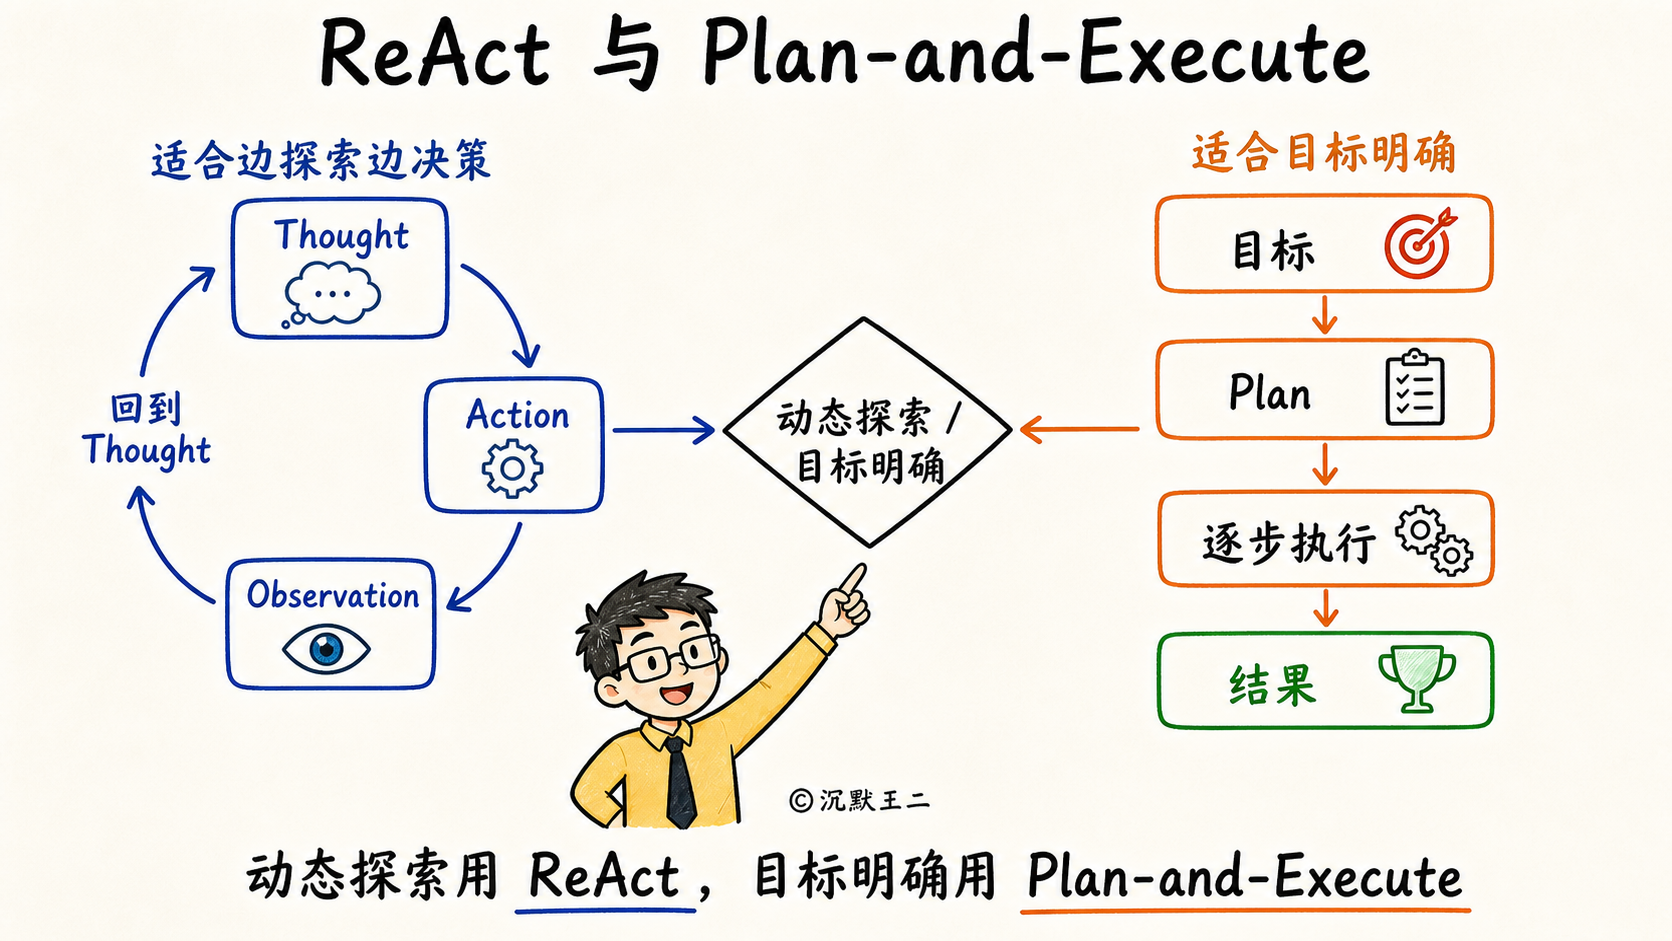
Agent核心推理模式。
- ReAct是什么——Agent交替进行推理(Thought)和行动(Action),每一步基于上一步的观察(Observation)决定下一步。
- 举个例子——用户输入联网搜一下沉默王二是谁,Agent先推理判断应该调用web-search工具去搜索,拿到搜索结果之后分析是否满足用户需求,如果搜不到再降级调起Chrome Devtools MCP去浏览器里直接查。这个例子既展示了工具选择又展示了降级策略和MCP的实际用途。
- Plan-and-Execute模式——先规划所有步骤再逐步执行,适合目标明确步骤可预判的任务。两种模式的适用场景对比你要能讲清楚。
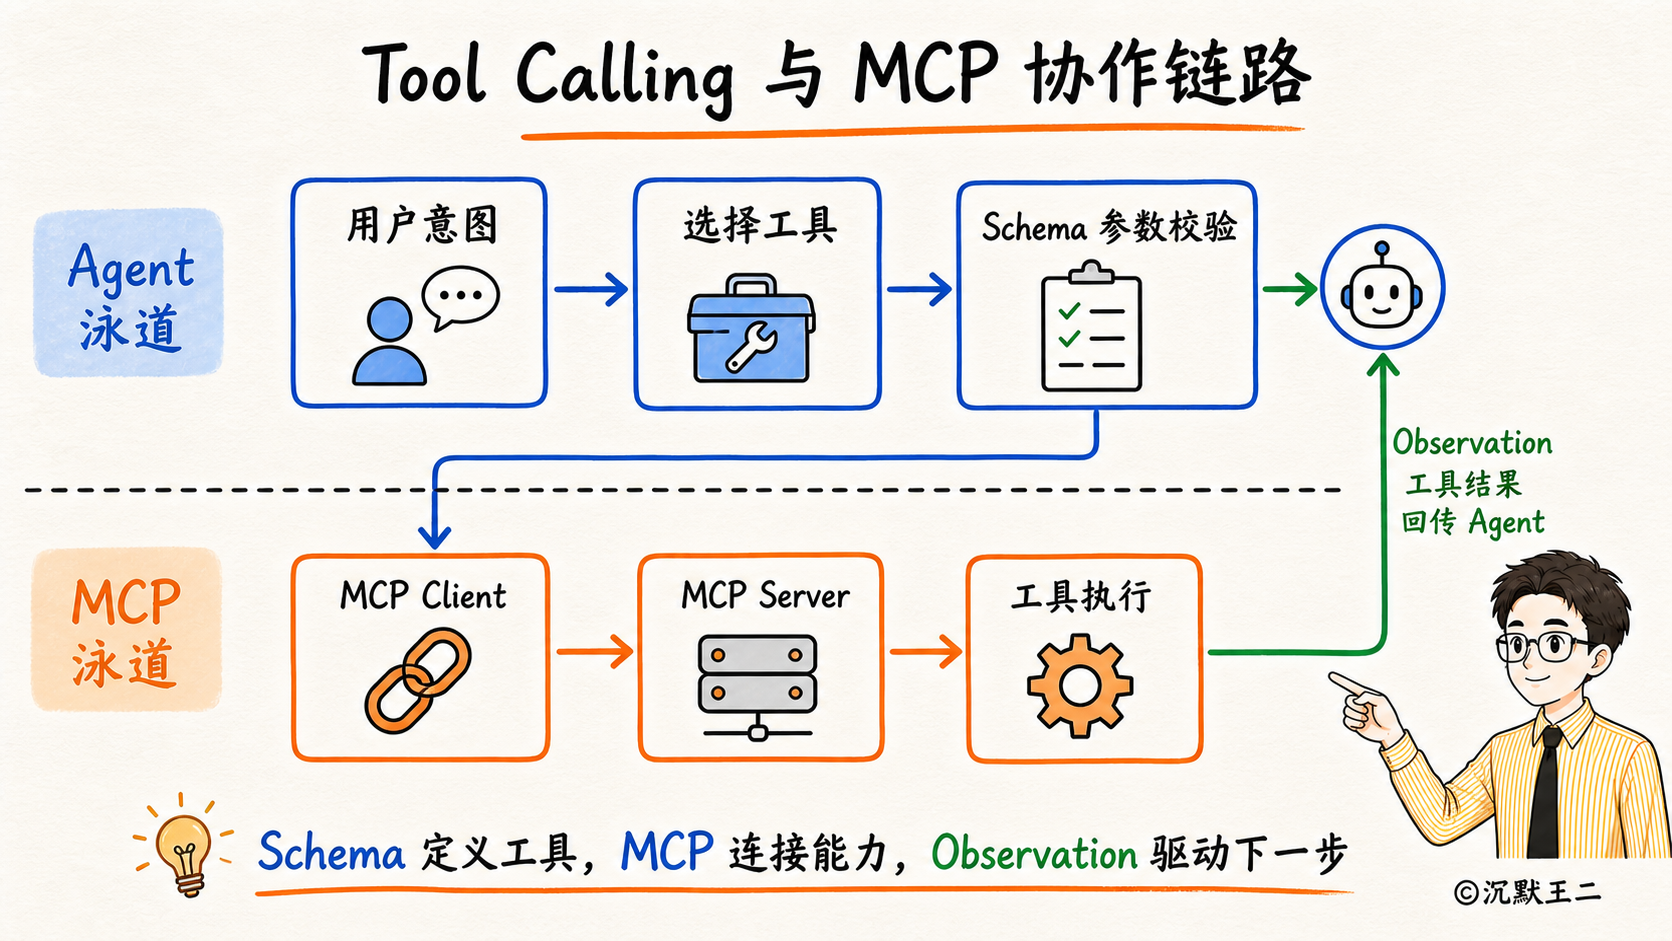
Tool Calling机制。
- 大模型怎么知道有哪些工具可用——Tool的Schema定义(名称、描述、参数类型和约束)。
- 大模型怎么决定调哪个工具——基于用户意图和Tool描述的语义匹配。
- 工具调用的参数怎么校验——类型检查、必填字段、取值范围。
- 工具返回结果怎么传回大模型继续推理——把工具的输出作为Observation注入到上下文中。
MCP协议。
- MCP是什么——标准化AI工具接入的协议,定义了Tool Server和Tool Client之间的通信规范。
- MCP跟直接的Function Calling有什么区别——Function Calling是把工具定义写死在Prompt里,MCP支持工具的动态发现和跨平台复用。
- MCP Server和MCP Client的角色——Server提供工具能力,Client(Agent)发现和调用Server提供的工具。
Memory管理。
- 短期记忆——当前对话的上下文怎么管理。
- 上下文窗口满了怎么办——滑动窗口(保留最近N轮丢弃更早的)、摘要压缩(用大模型把早期对话压缩成摘要)、关键信息提取(只保留实体和关键决策)。
- 长期记忆——跨会话的用户画像和历史信息怎么存储(向量数据库)、怎么检索(语义检索相关的历史记忆注入上下文)、怎么更新(新旧记忆冲突时时间优先原则)。
第二梯队:需要了解能讲出思路的。
Embedding和向量检索原理。
-
Embedding模型的作用——把文本映射到高维向量空间让语义相似的文本距离近。
-
ANN近似最近邻的基本思想——精确的最近邻检索太慢,ANN用牺牲少量精度换取大幅提速。
-
HNSW索引的基本原理——分层的图结构,先在高层快速定位大致区域再在底层精确搜索。
Prompt工程。
-
System Prompt和User Prompt的区别和设计技巧。
-
Few-shot——在Prompt中给示例让模型理解期望的输出格式。
-
Chain of Thought——引导模型分步推理提高复杂问题的准确率。
-
Prompt注入的防范——用户可能在输入中嵌入恶意指令怎么防。
大模型基础原理。
-
Transformer的自注意力机制——不需要推公式但要能讲清楚它在做什么(每个词跟所有其他词算相关性然后加权求和让模型理解上下文关系)。
-
Token和Tokenizer——文本怎么变成模型能处理的数字。
-
预训练加SFT加RLHF三个阶段各自做什么。
-
Temperature和Top-P参数怎么影响输出的确定性和创造性。
幻觉。
- 大模型为什么会编造信息——模型的本质是概率预测不是事实检索。
- 缓解方式——RAG提供事实依据、Prompt约束只基于给定信息回答、后处理校验输出中的实体是否有来源、Temperature调低减少随机性。
第三梯队:加分项。
多Agent协作。
- 多个Agent之间怎么分工(Orchestrator模式——一个主Agent协调多个子Agent)、怎么通信(共享上下文或消息传递)、什么场景需要多Agent什么场景单Agent就够(任务可分解且子任务之间相对独立时用多Agent)。
工作流编排。
- DSL怎么定义工作流、节点执行器怎么解耦、变量怎么在节点间传递。
- Agent和Workflow的区别——Workflow的路由是开发者预定义的,Agent的路由是大模型动态决策的。
Skill的渐进式披露。
- 为什么不一次加载所有Skill——Token消耗大、模型选择准确率下降、Prompt Cache命中率低。
- 三层加载——内置Skill(基础能力)、用户级Skill(全局自定义)、项目级Skill(项目特定)。
Agent评测。
- 五个评测维度——任务完成率、工具调用准确率、推理质量、鲁棒性、效率和成本。
- 打分方法——确定性指标程序化校验、主观指标LLM-as-Judge、抽样人工复核。
Spring AI。
Java生态的AI集成框架,核心价值是让Java开发者能无缝地在Spring Boot项目中集成大模型调用、Prompt管理和工具调用。
还有LangGraph4J。
如果你投的是AI应用开发方向,AI八股和Java八股的时间分配大概是六比四;如果你投的是传统Java后端方向,Java八股和AI八股的时间分配大概是七比三。
当然了,最终还是要看面试官。
加入星球,就可以获取9大实战项目+4个付费专栏+简历修改+1V1指导,感兴趣的小伙伴可以扫下面这张 30元优惠券(仅需139元,秋招前最后一波优惠,JobClaw上架后会涨价到179元,毕竟我们星球也 13000+人了)。
星球项目和专栏介绍:https://paicoding.com/ai-agent-projects-guide
- 求职派(SpringAI+LangGraph4J+MCP,OpenClaw 架构,多Agent 协作)
- 类似Claude Code的PaiCLI Agent(教程已完结,分Java/Python/TypeScript/Go四个版本)
- 企业级工作流编排项目PaiFlow(类似扣子和dify)
- PaiAgent(Vibe Coding 项目,PaiFlow的前身)
- 派聪明RAG AI知识库Java版本+Go版本(这个项目在2025年7月底上架,26届秋招可以说是赢麻了,帮助大量的球友拿到满意的offer,27届日常实习+暑期实习+秋招同样抗打,因为沉淀了更多球友分享的面经+踩过的坑)
- 派简历(计划2026年更新完毕,方便大家撰写简历,比市面上的都会更好用)
- Spring Boot+React 前后端分离 web 项目技术派
- 微服务pmhub
- 轮子mydb 教程
- 入门编程喵等
需要半价续费的球友可以扫下面这张额外的10元补贴优惠券,相当于 169/2-10=74.5元。
冲。