


RAG基础概念
- 引言1.1.1. RAG 是怎么干活的?可以把传统的大模型想象成一个闭卷考生—— 他靠记忆答题,知识固定在训练时。 而 RAG 则让他带上一本参考书: 在回答前,先去知识库中检索信息,再基于这些内容生成答案对比维度
引言
RAG 是怎么干活的?
可以把传统的大模型想象成一个闭卷考生—— 他靠记忆答题,知识固定在训练时。 而 RAG 则让他带上一本参考书: 在回答前,先去知识库中检索信息,再基于这些内容生成答案
| 对比维度 | 传统大模型 | 启用 RAG |
|---|---|---|
| 知识来源 | 训练语料(静态) | 外部知识库(动态) |
| 更新方式 | 重新训练 | 更新文档即可 |
| 回答逻辑 | 依靠记忆猜测 | 依托检索事实 |
| 是否可追溯 | 否 | 是,可附来源 |
RAG 的过程 : 把问题转成语义向量;512
- 在知识库中检索最相关的文档片段;
- 将这些片段拼进提示词(Prompt);
- 模型基于这些真实资料生成答案。 这就是网上传播很广泛的 7 个RAG架构(会在后面分七次文章讲解)
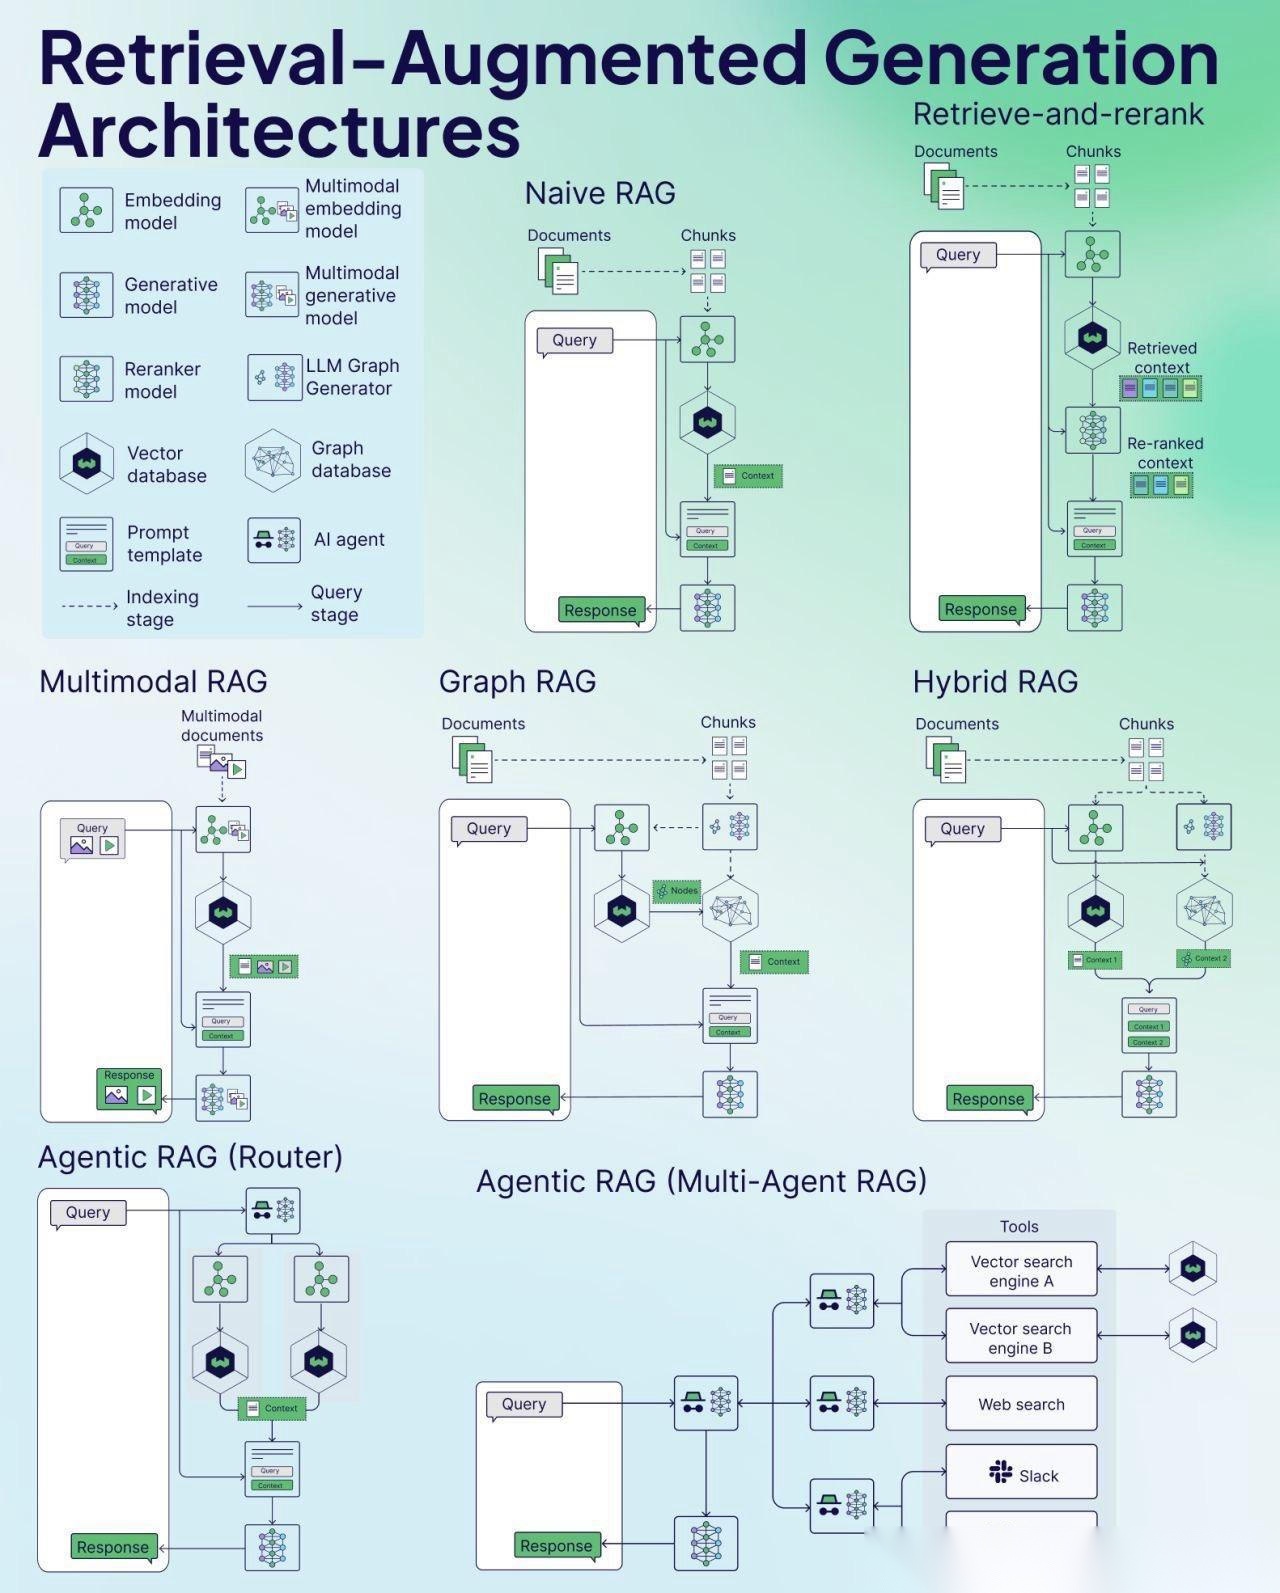 dac864a8fc734ceea42024925cb54b40a482249b21414840a0179a849e252e26.jpg
RAG架构
完整的RAG应用流程主要包含两个阶段:
- 数据准备阶段:数据提取——>文本分割——>向量化(embedding)——>数据入库
- 应用阶段:用户提问——>数据检索(召回)——>注入Prompt——>LLM生成答案
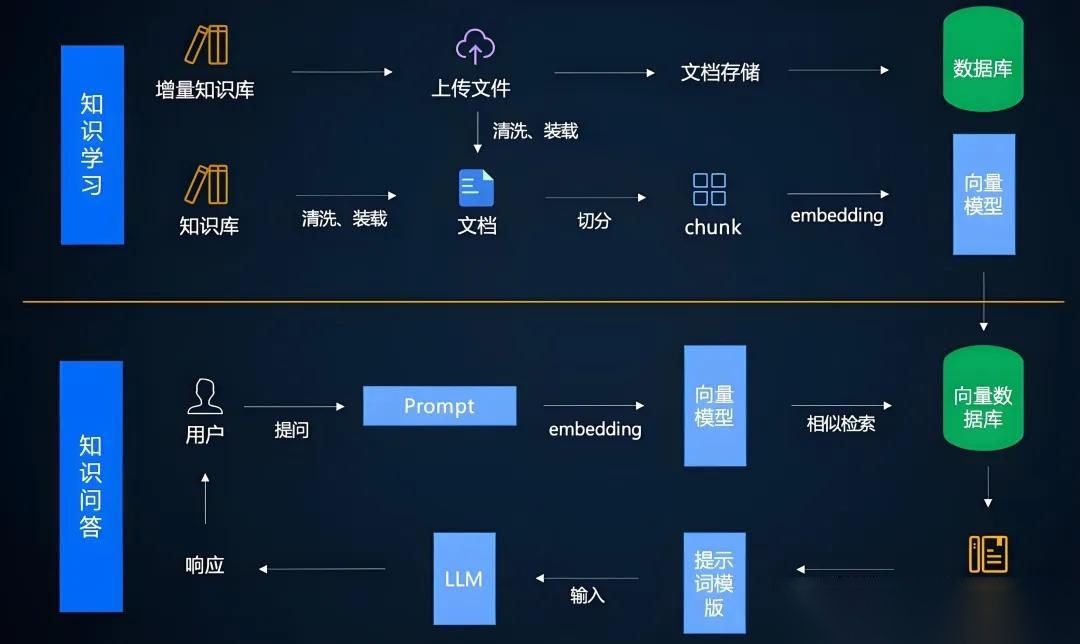 v2-d8f08a6b55391b3f9e5a8347e56c8456_1440w.jpg
数据准备阶段
数据准备一般是一个离线的过程,主要是将私域数据向量化后构建索引并存入数据库的过程。主要包括:数据提取、文本分割、向量化、数据入库等环节。
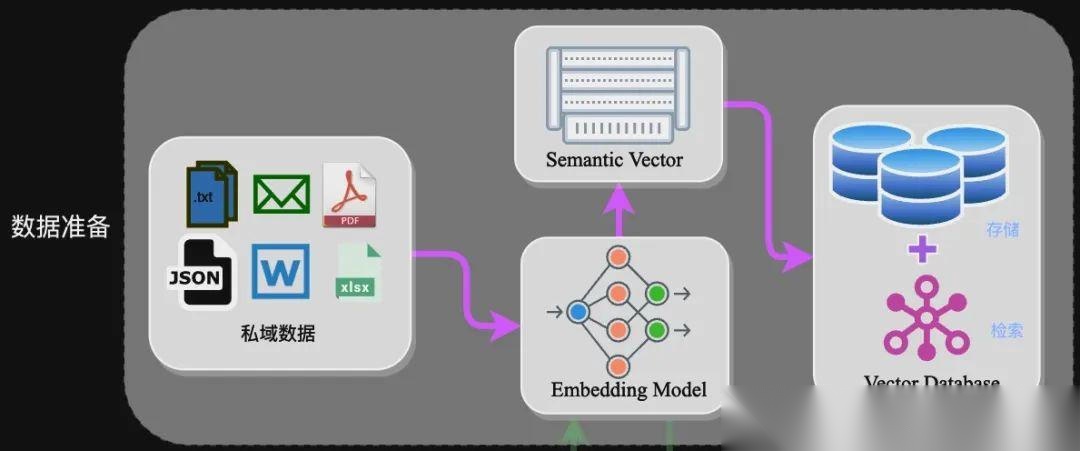 69a38e5b50d2966cd1562c35ece8ced6.jpg
数据准备:
- 数据提取
- 数据加载:包括多格式数据加载、不同数据源获取等,根据数据自身情况,将数据处理为同一个范式。
- 数据处理:包括数据过滤、压缩、格式化等。
- 元数据获取:提取数据中关键信息,例如文件名、Title、时间等 。
文本分割:
文本分割主要考虑两个因素:1)embedding模型的Tokens限制情况;2)语义完整性对整体的检索效果的影响。一些常见的文本分割方式如下:
- 句分割:以”句”的粒度进行切分,保留一个句子的完整语义。常见切分符包括:句号、感叹号、问号、换行符等。
- 固定长度分割:根据embedding模型的token长度限制,将文本分割为固定长度(例如256/512个tokens),这种切分方式会损失很多语义信息,一般通过在头尾增加一定冗余量来缓解。
- 段落
- llm拆分文本分割策略 策略一:递归字符分割 (Recursive Character Splitting) —— 通用首选
这是 LangChain 默认且最推荐的分割器 (RecursiveCharacterTextSplitter)。
- 原理:它不是傻傻地按字数切,而是有一个优先级列表。
- 先尝试按
\n\n(段落) 切。 - 如果切完还太大,就尝试按
\n(换行) 切。 - 还大?按
.(句号) 切。 - 最后才按字符切。
- 优点:它极力保证了段落和句子的完整性,语义最连贯。
- 适用:Word、TXT、PDF 提取后的纯文本。
- 策略二:按结构分割 (Structural Splitting) —— Markdown/代码神器
如果你的原始文档格式很好(比如 Markdown 或 代码),千万不要当成纯文本处理。
- Markdown Header Splitter:
- 原理:根据
# 标题1,## 标题2进行层级分割。 - 神来之笔:它会将标题作为元数据(Metadata) 附带在每一个切片里。
- 例子:
- 切片内容:
“部署命令是 docker-compose up” - 元数据:
{Header: "第三章:部署指南", SubHeader: "Linux环境"} - 效果:当 LLM 检索到这段话时,它知道这是属于“Linux部署”的,而不是“Windows部署”的,上下文极强。
- 策略三:Small-to-Big (父子索引) —— 进阶大招
这是目前提升 RAG 效果最有效的手段之一(LlamaIndex 中叫(LlamaIndex 中叫 ** (LlamaIndex 中叫 **ParentDocumentRetriever)。
- 痛点:
- 切片太小:含有语义信息少,LLM 看不懂上下文。
- 切片太大:包含了太多噪音,向量检索不准(因为向量是取平均值的)。
- 解决方案:“存大找小”。
- 切两刀:
- 小切片 (Child Chunk):比如 128 Token。用来做 Embedding 和检索。
- 大切片 (Parent Chunk):比如 1024 Token (包含那个小切片)。
- 检索时:用“小切片”去匹配用户的 Query(因为小切片语义聚焦,匹配最准)。
- 给 LLM 时:找到小切片后,把它的“父切片”(整段话) 扔给 LLM。
- 效果:检索极其精准,同时 LLM 获得的上下文非常丰富。
向量化(embedding):
向量化是一个将文本数据转化为向量矩阵的过程,该过程会直接影响到后续检索的效果。目前常见的embedding模型如表中所示,这些embedding模型基本能满足大部分需求,但对于特殊场景(例如涉及一些罕见专有词或字等)或者想进一步优化效果,则可以选择开源Embedding模型微调或直接训练适合自己场景的Embedding模型。
模型名称 描述 获取地址
- ChatGPT-Embedding ChatGPT-Embedding由OpenAI公司提供,以接口形式调用。 https://platform.openai.com/docs/guides/embeddings/what-are-embeddings
- ERNIE-Embedding V1 ERNIE-Embedding V1由百度公司提供,依赖于文心大模型能力,以接口形式调用。 https://cloud.baidu.com/doc/WENXINWORKSHOP/s/alj562vvu
- M3E M3E是一款功能强大的开源Embedding模型,包含m3e-small、m3e-base、m3e-large等多个版本,支持微调和本地部署。 https://huggingface.co/moka-ai/m3e-base
- BGE BGE由北京智源人工智能研究院发布,同样是一款功能强大的开源Embedding模型,包含了支持中文和英文的多个版本,同样支持微调和本地部署。 https://huggingface.co/BAAI/bge-base-en-v1.5 几个Embedded模型的对比
A. BGE 系列 (BAAI General Embedding) —— 目前的中文首选
- 出品方:北京智源人工智能研究院。
- 说法/特点:
- BGE-M3 (最新版):这是目前最推荐的“六边形战士”。
- 多语种:支持 100+ 语言。
- 长文本:支持最大 8192 token 的输入(OpenAI 只有 8191,大多数旧模型只有 512)。这意味着你可以把更长的文档切片塞进去,不用切得太碎。
- 多功能:支持稠密检索(Dense,常规向量)、稀疏检索(Sparse,类似关键词权重)、多重向量(ColBERT)。
- BGE-large-zh-v1.5:专注于中文,体积适中,效果极好,常霸榜 MTEB 中文榜首。
- 适用:绝大多数中文 RAG 项目的默认首选。
B. M3E 系列 (Moka Massive Mixed Embedding) —— 中文优化的老将
- 出品方:Moka AI(开源社区)。
- 说法/特点:
- 名字里的 3个E 代表:Massive(海量)、Mixed(混合)、Embedding。
- 它使用了海量的中文指令微调数据集。
- 实战评价:在一些垂直领域(如医疗、法律、金融文档),M3E 的表现有时候比 BGE 还要稳,因为它训练的数据集非常杂非常广。
- 适用:如果发现 BGE 在你的特定业务数据上效果不好,换 M3E 试试,常有惊喜。
C. OpenAI (text-embedding-3-small/large) —— 基准线
- 出品方:OpenAI。
- 说法/特点:
- 优点:极其稳定,支持 8k 长度,不需要自己维护显卡。
- 缺点:中文检索能力不如 BGE/M3E。这是公认的事实。OpenAI 的模型虽然多语言都行,但在中文成语、专业术语的语义匹配上,打不过专门针对中文优化的国产模型。
- 最大硬伤:数据出境风险(如上一条回答所述)。
- 适用:全英文文档库,或者完全没有运维能力的团队。
D. Jina Embeddings (jina-embeddings-v2)
- 出品方:Jina AI。
- 说法/特点:
- 它是全球第一个支持 8K 长度 的开源模型(比 BGE-M3 早)。
- 在处理长文本(如整篇论文、合同)时表现出色。
- 适用:你的文档切片非常长,且不想切碎。
3. 选型避坑指南 (实际经验)
坑1:切片长度 (Sequence Length)
- 老模型限制:很多早期的模型(如 BERT, text2vec-base-chinese)只能处理 512 个 Token(约 300-400 个汉字)。
- 后果:如果你的文档切片是 800 字,后面的内容直接被模型截断丢弃了,根本搜索不到。
- 建议:务必选择支持 512 以上长度的模型。BGE-M3 和 OpenAI 都支持 8192,完全够用。
坑2:指令前缀 (Instruction Prefix)
- 说法:有些模型(如 BGE)在生成向量时,需要加一个特定的前缀字符串。
- 查询时:
"为这个句子生成表示以用于检索相关文章:"+ 用户问题。 - 入库时:不需要前缀。
- 后果:如果你代码里忘了加这个前缀,检索效果会断崖式下跌。
- 建议:仔细阅读 HuggingFace 模型页面的 Usage 说明。
坑3:维度大小 (Dimension)
- 说法:维度越高,存储越贵,检索越慢,但理论上信息量越大。
- OpenAI: 1536 维 或 3072 维。
- BGE-large: 1024 维。
- M3E-base: 768 维。
- 建议:对于百万级以下的数据量,768 维(base 版本)性价比最高,速度和精度的平衡点。不要盲目追求大维度。
总结推荐
- 无脑首选:BGE-M3(或者是
bge-large-zh-v1.5)。 - 理由:中文最强,支持长文本,功能全,开源免费。
- 备选方案:M3E-base。
- 理由:老牌稳定,特定领域可能更准,部署更轻量。
- 不要选:早期的
text2vec系列(过时了),或者 OpenAI 的text-embedding-ada-002(性价比低,效果一般)
数据入库:
数据向量化后构建索引,并写入数据库的过程可以概述为数据入库过程,适用于RAG场景的数据库包括:FAISS、Chromadb、ES、milvus等。一般可以根据业务场景、硬件、性能需求等多因素综合考虑,选择合适的数据库。
应用阶段
在应用阶段,我们根据用户的提问,通过高效的检索方法,召回与提问最相关的知识,并融入Prompt;大模型参考当前提问和相关知识,生成相应的答案。关键环节包括:数据检索、注入Prompt等。
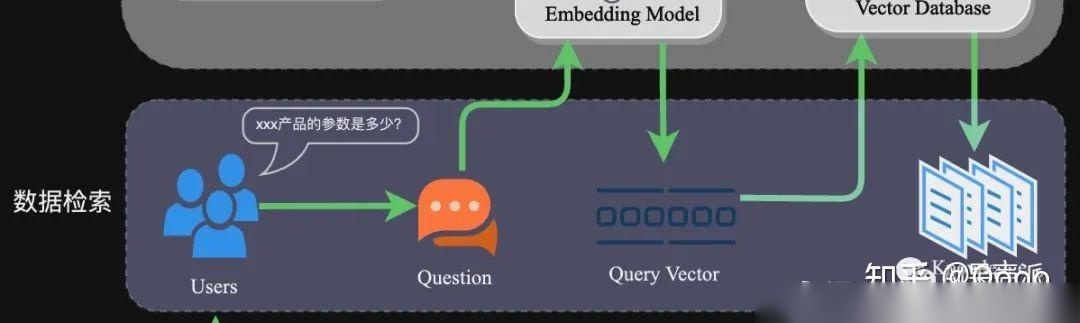 787e68eacebf1af85674d0bfe8551ece.jpg
数据检索
常见的数据检索方法包括:相似性检索、全文检索等,根据检索效果,一般可以选择多种检索方式融合,提升召回率。
- 相似性检索:即计算查询向量与所有存储向量的相似性得分,返回得分高的记录。常见的相似性计算方法包括:余弦相似性、欧氏距离、曼哈顿距离等。
- 全文检索:全文检索是一种比较经典的检索方式,在数据存入时,通过关键词构建倒排索引;在检索时,通过关键词进行全文检索,找到对应的记录。检索策略
- 相似性检索 (Vector Similarity Search)
这是 RAG 与传统搜索引擎最大的区别,也是让知识库具备“语义理解”能力的根本。
- 原理:不再匹配字面上的词,而是匹配意思。
- 用户搜:“我想退货”。
- 文档里:“消费者享有7天无理由售后服务”。
- 结果:传统检索(关键词)完全匹配不上,但相似性检索能匹配上,因为这两个句子的向量在多维空间里靠得很近。
- 距离算法选择:
- 余弦相似度 (Cosine Similarity):RAG 领域的绝对主流。它衡量的是两个向量方向是否一致,对文本长度不敏感。
- 欧氏距离 (L2):衡量两点间的直线距离。通常用于图像检索,文本用得少。
- 内积 (IP, Inner Product):如果你已经把向量做了归一化(Normalized),内积计算最快,效果等同于余弦相似度。
- 工程陷阱:
- 语义漂移:有时候“苹果公司”和“苹果手机”很近,但“苹果水果”也很近。纯向量检索容易被看起来相关但逻辑无关的词带偏。
2. 全文检索 (Full-Text Search / Keyword Search)
这是老派技术(如 ElasticSearch, Lucene),但在 RAG 时代依然不可或缺。
- 原理:基于倒排索引 (Inverted Index)。
- 它把文章拆成词(Token),建立“词 -> 文章ID”的索引。
- 用户搜:“错误码 5003”。
- 文档里:“...遇到 5003 报错...”。
- 结果:精准命中。
- 为什么 RAG 还需要它?
- 专有名词/精确匹配:向量检索对于数字、型号、人名、缩写非常不敏感(因为这些词在语义空间里很难定位)。比如搜“合同号 2023-A-01”,向量检索可能给你找来一堆“2023年的合同”,但不一定是 A-01。此时必须靠全文检索。
- 融合策略:混合检索 (Hybrid Search)
- 这是目前最高级的玩法:
- 同时并行跑两路检索:一路向量(查语义),一路全文(查关键词)。
- 通过 RRF (Reciprocal Rank Fusion) 算法把两路结果合并、去重、排序。
- 结果:既懂语义,又能精确匹配关键词。
- BM25
- 图检索
提示词工程
在 RAG 场景下,提示词工程的目标只有一个:强迫 LLM “忘记”它自带的训练知识,完全依赖你喂给它的“上下文”来回答问题(Grounding)。
标准 RAG 提示词架构:
一个优秀的 RAG Prompt 通常包含以下 4 个部分,顺序很重要:
- 角色设定 (Role):告诉 LLM 它是谁(专业的知识库助手)。
- 任务指令 (Instruction):核心规则(比如“只根据上下文回答”、“不要编造”)。
- 上下文数据 (Context):这是你检索到的那几段文字,通常用特殊符号包裹。
- 用户问题 (Query):用户真正问的内容。 📝 标准模版代码 (可以直接拿去用)
MarkDown

# Role
你是一个专业的企业知识库助手。你的任务是根据提供的【参考文档】回答用户的问题。

# Rules (关键!防幻觉指令)
1. 必须**仅依赖**下方的【参考文档】进行回答,不要使用你内部的训练知识。
2. 如果【参考文档】中没有包含回答问题所需的信息,请直接回答:“知识库中未找到相关信息”,**严禁编造**。
3. 回答需要逻辑清晰,分点表述。
4. 如果可能,请在回答的末尾注明引用的文档名称。

# Context (检索到的片段)
以下是参考文档片段:

{context_str}

# User Question
用户的问题是:
{query_str}

# Answer
请开始回答:
LLM生成
【任务描述】
假如你是一个专业的客服机器人,请参考【背景知识】,回
【背景知识】
{content} // 数据检索得到的相关文本
【问题】
石头扫地机器人P10的续航时间是多久?
Prompt作为大模型的直接输入,是影响模型输出准确率的关键因素之一。在RAG场景中,Prompt一般包括任务描述、背景知识(检索得到)、任务指令(一般是用户提问)等,根据任务场景和大模型性能,也可以在Prompt中适当加入其他指令优化大模型的输出。一个简单知识问答场景的Prompt如上所示:
总结:RAG 不是模型工程,而是系统工程
从整体流程来看,RAG 并不是“给大模型接个数据库”这么简单,而是一套完整的信息检索与生成协同系统。Embedding 模型决定你“能不能找对东西”,检索策略决定你“会不会漏掉关键事实”,Prompt 工程决定模型“敢不敢胡说”,而最终的生成效果,往往是这些环节共同作用的结果。
在真实业务中,RAG 的性能瓶颈很少出现在大模型本身,更多出现在数据准备是否合理、切片是否科学、检索是否稳定、Prompt 是否约束到位。一旦其中某一环失控,模型再强,也只能在错误上下文里一本正经地胡说八道。
因此,一个可靠的 RAG 系统,核心目标只有三个: 检索要准、上下文要真、模型要被约束。
只要这三点成立,模型规模反而不是最重要的变量。
后续如果继续展开,可以分别从 分块策略优化、召回与重排序、多路检索融合、幻觉评估与监控 等角度,进一步把 RAG 从“能跑”推进到“能上线、能长期用”。
RAG 的难点,从来不在概念,而在细节。