


PaddleOCR入门教程
前言
遇到了一个非常实际的问题:每天有大量的扫描件、PDF、图片需要转换成可编辑的文本,人工录入效率太低,外包标注成本又太高。
我第一个推荐的就是PaddleOCR。
说实话,这几年OCR领域发展太快了。
传统方案(比如Tesseract)在中文场景下表现一直不太理想,而商业API又贵又不灵活。
PaddleOCR的出现,几乎以一己之力改变了整个开源OCR的格局——百度出品、完全开源、支持100+语言、精度碾压同类方案。
截至2026年6月,PaddleOCR在GitHub上已获得超过8.22万星标,被Dify、RAGFlow、Cherry Studio等顶级开源项目广泛采用。
就在2026年6月11日,PaddleOCR刚刚发布了v3.7.0版本,带来了全新的PP-OCRv6模型。
今天这篇文章,我就从零开始,把PaddleOCR的安装、使用、原理、Java集成,从头到尾给你拆解一遍。
希望对你会有所帮助。
一、PaddleOCR到底是什么?
1.1 一句话说清
PaddleOCR是百度飞桨(PaddlePaddle)团队开源的OCR工具库,能把图片和PDF里的文字,精准地提取成可编辑的文本或结构化数据。
“OCR”的全称是Optical Character Recognition(光学字符识别),说白了就是让计算机“看懂”图片里的文字。
传统的OCR方案(比如Tesseract)基于传统图像处理算法,对清晰印刷体的识别还行,但一旦遇到复杂背景、倾斜文字、手写体、多语言混合,准确率就直线下降。
而PaddleOCR基于深度学习,能在这些复杂场景下保持极高的识别精度。
1.2 PaddleOCR的核心优势
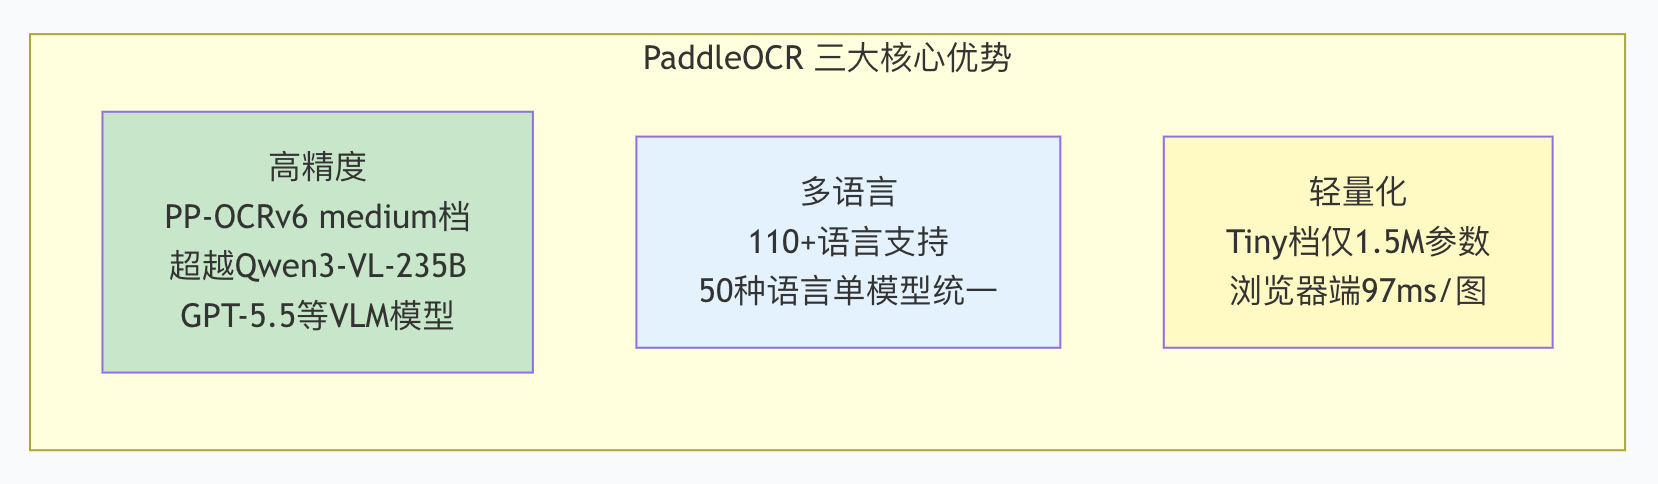
① 高精度:PP-OCRv6_medium以仅34.5M参数,在文本检测和识别精度上超越了Qwen3-VL-235B、GPT-5.5等主流视觉语言大模型。
② 多语言:支持110+种语言识别,PP-OCRv6的medium和small档单模型覆盖50种语言(中文、英文、日文及46种拉丁语系语言),无需为不同语种切换模型。
③ 轻量化:提供Tiny(1.5M)、Small(7.7M)、Medium(34.5M) 三档模型,覆盖从浏览器端到服务器的全算力平台。Tiny档在浏览器端单图预测最快仅需97毫秒。
二、2026年最新版本
PaddleOCR 3.7 + PP-OCRv6。
有些小伙伴可能还在用PaddleOCR 2.x的老版本。
这里提醒一下:PaddleOCR 3.x引入了大量接口变动,2.x的旧代码很可能无法直接运行。
2.1 v3.7.0核心更新(2026年6月11日)
PP-OCRv6是PaddleOCR的第六代OCR模型,带来了多项重磅升级:
升级维度
具体提升
检测精度
medium档相比PP-OCRv5_server提升4.6%
识别精度
medium档相比PP-OCRv5_server提升5.1%
语言覆盖
单模型覆盖50种语言(中英日+46种拉丁语系)
CPU推理
medium档Intel Xeon端到端时延1.40秒,速度达到PP-OCRv5_server的5.2倍
Apple M4
tiny档推理加速6.1倍
A100 GPU
单图推理仅需0.13秒
三档模型全覆盖:
Tiny(1.5M参数) :边缘设备、轻量级本地OCR、延迟敏感场景
Small(7.7M参数) :移动端、桌面端、平衡型OCR服务
Medium(34.5M参数) :精度优先的OCR、服务端流水线、工业OCR
2.2 PaddleOCR-VL-1.6:文档解析新SOTA
除了PP-OCRv6,PaddleOCR还有一条独立的文档解析(VL)产品线。
2026年6月12日,PaddleOCR-VL-1.6正式上线。这是一个0.9B参数的视觉语言模型(VLM) ,专为复杂文档解析设计。
在权威评测榜单OmniDocBench v1.6中,PaddleOCR-VL-1.6在文本、表格、公式、图表四大核心任务上准确率高达96.33%,综合排名全球第一。
它支持111种语言,在古籍、生僻字、印章等场景均有显著提升。
三、技术架构
3.1 三阶段流水线架构
PaddleOCR采用经典的三阶段流水线架构:
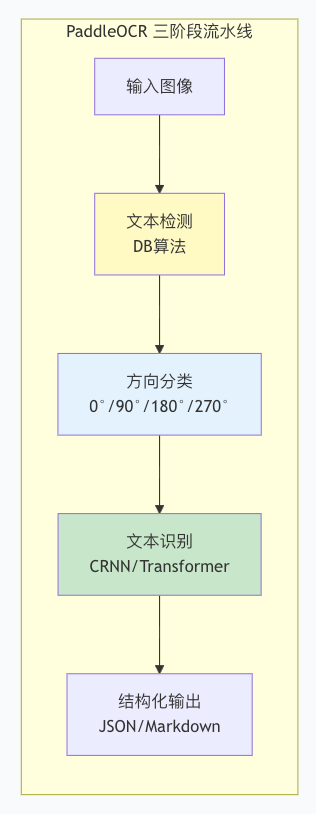
第一阶段:文本检测(Detection)
PaddleOCR采用DB(Differentiable Binarization,可微分二值化)算法。传统方法需要先做语义分割再二值化,两个步骤是分离的。DB算法通过可微分二值化技术,把语义分割和二值化合并成一个可训练的端到端过程。
实验数据显示,在ICDAR2015数据集上,DB算法的F1值达到86.3%,较传统方法提升12%。
PP-OCRv6进一步升级了检测模块,采用RepLKFPN(轻量大核特征金字塔网络) ,专门针对多尺度文本检测设计。
第二阶段:方向分类(Angle Classification)
针对倾斜文本识别问题,PaddleOCR提供0°、90°、180°、270°四方向分类模型。启用方向分类后,垂直文本识别准确率可从68%提升至92%。
第三阶段:文本识别(Recognition)
识别模块采用CRNN(卷积循环神经网络) 架构,结合CNN特征提取与RNN序列建模。
最新版本引入Transformer结构,通过自注意力机制捕捉字符间长距离依赖关系,在中文场景下识别准确率提升至95.7%。
PP-OCRv6在识别模块中采用EncoderWithLightSVTR,将局部上下文建模与全局注意力相结合。
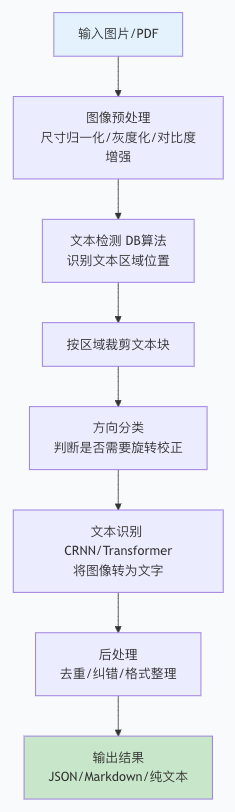
3.2 端到端执行流程图
下面是PaddleOCR从输入图片到输出结构化数据的完整执行流程:
四、安装与快速上手
4.1 环境准备
系统要求:
操作系统:Linux(推荐Ubuntu 20.04)、Windows 10/11、macOS(11+)
Python版本:3.7-3.10
硬件:CPU(推荐4核以上)或GPU(NVIDIA显卡,CUDA 11.x)
4.2 安装PaddlePaddle
PaddleOCR依赖PaddlePaddle深度学习框架:
Bash
# CPU版本
pip install paddlepaddle -i https://mirror.baidu.com/pypi/simple

# GPU版本(需提前安装CUDA/cuDNN)
pip install paddlepaddle-gpu -i https://mirror.baidu.com/pypi/simple
验证安装:
Python
import paddle
paddle.utils.run_check()
# 输出 "PaddlePaddle is installed successfully!" 表示成功
4.3 安装PaddleOCR
Bash
# 安装完整功能
python -m pip install "paddleocr[all]"

# 或使用百度镜像加速
pip install paddleocr -i https://mirror.baidu.com/pypi/simple
关键依赖包括:OpenCV(图像处理)、Shapely(几何计算)、PyMuPDF(PDF解析)。
4.4 快速识别:三行代码
Python
from paddleocr import PaddleOCR

# 1. 初始化OCR引擎
ocr = PaddleOCR(use_angle_cls=True, lang='ch')

# 2. 执行识别
result = ocr.ocr('test.jpg', cls=True)

# 3. 解析结果
for line in result:
    print(f"坐标: {line[0]}, 文本: {line[1][0]}, 置信度: {line[1][1]:.2f}")
参数说明:
use_angle_cls:是否启用文本方向分类(适用于倾斜文本)
lang:语言类型(ch中文、en英文、fr法语、japan日文等)
cls:是否启用方向分类
4.5 完整示例:识别并标注结果
Python
from paddleocr import PaddleOCR, draw_ocr
from PIL import Image

# 初始化
ocr = PaddleOCR(use_angle_cls=True, lang='ch')

# 识别图片
img_path = 'test.jpg'
result = ocr.ocr(img_path, cls=True)

# 可视化
image = Image.open(img_path).convert('RGB')
boxes = [line[0] for line in result[0]]      # 坐标框
txts = [line[1][0] for line in result[0]]    # 识别文本
scores = [line[1][1] for line in result[0]]  # 置信度

im_show = draw_ocr(image, boxes, txts, scores, font_path='simfang.ttf')
im_show = Image.fromarray(im_show)
im_show.save('result.jpg')
五、多语言识别与批量处理
5.1 多语言切换
Python
# 中文识别
ocr_ch = PaddleOCR(lang='ch')

# 英文识别
ocr_en = PaddleOCR(lang='en')

# 日文识别
ocr_jp = PaddleOCR(lang='japan')

# 法语识别
ocr_fr = PaddleOCR(
    det_model_dir='ch_PP-OCRv3_det_infer',
    rec_model_dir='fr_PP-OCRv3_rec_infer',
    cls_model_dir='ch_ppocr_mobile_v2.0_cls_infer',
    lang='fr'
)
5.2 批量处理
Python
# 批量识别
img_list = ['img1.jpg', 'img2.png', 'img3.bmp']
results = ocr.ocr(img_list, batch_size=4)  # GPU下建议batch_size>1
性能优化建议:
图像预处理:统一尺寸(建议640x640)、灰度化
GPU下设置提升吞吐量batch_size>1
启用,在Tesla V100上处理速度可达300FPSuse_gpu=True
六、Java开发者如何集成PaddleOCR?
有些小伙伴可能会问:我是写Java的,PaddleOCR是Python库,怎么用到Java项目里?
确实,PaddleOCR本身是Python生态的工具。但Java开发者有三种主流集成方案可以选择。
6.1 方案一:REST API封装(最推荐)
这是最优雅、最解耦的方案:把PaddleOCR部署为独立的微服务,Java通过HTTP调用。
Python服务端(Flask + PaddleOCR):
Python
from flask import Flask, request, jsonify
from paddleocr import PaddleOCR
import json

app = Flask(__name__)
ocr = PaddleOCR(use_angle_cls=True, lang='ch')

@app.route('/api/ocr', methods=['POST'])
def ocr_api():
    file = request.files['file']
    img_path = file.save('temp.jpg')
    result = ocr.ocr('temp.jpg', cls=True)
    # 解析结果
    data = []
    for line in result[0]:
        data.append({
            'text': line[1][0],
            'confidence': line[1][1],
            'bbox': line[0]
        })
    return jsonify({'code': 200, 'data': data})

if __name__ == '__main__':
    app.run(host='0.0.0.0', port=5000)
Java客户端(Spring Boot + RestTemplate):
Java
@RestController
public class OCRController {

    @PostMapping("/ocr")
    public String recognize(@RequestParam("file") MultipartFile file) {
        RestTemplate restTemplate = new RestTemplate();
        String url = "http://localhost:5000/api/ocr";

        MultiValueMap<String, Object> body = new LinkedMultiValueMap<>();
        body.add("file", new FileSystemResource(file.getOriginalFilename()));

        HttpEntity<MultiValueMap<String, Object>> requestEntity =
            new HttpEntity<>(body, headers);
        ResponseEntity<String> response = restTemplate.postForEntity(
            url, requestEntity, String.class);
        return response.getBody();
    }
}
优势:Java与Python完全解耦,便于横向扩展和独立升级。
6.2 方案二:ONNX Runtime + Java
将PaddleOCR模型导出为ONNX格式,然后通过ONNX Runtime在Java中直接加载推理。
PP-OCRv6支持ONNX Runtime等多种推理后端。
XML
<!-- Maven依赖 -->
<dependency>
    <groupId>com.microsoft.onnxruntime</groupId>
    <artifactId>onnxruntime</artifactId>
    <version>1.17.0</version>
</dependency>
6.3 方案三:DJL(Deep Java Library)
通过DJL(AWS开源的Java深度学习库)调用PaddleOCR模型。
PaddleOCR通过DJL实现Java调用,支持中英文混合识别(精度达97%),提供表格识别、版面分析等高级功能。
6.4 PaddleOCR 3.x 多语言服务调用
PaddleOCR 3.0.2版本已新增C++、Java、Go、C#、Node.js、PHP六种语言的服务调用示例。官方已提供完整的Java调用示例,建议直接参考官方文档。
方案选择建议:
方案
适用场景
难度
REST API
大多数企业级项目
⭐⭐
ONNX Runtime
对延迟有极致要求
⭐⭐⭐⭐
DJL
希望纯Java生态
⭐⭐⭐
七、与其他OCR方案对比
实测数据最能说明问题。在一项针对发票关键信息提取的对比研究中,PaddleOCR以0.958的F1-score排名第一,大幅领先其他方案。
在另一项测试中(NVIDIA Tesla T4 GPU):
OCR方案
中文识别准确率
英文识别准确率
PaddleOCR
92.7%
95.1%
EasyOCR
88.3%
93.2%
Tesseract
76.5%
89.7%
PaddleOCR的优势:
中文场景表现最佳:比Tesseract高出16个百分点
深度学习驱动:对复杂背景、倾斜文本、小字体等场景适应性更强
多语言支持:110+种语言,覆盖范围最广
八、优缺点
优点
1. 精度极高 PP-OCRv6_medium以34.5M参数超越Qwen3-VL-235B、GPT-5.5等主流VLM模型。PaddleOCR-VL-1.6在OmniDocBench上准确率达96.33%,全球第一。
2. 多语言覆盖广 支持110+种语言,PP-OCRv6单模型覆盖50种语言。
3. 轻量化部署 三档模型(1.5M/7.7M/34.5M)覆盖端侧到服务器全场景。Tiny档浏览器端97ms/图,A100上0.13s。
4. 功能全面 不只是文字识别,还支持表格识别、公式识别、版面分析、印章识别等复杂场景。
5. 开源生态活跃 GitHub 82.2K+ Star,被Dify、RAGFlow等顶级项目采用。
6. 国产硬件支持 支持昆仑芯、昇腾等国产硬件。
缺点
1. 依赖Python生态 核心是Python库,Java/.NET等语言需要通过API或ONNX等方式调用。
2. 3.x版本破坏性变更 从2.x升级到3.x有大量接口变动,旧代码无法直接运行。
3. 部署相对复杂 相比Tesseract等传统方案,PaddleOCR需要安装PaddlePaddle深度学习框架,环境配置更复杂。
4. 内存消耗 GPU模式下需要显存(建议4GB+),在资源受限的边缘设备上需要使用Tiny档模型。
5. 冷启动延迟 首次加载模型需要一定时间(约2-5秒),Serverless场景需注意。
九、适用场景
强烈推荐使用的场景
场景
典型应用
推荐理由
文档数字化
扫描件转文字、PDF解析
PaddleOCR-VL支持表格/公式/图表识别
企业文档处理
合同、财报、标书解析
高精度+结构化输出
金融票据识别
发票、回单、支票识别
PaddleOCR在发票信息提取中F1-score达0.958
工业质检
仪表读数、产品标签识别
轻量化模型+边缘部署
古籍数字化
古籍扫描件识别
PaddleOCR-VL在古籍识别场景显著增强
多语言场景
国际化文档处理
110+语言支持
需要评估的场景
场景
原因
极低延迟实时场景
模型加载和推理有一定延迟
资源极度受限设备
需使用Tiny档(1.5M),精度会有所下降
纯Java生态项目
需要通过API/ONNX等方式调用
十、写在最后
回到最初的问题:PaddleOCR到底值不值得用?
答案是肯定的。
PaddleOCR已经不是“能用”的水平了——它正在成为开源OCR的事实标准。
82.2K的GitHub Star、110+种语言支持、96.33%的文档解析准确率、从1.5M到34.5M的三档模型覆盖——这些数字背后,是一整套经过了大规模产业验证的OCR解决方案。
对于企业来说,PaddleOCR意味着:不再需要花大价钱买商业OCR API,不需要忍受Tesseract糟糕的中文识别率,不需要自己从零训练OCR模型。
开箱即用,精度在线,成本可控。
对于Java开发者来说,虽然PaddleOCR核心是Python,但通过REST API、ONNX Runtime、DJL等多种方式,完全可以无缝集成到Java项目中。
更何况,PaddleOCR 3.0.2已经官方提供了Java服务调用示例。
如果你正在做文档处理、票据识别、内容审核、RAG数据准备等任何涉及文字提取的工作,PaddleOCR都值得你花一个下午把它跑起来试试。
开源地址与官方资源:
GitHub:https://github.com/PaddlePaddle/PaddleOCR(82.2K+ Star)
官方文档:https://www.paddleocr.ai/
PP-OCRv6在线Demo:https://huggingface.co/spaces/PaddlePaddle/PP-OCRv6_Online_Demo
PaddleOCR-VL产品页:https://ai.baidu.com/tech/ocr/doc_parser